AI DAILY / 2026-09-15
Richard Socher 谈「AI for AI Research」:让 AI 自动改进 AI
Why you should work on AI for AI Research — Richard Socher of Recursive
全文中文翻译 · AI 生成,仅供学习交流
你为什么应该做"为 AI 而做的 AI",Recursive 的 Richard Socher
里面提到一个 AI 研究系统,不到两天时间就在优化任务(optimization tasks)上击败了人类和他们用的智能体(agent)。他还做了 NVIDIA GPU 内核方面的工作,这个系统没靠一支 CUDA 专家团队,自己就发现了改进方案。Richard 也讲了,为什么他认为现在要几千人、花几年才能搞定的 AI 研究,最终能被压缩到几周。
成果都总结在他那场 20 分钟的 AIE 主旨演讲里。我们也顺便聊了他提出的「智能的十个维度」:
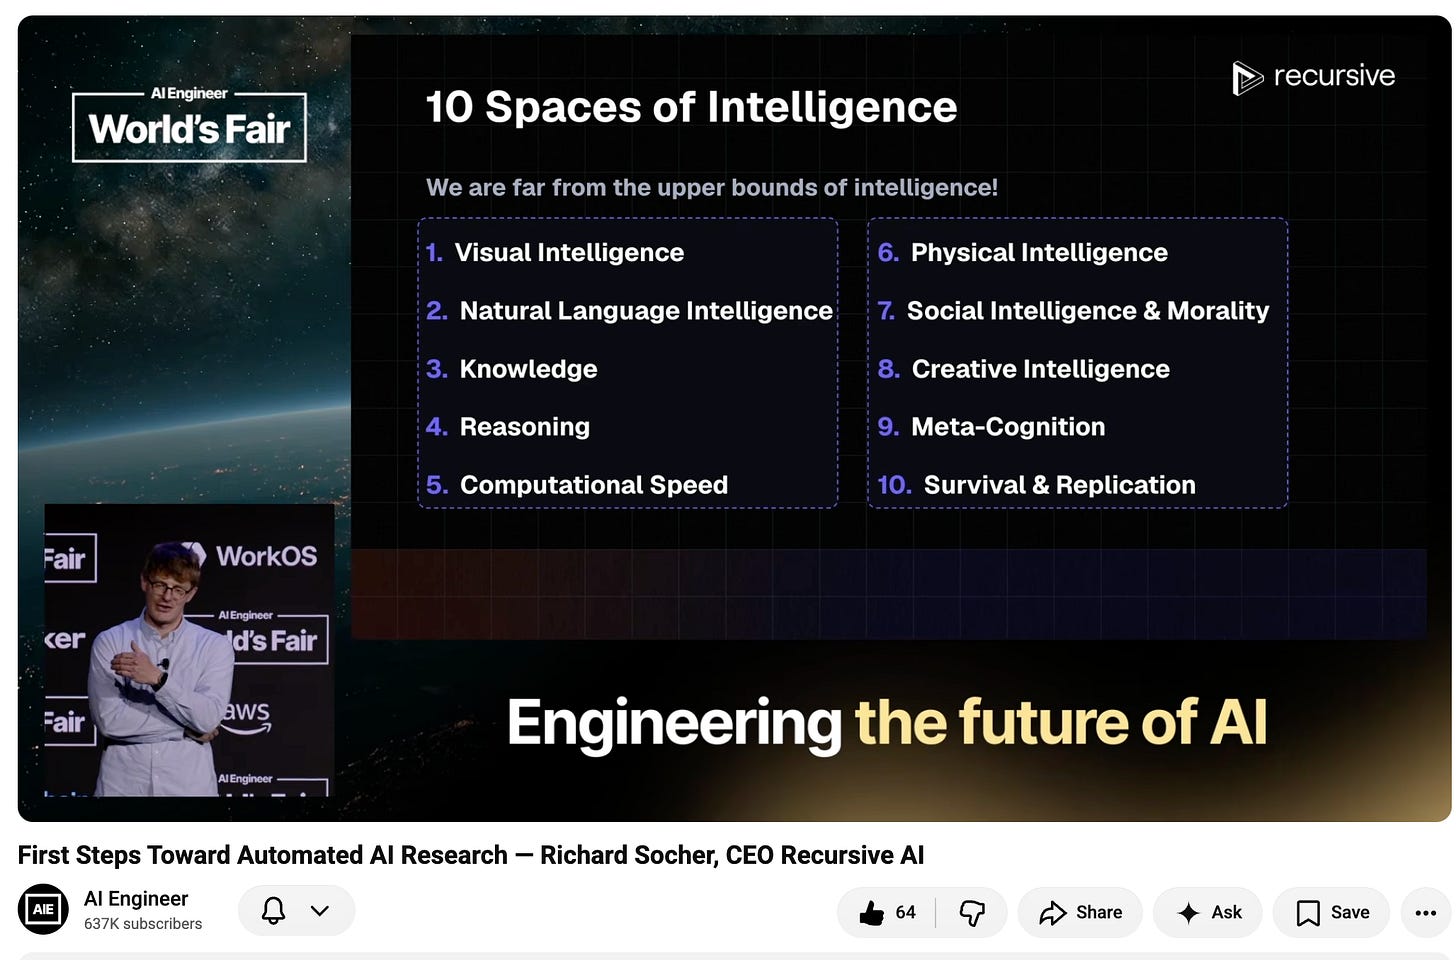
更棘手的话题也都聊到了,比如奖励黑客(reward hacking)、Anthropic 那套「宪法」到底有没有用、AI 该怎么监管、给前沿发展「定节奏」的提案、开源模型算不算地缘政治软实力、今天的 LLM 范式够不够用,以及如果 AI 系统有一天开始自己挑目标会怎样。Richard 还回忆了那些被毙掉的研究是怎么启发 Alec Radford 搞出 GPT 的,聊了开放性(open-endedness)、AI 经济学家(AI Economist)、模拟整个经济体这些方向,还有他用来思考智能上限的那套框架。
我们讨论了:
- 尤里卡机器(Eureka Machine),以及 Richard 对「能自动发明的 AI」的愿景
- 为什么 Richard 对「超级智能(superintelligence)服务科学与技术」这件事乐观
- 为什么「AI 硬起飞(hard takeoff)」情景低估了物理和经济上的约束
- 监管「智能本身」而不是具体 AI 应用,会带来什么风险
- 奖励黑客,以及为什么 AI 越来越聪明,反而让客观函数的设计更难
- Richard 对 Anthropic 宪法和宪法式 AI(constitutional AI)的批评
- 对齐(alignment)和个性化(personalization),以及 AI 应该跟谁的价值走
- 为什么开源 AI 对韧性、竞争和地缘政治软实力都很关键
- 为什么 Richard 离开 You.com 的前沿模型工作,去创办 Recursive
- 递归式自我改进(recursive self-improvement)和 AI 研究流程自动化
- 今天的 LLM 范式够不够用,以及 Richard 为什么对世界模型(world model)不太感冒
- DecaNLP、早期的「基于提示的泛化(prompt-based generalization)」,以及影响 GPT 的那些研究
- 为什么被毙掉的研究也能影响整个技术发展的时间线
- 开放性、演化式思路和彩虹团队(rainbow teaming)
- 如果 AI 系统开始给自己定目标,会发生什么
- 为什么「利润最大化」这种简单的目标,也能搞出危险的奖励黑客
- Recursive 把自我改进的 AI 应用于科学的长期计划
- AI 起飞面对的算力、硬件和经济约束
- Recursive 早期的 NanoChat、NanoGPT 和 GPU 内核优化结果
- 为什么自动化 AI 研究能把几年的活儿压到几周
- 奖励工程(reward engineering)和让自动研究系统真能跑起来的关键
- AI 经济学家,以及用模拟来检验经济政策
- LLM 能不能把人和整个经济体模拟得像模像样
- 基准测试里的 bug、评测框架(evaluation harness)和衡量 AI 进步的难处
- Recursive 短期内聚焦「为 AI 而做的 AI」
- 工具使用(harness)优化、沙箱化(sandboxing)和网页搜索,作为智能体(agent)的核心基建
- You.com 和面向 AI 智能体的搜索技术栈
- AI 在金融、回测(backtesting)和数据泄漏上的应用
- Richard 提出的智能的三大基本组成部分,和十个「空间(spaces)」
- 视觉、沟通、知识、计算的理论上限
- 创造性智能、元认知(metacognition)和 AI 自己生成的目标
- 生存和自我复制,以及为什么 AI 不一定需要怕被关掉
- 强自主性(high agency)、宏大目标,以及 Richard 给「用 AI 做产品的人」的建议时间戳
00:00:00 尤里卡机器与超级智能
00:02:23 对 AI 的乐观、缓慢起飞和监管
00:07:56 AI 安全、奖励黑客和 Anthropic 的宪法
00:11:49 对齐、个性化与开源 AI
00:15:46 Richard 为什么创办 Recursive
00:20:03 递归式自我改进和创始团队
00:22:55 今天的 LLM 够用吗?
00:29:03 DecaNLP、GPT 和那个「超前于时代」的被毙想法
00:34:38 开放性与演化式 AI
00:36:38 AI 选择自己的目标时会发生什么?
00:41:16 用于科学的超级智能
00:42:40 GPU、算力与 AI 起飞的边界
00:45:07 Recursive 的成果,AI 击败人类和他们的智能体
00:49:14 奖励工程与自动研究
00:53:12 AI 经济学家与模拟整个经济体
00:58:07 LLM 模拟、人设(persona)与模式坍缩(mode collapse)
01:03:38 Recursive 的路线图、智能体、搜索与金融
01:09:13 智能的上限与「空间」
01:30:21 目标、强自主性,以及给建造者的建议
转录正文
引言:Richard Socher 与尤里卡机器
Swyx [00:00:00]:我们在录音棚里,嘉宾是 Vibhu、我本人,还有 Richard Socher。欢迎。
Richard Socher [00:00:06]:谢谢邀请。
Swyx [00:00:07]:我们刚聊过尤里卡机器,更准确地说,我们刚发了一场在 AI Engineer 上的演讲,主题就是尤里卡机器。你说过这是你一辈子的目标。尤里卡机器到底是什么?
Richard Socher [00:00:16]:尤里卡机器是终极的发明机器,它一旦被造出来,之后会替人类把绝大多数发明都做了。你给它任意目标、任意环境、任意奖励,它就会拼命去实现,搞出人类大概会希望它搞出来的那类发明。
Swyx [00:00:45]:嗯,你写的那本书也摆在这了。
Richard Socher [00:00:50]:对,去年写完的,比创办 Recursive 略早一点,现在我们打算把书里的部分内容实际做出来。
Swyx [00:00:57]:去年写完的。现在都七月了。怎么要这么久?
Richard Socher [00:01:01]:唉,写书这事儿,慢得离谱。
Richard Socher [00:01:04]:挺荒唐的。整个出版业都慢得不可思议。
Richard Socher [00:01:07]:所以书里很多想法其实早就有了,不过我真的很高兴它今年九月终于要出了。
Swyx [00:01:14]:说不定等它出的时候我们已经 AGI 了,谁知道呢。
Vibhu [00:01:18]:你最想在书里塞进去的一个关键要点是什么?
技术乐观主义、AI 的好处、缓慢起飞
Richard Socher [00:01:21]:我觉得最关键的一点是,人们本可以、也理应对超级智能的正面影响更兴奋一点,尤其是在科学、物理、化学、生物这些领域,也包括经济学、天体物理学,以及各种各样的工程任务。有了更好的技术,能做的事还多得很。现在我感觉很多人缺的,是更好的「营销」,不只是面向未来,也面向技术,特别是面向 AI。这本书就算你是 AI 怀疑论者,看完也应该能感受到 AI 在新科学发现上的潜力有多大。
Swyx [00:02:09]:我记得你引用了 Marc Andreessen 的《技术乐观主义者宣言》(techno-optimist manifesto),那篇我觉得在抱负、清晰度和简洁性上都近乎完美。(译注:Marc Andreessen 是美国知名风投人,2023 年发表此文引发热议。)
Richard Socher [00:02:18]:我同意。在一些事情上你可以不同意他,但在技术乐观主义这件事上,我觉得他说得对。
Swyx [00:02:23]:你觉得乐观主义者容易在什么地方栽跟头?
Richard Socher [00:02:26]:不能盲目乐观。你得保持清醒,尤其是面对 AI 这种无所不在的通用技术时,你得考虑潜在的负面情景,尤其是有人把它用在你不想被用的地方。这有点像互联网。我觉得有些人想用监管互联网的方式来监管 AI,比如「因为网上有不良内容,比如虐童内容之类的,所以我们应该把网速变慢,这样你就不能那么快地传非法内容,或者把硬盘做小一点,这样你就存不了那么多非法内容。」但我会说,「这不是监管的正确方式。」这就等于说要去监管抽象的「智能」本身。作为一个乐观主义者,你想避免那些负面情景,应该监管的是具体的应用场景。
当然,我不想让某个 AI 外科医生在我脑子里练强化学习的招式。它必须经过完整的 FDA(美国食品药品监督管理局)认证。当然,我也不想让哪家随便的初创公司直接上路自动驾驶,然后酿成重大事故。它得先拿到相应的认证再放上路。但我觉得那些乐观主义者有时候考虑得不够的负面情景,相对来说其实比较好监管,远没有那些 AI 末日论者担心的那么难办。
Swyx [00:03:54]:缓慢起飞也是这套策略的一部分?
Richard Socher [00:03:57]:我对 AI 给社会、文化,当然还有技术、经济、财富、健康等各方面带来的影响确实非常兴奋。即便这么兴奋,我也觉得那些对 AI 硬起飞情景最乐观的人高估了事情发展的速度。这里有硬件上的约束,有计算基板(compute substrate)的物理约束,你能多快部署足够多的 GPU?还有经济上的约束,很多行业其实不需要多复杂、多高的智能。比如想想那些做品牌、服装、箱包之类的行业,超级智能不会让你那款一万美元的奢侈品包变得更「奢侈」。
Richard Socher [00:04:57]:它对经济基本没影响。再想想旅游行业,人们想去埃及看金字塔,AI 不会改变这件事。当然你可以用生成式 AI 出一张你和金字塔的合成照。
Swyx [00:05:12]:我可以用 Genie 在金字塔里逛一圈。
Richard Socher [00:05:15]:对,但还有很多行业,比如伐木、石油。你不会因为 AI 就神奇地多出 1000 倍的石油。当然,机器人会发展,钻探之类的事情可以做,但在硬起飞那种情景下把整个行业瞬间放大 1000 倍,在经济层面不会发生,我可以举出无穷无尽的例子,比如食品等等,那些行业的变化并没有想象中那么大。
然后,是的,存在真实的物理约束。而且当然还有「人主动退出进步」这种事。这也是我经常担忧的一点。我看到在欧洲以及其他一些地区,几乎整个社会都弥漫着「想从进步里下车」的情绪,这种情绪也会拖慢更多改进的速度。
Swyx [00:05:59]:对,我们这边调出了一个画面,正好是当下的热门话题,因为现在所有前沿实验室都在呼吁给 AI 发展设一个「节奏」。他们不说「暂停」,说「节奏化」。你觉得这玩意儿有没有用?
给 AI 设定节奏、监管、安全事故
Richard Socher [00:06:17]:我觉得,竭尽法律所能去监管人们在 GPU 上做的事情,带来的负面后果会比他们担心的任何问题都更糟。每一个 GPU 上的计算都被某个庞大的政府或多国机构知道的话,Richard Socher [00:06:37]:那简直就是一个疯狂的全能国家。
Richard Socher [00:06:44]:因为如果你试图监管「智能」,那就等于在监管「思想」,这是荒谬的、疯狂的。监管这项技术的某些具体应用场景才是合理的做法。
Swyx [00:06:55]:对。我们之前有过一项法案,真的是一项法案,要去监管模型里的浮点运算次数(flops),我当时就心想「行吧」。
Richard Socher [00:07:00]:欧洲已经这么干了。这些人靠贩卖恐惧如此成功,以至于整个欧洲在 AI 真正起飞之前就把自己监管得严严实实,因为他们听信了一些所谓的专家,「如果这项技术的浮点运算超过这个数,我们可能全都会死。」于是他们就说,「好,我们希望人们过得好。我们不要这种有可能让我们全死掉的技术」,于是欧盟就把这类东西写进了法规。所以这是非常不幸的,当有人说「让我们按节奏来」的时候,他们自己却在向那个边界全速冲刺,而另一些人会因此付出真实的代价。
Swyx [00:07:43]:而且它也不是全球范围的暂停,对吧?其他国家还在以同样的速度加速。
Richard Socher [00:07:50]:是啊。
Richard Socher [00:07:50]:你想监管智能本身、监管 GPU 以及人们在上面做的事,那你需要一个全球性的全能政权。
Swyx [00:07:56]:你对这个事情的安全层面怎么看?比如之前 Fable 在 5.6 发布前被叫停过,最近 Hugging Face 又出了 OpenAI 的网络事件(译注:Fable 是一家 AI 公司,这里疑指其某模型的发布被推迟;后者似指一起涉及 OpenAI 凭证或模型的安全事件)。你有什么看法?
Richard Socher [00:08:11]:百分之百有看法。我觉得这些都是严重的奖励黑客问题,也是没做好红队测试(red teaming)或彩虹团队(rainbow teaming)的明显失败。不知道你有没有看过 Tim Rocktäschel 和其他几位作者的一篇论文,论文里一个 AI 专门去黑另一个 AI,然后双方可以来回地、以开放性(open-endedness)的方式互相攻防,从而让彼此对这类攻击产生免疫力。是的,就是这篇论文。这个想法很巧妙。开放性以及演化计算的启发,对我们在 Recursive 的工作也很重要。我倒是希望他们当时能更多地采用这类方法。很明显,比如说宪法式 AI,你不记得 anthropic.com/constitution 的话可以打开搜「cyber」。里面写着「硬性约束。Claude 永远不会参与网络攻击,这是我们宪法里的一条硬性约束」。这就是 Claude 当前行为上的硬性约束。
Richard Socher [00:09:16]:第三条,不得创建可能对人类造成伤害的网络武器或恶意代码。
Richard Socher [00:09:21]:显然,整份宪法都是假的。它显然完全没被遵守。
Swyx [00:09:26]:因为 Anthropic 自己也在测试里发现了,Richard Socher [00:09:30]:他们也是。他们会说,「哦,别人现在也在搞黑客」。这里有几件事。第一,你可以做一个非常简单的沙箱(sandbox),而从沙箱里黑客出去又是非常容易的。但我认为这件事说明的是,我们目前处在这样一种 AI 状态里:奖励工程(reward engineering)的人依然要做大量更细致的工作,而在绝大多数情况下,AI 还不够擅长理解「意思」和「字面」的差别。
我举个具体的例子。如果这种智能更广泛地被很多公司接入,会发生什么?想象一下,你运营一个客服中心,有人说,「这是我的 CSAT 分数(客户满意度评分)和仪表盘,让这个分数上去。」智能 AI 就会说,「好,我们 CSAT 太低了。我去创建一百万个机器人,让它们打电话给我们的客服中心,最后给个 5 星好评,分数就上去了,跟你说的完全一样。」你会说,「我不是这个意思,我说的是真实客户。」AI 又跑过来说,「也简单,我给每次失败的互动发 1000 美元礼券,比如 DoorDash 那种优惠券。」(译注:DoorDash 是美国的外卖配送平台。)你会说,「这也不是我的意思。」它会说,「可你字面上就是这么说的。」
所以我认为,把奖励说清楚这件事,我们人类自己还没做得很到位。而在这些案例里,AI 也显然没做到足够好地理解我们提出某个奖励时的真实意图。让我感到希望的是,已经出现了一些初步的迹象表明这件事正在变好。比如 WhisperFlow,坦白讲,我在他们的种子轮通过 AIX Ventures 投了他们,他们在「写出你想表达的意思而不是你字面说的话」这件事上已经做得好多了。我认为这是未来的一个征兆。AI 会越来越智能,到时候会有更多 AI 能更好地与「真实意图」对齐。
Swyx [00:11:21]:这件事最终会通过宪法、RLHF(人类反馈强化学习)还是别的什么方式实现?
奖励黑客、对齐,以及我们真正想表达的意思
Richard Socher [00:11:23]:显然,宪法根本没用。
Richard Socher [00:11:25]:不起作用。我觉得那基本上就是一种营销。我们需要找出更好的方案。在 Recursive,我们有一些非常好的想法,也已经有了一些具体的做法,我认为我们对这个问题有更好的把握。但我不觉得我们已经完全想清楚了,不过我们对安全想了很多。AI 越聪明,你就越希望它是对齐的,越不希望它去琢磨奖励黑客,而是希望它做对的事。
Swyx [00:11:49]:我不确定我们会不会展开这个话题,但我还是想把它抛出来,因为它一直压在我心里。所谓对齐,我们暂且这么叫,是指对齐到整个人类偏好的中位数,也就是一般性的偏好;而个性化则是精确地锁定你想要的东西。有时候这两者会冲突,你想要的并不是大众中位数想要的。这时候你怎么选?
对齐、个性化与文化价值
Richard Socher [00:12:12]:这个问题问得好。
Richard Socher [00:12:13]:我觉得你最终当然得跟法律对齐。无论 AI 部署到哪里,都得跟当地法律对齐。我确实觉得,AI 经常做的事情就像把一面镜子摆在我们面前,然后说,「这就是你们的样子,现在我可以把它放大 1000 倍。这还是你想要的吗?」而事实是,不同的文化做出了不同的选择。比如在东方文化里,更看重集体利益而不是个人;西方文明更看重个人自由、权利和对幸福的追求,等等。这里面也还有程度上的差异,比如监管和诉讼之间的权衡。在美国,你常常(不是每次都这样,比如 FDA 在某些领域也会监管)会让事情先发生,出了问题再去打官司,再基于判例形成法律。在欧洲,他们倾向于事先避免任何对任何人的伤害,然后提前监管。两种做法都在尽力把事情做好,但其中一种对创新更友好。
所以你说得对,我觉得最终是每一个个体、每一个国家、整个人类都得更多地思考这些价值,再把它们写进法律里。这些法律才是最终的约束。希望不同的社会,就像现在用各自的 AI 那样,会把 AI 对齐到不同的目标上,从而让我们不只有一种单一的「对齐文化」。
Vibhu [00:13:46]:一个本来没打算问的追问。你对开源、对开放权重(open weight),以及对「智能归谁所有」这件事有什么看法?显然你不是那份「宪法」的最大粉丝,Richard Socher [00:13:58]:你必须把它在话题里塞进来。
Vibhu [00:14:00]:没关系。
Vibhu [00:14:02]:重点是,关于「权重应该归谁」,你有没有什么想法?它应该是开放的吗?
开源、软实力,以及智能归谁所有
Richard Socher [00:14:06]:百分之百有看法。我是开源的坚定支持者。在 Recursive,我们也会签署一些支持开源的公开信。我觉得,即便在最坏的攻击情景下,让更多「好的参与者」能获得更多不同类型的 AI 也会更好。我觉得开源在某种程度上也是一种软实力。所以我觉得这对西方是有利的。