AI DAILY / 2026-09-18
ekzhang/openjev-sglang:兼容 Jev 接口的开源端点(仅预填充)
ekzhang/openjev-sglang
全文中文翻译 · AI 生成,仅供学习交流
ekzhang/openjev-sglang
openjev-sglang — 基于 SGLang 运行的服务器,使用 Qwen3.6-35B-A3B 实现 TypeSafe/Jev HTTP API。
每个容器配备一张 B200,搭配 SGLang 0.5.19 的 Rust 前端(frontend)、radix 缓存(radix caching)以及可中断的 prefill CUDA 图(CUDA graphs)。一个独立的 Python API 进程使用 FastAPI、uvloop、由 Rust 加速的 HF 分词器(tokenizer),并通过连接池与 localhost 上的 SGLang 建立异步 HTTP 连接。CUDA 相关依赖全部留在 SGLang 容器中;在笔记本上执行 uv sync 时只会安装 API、部署工具和测试,不会安装这些依赖。
在 Modal 上运行
uv sync
#Only if you haven't authenticated Modal on this machine:
uv run modal setup
#Start a temporary Server, run actual inference checks, then shut it down:
uv run modal run modal_app.py
#Deploy a stable public endpoint:
uv run modal deploy modal_app.py
部署过程会输出一个形如 https://...us-west.modal.direct 的 URL。它使用一个 Modal Server,设置 unauthenticated=True、routing_region="us-west"、compute_region=["us-west", "us-central", "us"]。
自动扩缩没有显式的容器上限,空闲 5 分钟后会缩容到零(scale to zero)。
若希望常驻一张 B200,请在 modal_app.py 中设置 min_containers=1。
如果 SGLang 异常退出,API 也会一并退出。Modal 启动器(launcher)会监控 API,并在 API 退出时让容器退出,让 Modal 用新容器替换它,而不是让一个 HTTP 进程继续存活、背后却对着一个已经死掉的推理后端。正常关闭流程会让两个监控器都失效。
缓存预热也会额外请求一个未被使用的 token 概率,以规避 SGLang 在混合 logprob 批次下的崩溃。
这样做可以让预热请求与打分请求保持批次兼容,而无需修改 SGLang。
首次构建会导入一个体积较大的 SGLang 镜像。GPU 首次启动时还会下载权重,并编译/捕获(capture)kernel。模型权重会持久化到名为 openjev-huggingface 的 Modal Volume 中,SGLang 的调优缓存与 Triton 编译缓存也会一并放在那里。后续启动会复用这些文件;但 CUDA 图捕获仍会在每次启动时执行。Rust 前端会接收一个显式的本地分词器目录,以避免对固定 revision 的快照进行远端名称查找时出现的问题。
一个缩容到零的 Server 在启动过程中就会开始接受请求;附带的 smoke 命令会对启动期的响应做重试。
uv run openjev smoke https://YOUR-SERVER.us-west.modal.directsmoke 测试覆盖全部三种答案类型、一道 64 选项的问题、基本的语义合理性检查以及对 65 选项的拒绝。它会报告启动等待时间、推理时延以及缓存使用情况。
modal run 会把这份报告保存为 smoke-result.json。
请求
curl "
$OPENJEV_URL/v1/systemone
"
\-H'Content-Type: application/json'
\-d'{"model": "jev-latest","state": [{"role": "system", "content": "You are a support assistant."},{"role": "user", "content": "I was charged twice. Please refund the duplicate."}],"questions": {"refund": {"type": "noul","instructions": "Does the user request a refund?"

},"department": {"type": "choice","instructions": "Which department should handle this?","criteria": {"billing": "Payments and refunds", "technical": "Software bugs"}},"urgency": {"type": "score","instructions": "How urgent is the request?","criteria": ["Routine", "Urgent", "Emergency"]

}}}'
或者使用:
curl "$OPENJEV_URL/v1/systemone" -H 'Content-Type: application/json' --data-binary @examples/request.jsonstate 与 instructions 接受字符串、JSON 对象或数组。若 state 是一个聊天消息列表,或者恰好是 {"messages": [...]} 形式,则使用模型的原生 chat template 进行渲染。原始的角色与消息对象会被保留;分类问题会被追加为一条额外的 user 轮次,即便它出现在另一条 user 轮次之后。其他结构化的 state 会被原样序列化进一条 user 消息。
包含 messages 同时还携带其它字段的对象会整体保留,以避免元数据被静默丢弃。聊天状态仅支持文本,不支持图像/音频/视频内容。
路由
| 路由 | 用途 |
| --- | --- |
| POST /v1/systemone | Noul、Choice、Score 三类评估 |
| GET /v1/models | 模型目录,含 TypeSafe 与 OpenAI 风格的字段 |
| GET /v1/limits | 准入限制 |
| GET /health | 就绪状态,含 SGLang 健康状况与启动耗时 |
| GET /health/live | API 进程存活状态 |
| GET /Scalar | API 参考文档,带可编辑的示例与请求客户端(译注:Scalar 是一款交互式 API 参考文档工具) |
| GET /docs | 内置的 Swagger UI |
| GET /openapi.json | 生成的 API schema |jev-latest 是已配置 Qwen 模型的一个兼容别名。对外公开的模型 ID 是 Qwen/Qwen3.6-35B-A3B;NVIDIA 的仓库仅作为内部权重来源。可通过设置环境变量 OPENJEV_SERVED_MODEL_NAME 或运行 openjev serve --served-model-name NAME 来覆盖这个对外 ID。该值也会作为 --served-model-name 一并传给 SGLang。
不会有任何请求发往 TypeSafe。面向公网的服务器就是评估 API;SGLang 的生成与管理类路由仅在 localhost 上可用,并不会对外转发。
推理工作流程
1. 校验 schema、答案数量、请求体大小、上下文长度以及总 token 预算。
2. 渲染一次原生 chat template,禁用 thinking(思维链模式)。拆分出公共前缀(common prefix),并对每个问题后缀独立进行分词。
3. 将公共前缀以 max_new_tokens=1 发往 /generate,等待完成后丢弃采样得到的 token。这一步用于预热 SGLang 的 radix 缓存。
4. 并发地对每个问题发送「前缀 + 问题后缀 + assistant 头 + "Answer:\n"」。每次调用同样使用 max_new_tokens=1。为每个答案标签请求 token_ids_logprob,并将 logprob_start_len=-1,从而无需重新计算 prompt logprob。采样得到的 token 本身被忽略。
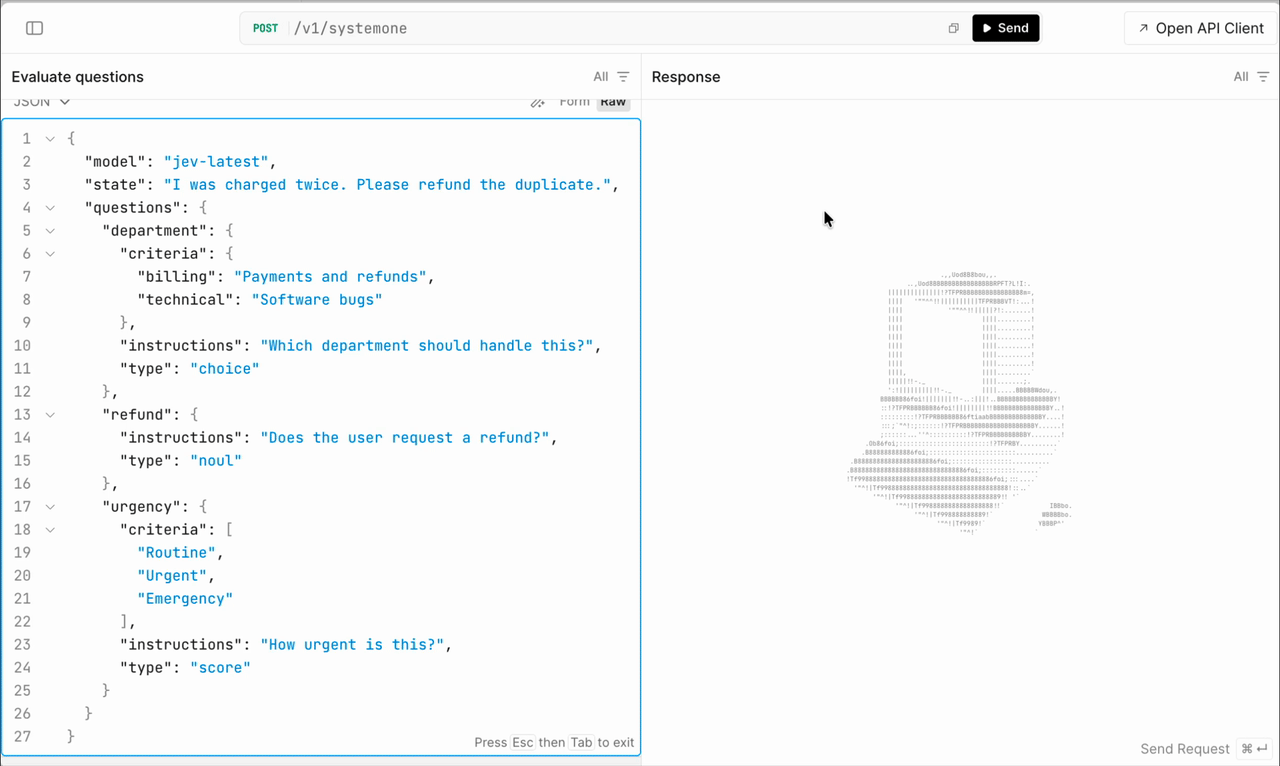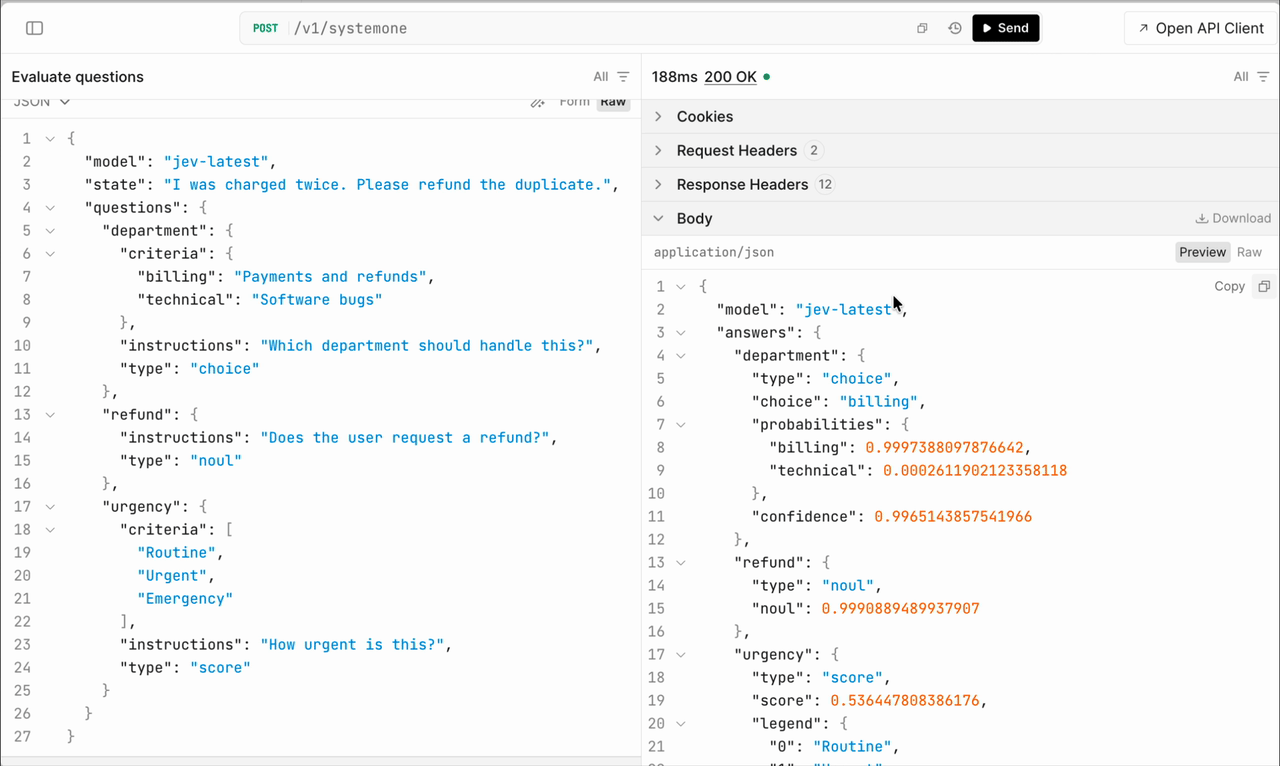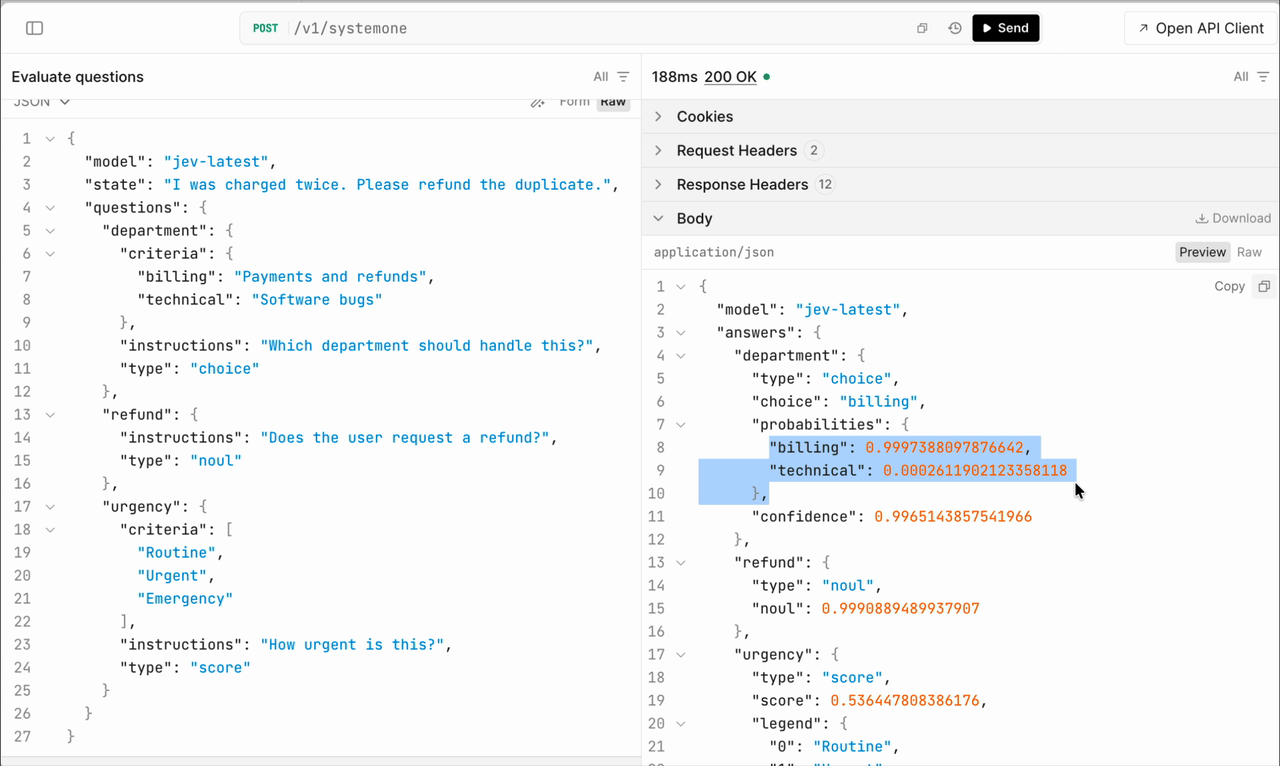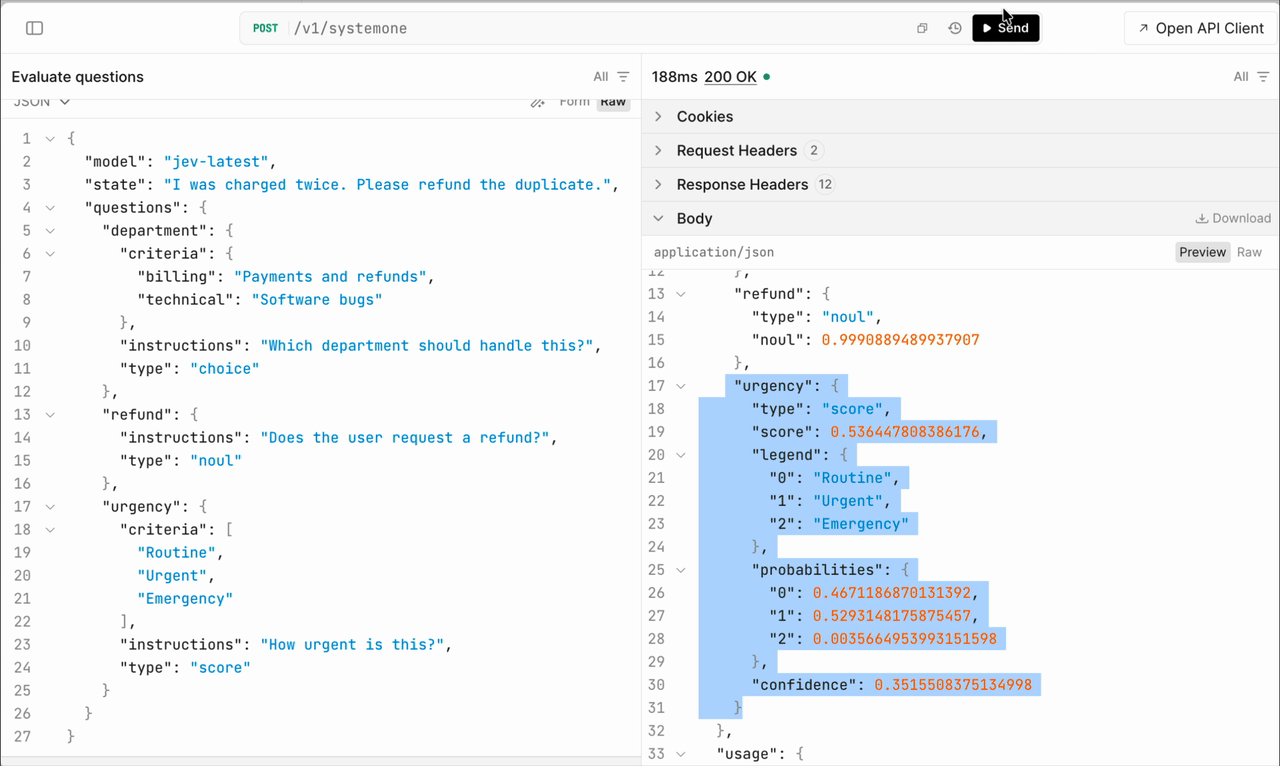
5. 使用数值稳定的 softmax 对所请求的标签 logprob 重新归一化。Noul 返回 P(yes);Choice 返回 argmax 与完整分布;Score 返回 sum(level_index * probability),层级从 0 开始计数,并附带一份图例(legend)。
选项渲染为 A: 描述、B: 描述 等形式,不带 JSON 包裹层。Choice 的 key 用于在响应中标识字段,并会对模型隐藏;唯一例外是当 description 为 null 时,此时 option 的 key 充当其语义,对应 Jev 中可空 description 的 schema。
这是一个 prefill 加首 token 读出(first-token-readout)型负载:不存在生成的思维链,首 token 之后也没有自回归续写。对 N 个问题而言,共有 N+1 次单 token 调用,其中包含一次缓存预热调用。
未启用推测解码(speculative decoding)。
由于 Qwen 会将多位数字切分为多个 token(tokenize 为多个 token),答案标签因此采用 A–Z,再接已经过验证、确保为单 token 的字母组合(AA、AB、...)。
全部 64 个标签都会在启动时与实际分词器进行核对。你原始的选项名称会在返回的分布中原样保留。这样一来,64 路分类就始终是严格意义上的单 token 读出,而不是去比较多 token 数字的首位数字。
Radix 复用的是机会式的,并非按请求固定的 KV session。在 Qwen 混合(Hybrid)架构的循环状态(recurrent state)、缓存页边界、缓存压力以及并发请求等因素下,命中率可能下降。后端使用 --mamba-radix-cache-strategy extra_buffer。
x-openjev-prefix-tokens 头部会暴露请求的公共前缀大小。当 SGLang 上报缓存命中数时,x-openjev-cached-tokens 会汇总各个分支的缓存命中。SGLang 0.5.19 的 Rust 前端省略了这些计数:该头部不会出现,smoke 报告会写入 null,而不是一个有误导性的零。Scheduler 日志中仍然会显示真实的缓存命中(在 B200 线上部署上已验证)。
Server-Timing 头部会区分 prompt 准备阶段、共享 prefill 阶段以及分支推理阶段。
usage.input_tokens 会对 SGLang 在预热与所有分支上报告的完整 prompt 计数求和,其中包含被缓存命中的 token。
usage.output_tokens 等于 N+1。这些是后端的使用计数,并非 TypeSafe 的计费估算,也不是实际计算出的唯一 token 数。
限制与配置
默认值如下:64 个问题;Choice/Score 每个问题 2–64 个答案;JSON 请求体上限 2 MiB;每个分支(含其输出)最多 32,768 个 token;累计提交输入 token 上限 262,144;最多 16 个并发评估;最多 64 个并发后端调用。
非法请求会在进入推理前返回 422;请求体过大返回 413;过载返回 529 并附带 Retry-After。后端超时返回 504。失败或被取消的评估会取消其兄弟请求,并尝试在 SGLang 中中止它们。
所有设置都可以通过 OPENJEV_* 环境变量提供,详见 src/openjev/config.py。常用设置:
| 变量 | 默认值 |
| --- | --- |
| OPENJEV_MODEL | nvidia/Qwen3.6-35B-A3B-NVFP4 |
| OPENJEV_SERVED_MODEL_NAME | Qwen/Qwen3.6-35B-A3B(按 profile 区分的对外公开名) |
| OPENJEV_REVISION | 默认模型固定的 NVIDIA checkpoint revision |
| OPENJEV_FRONTEND | rust(python 是显式的回退选项) |
| OPENJEV_MAX_INPUT_TOKENS | |
| OPENJEV_MAX_TOTAL_INPUT_TOKENS | |
| OPENJEV_MAX_CONCURRENT_REQUESTS | |
| OPENJEV_MAX_CONCURRENT_BRANCHES | |
| OPENJEV_REQUEST_TIMEOUT | 秒 |
| OPENJEV_TEMPERATURE | 1.0,在标签归一化时生效 |
| OPENJEV_API_KEY | 未设置;可选的 API Bearer 认证 |
| OPENJEV_BACKEND_API_KEY | 未设置;可选的 SGLang 独立 Bearer key |Modal 启动脚本会从本地环境转发 OPENJEV_PROFILE、OPENJEV_FRONTEND 和 OPENJEV_SERVED_MODEL_NAME。若需定制其它远程设置,请将它们加入 image.env(...),或使用 Modal Secret 来注入密钥。默认的 Modal 端点有意不启用任何认证。
OpenJev 定义 confidence = 1 - H(probabilities) / log(number_of_options),并裁剪到 [0, 1] 区间。
均匀分布时该值为 0,完全集中在一点时为 1。概率以所提供的选项为条件,依赖于 prompt 和标签的顺序,并非经过校准的正确性估计。
本地开发 / 已有的 SGLang
uv sync
uv run pytest
#offline unit + API tests
uv run pytest -m integration
#real tokenizer, small HF download, no GPU
uv run ruff check .
uv run openjev schema
#no GPU or model download
#Connect to an existing backend; it must have matching model/tokenizer revision,
#selected-token logprobs, radix cache, and a sufficient context length:
uv run openjev serve --connect http://127.0.0.1:30000
#On a B200 host/container with SGLang 0.5.19 installed in another environment:
uv run openjev serve --sglang-python /path/to/sglang/bin/python