AI DAILY / 2026-09-20
Hermes代理的JEV技能扩展包
kerpopule/hermes-jev-skills
全文中文翻译 · AI 生成,仅供学习交流
你的代理把旗舰模型(frontier model)的 token 浪费在不算思考的事情上:本轮该用哪个模型来回答、377 个技能里要加载哪一个、哪些检索段落才有用、压缩摘要时哪些对话轮该留下来、下一步该按哪个按钮。这些都是决策,不是写正文。把它们交给那种几分之一美分、约 0.4 秒就能给出答案的模型,让昂贵的模型专心去写作。
Jev 就是干这个的。它是 TypeSafe 的决策模型,从不写正文。你给它一个状态(state)和带类型的问题(pick one、score this、yes or no),它回以一个校准后的置信度(calibrated confidence)。这个仓库把它接入代理的日常工作流。
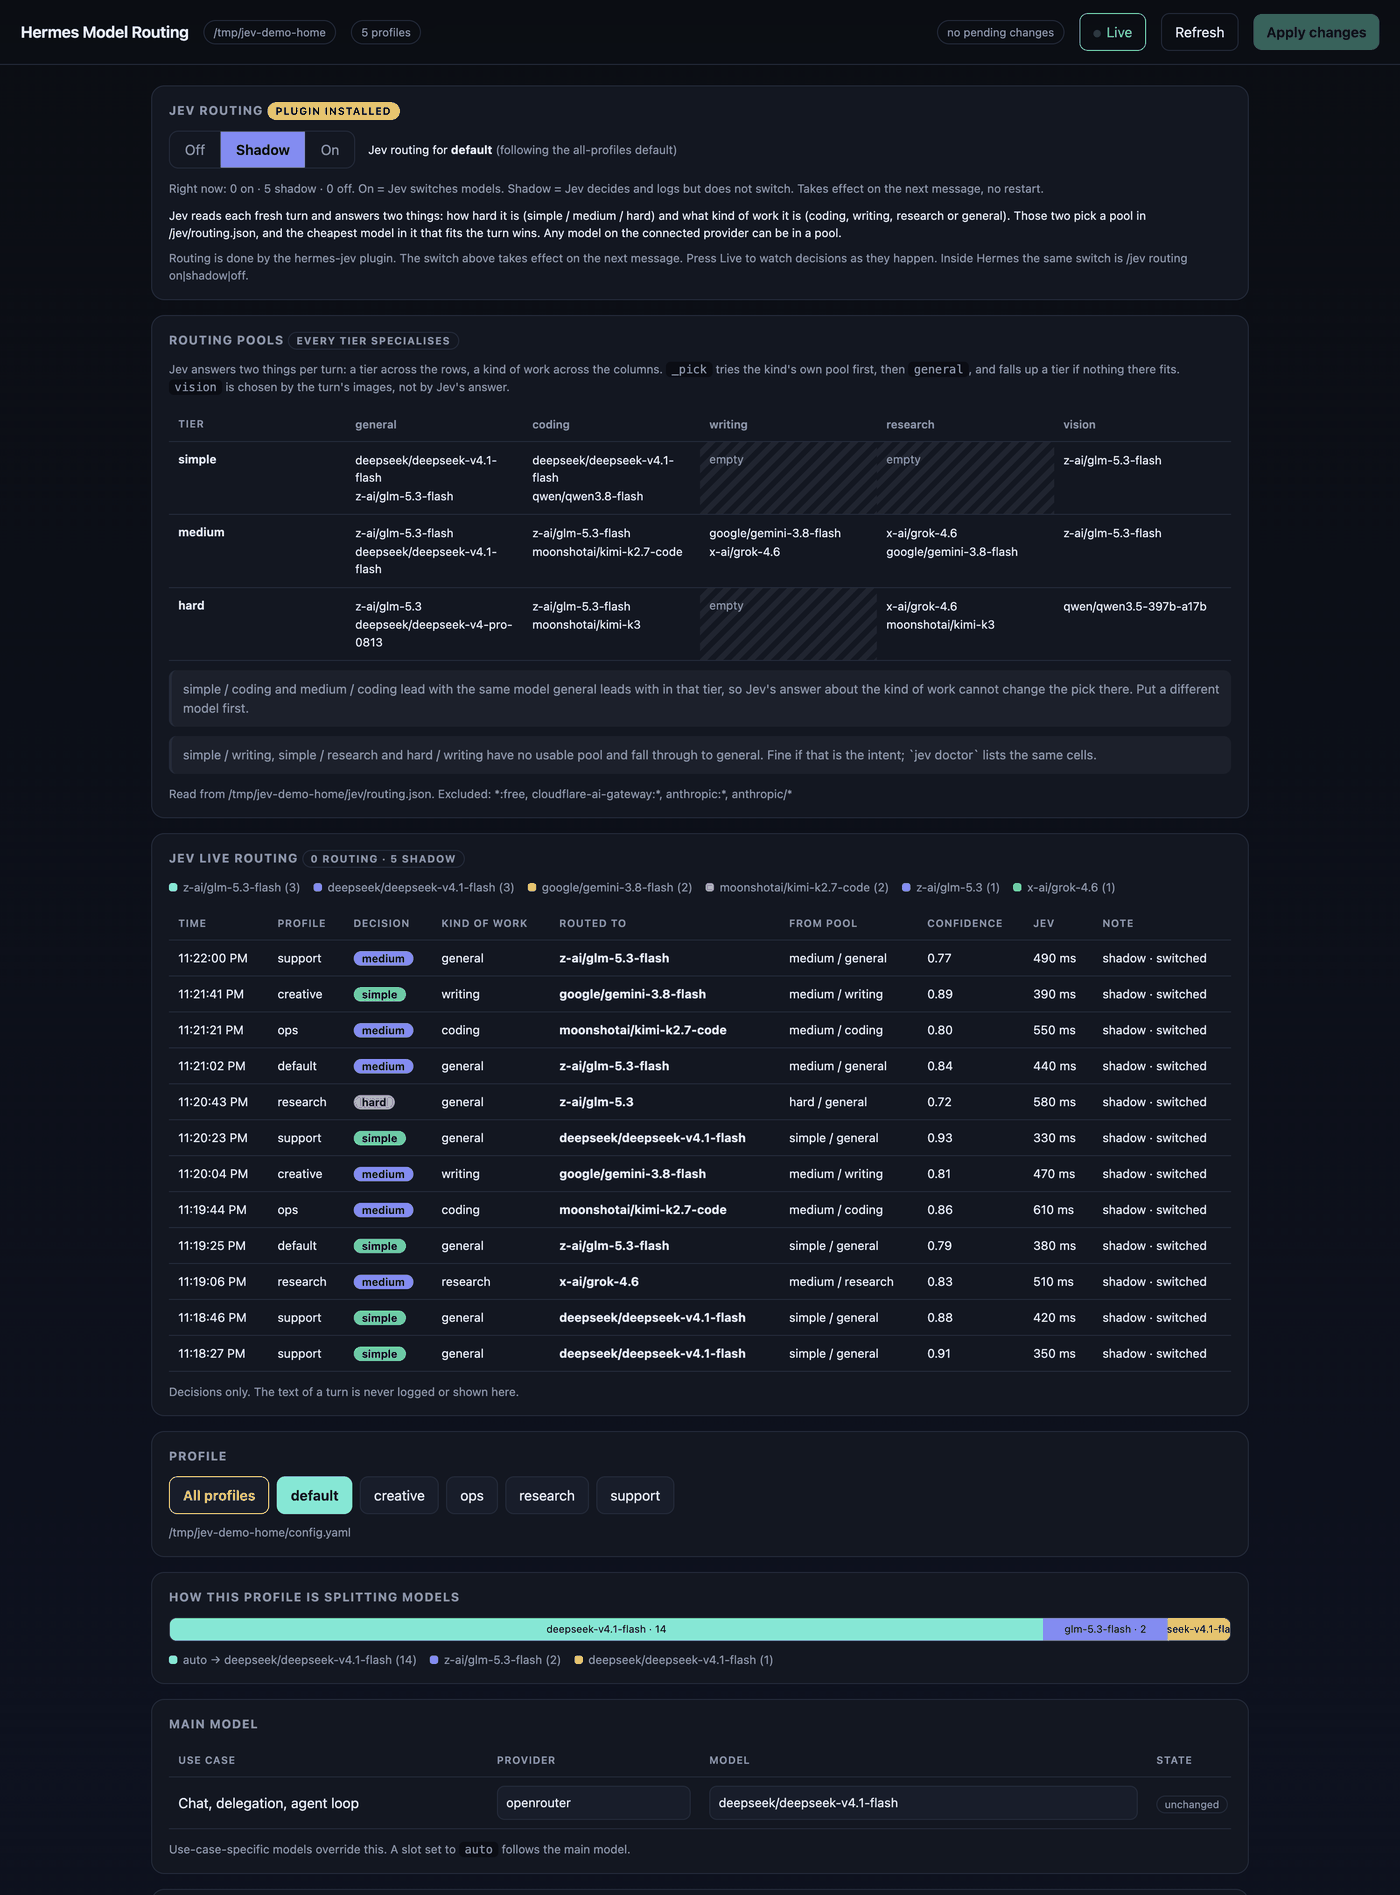
jev 仪表盘。展示的 profile(配置)、path(路径)和决策是演示用的样板主页;路由池(pool)是真实在跑的一组。一个开关切换 Jev 路由;每个池以「层级(tier) × 任务类型(work kind)」网格呈现;每条决策发生时即时显示(层级、任务类型、模型、来源池、置信度、延迟)。
Jev 决定什么,要花多少钱
| 技能 | Jev 决定什么 | 实测 |
|---|---|---|
| 模型路由(Model routing) | 本轮用哪个模型就已经够好,从你能调用的所有模型里挑 | 每轮约 0.4 秒 |
| 记忆(Memory) | 哪些检索到的段落值得读,哪些藏着隐藏指令 | 每次请求 60 段,每次调用最多 480 段;即使 Jev 宕机,注入筛查(injection screen)也在本地运行 |
| 交接(Handoffs) | 默认不交接。我们测过:用 Jev 的 keep / summarize / drop 摘要写出的交接,召回率比直接基于原始转录写出的还低。实际出货的是完整对话,1,200 字,并且能跳回旧会话 | 单凭摘要召回率 58.7%,加一次搜索 75.0%;对照方法分别为 37.5% 和 68.3%(评分卡) |
| 轮次筛选(Choosing turns) | 当转录必须被截断到固定大小时,保留哪些轮次 | 0.95 秒处理 71 轮;比按时间近度(recency)筛选更胜一筹,11 题对 4 题 |
| 技能选择(Skill selection) | 这一