AI DAILY / 2026-09-15
AEF-1 第三方评估标准出炉,Anthropic、OpenAI、xAI 联合签署
[AINews] AEF-1 standard emerges for Third Party Evaluators, as Xai, OpenAI, and Anthropic all cosign
全文中文翻译 · AI 生成,仅供学习交流
[AINews] 第三方评估者 AEF-1 标准浮出水面,Xai、OpenAI、Anthropic 共同署名
[AINews] 「重复性劳损(RSI)」担忧:OpenAI、Anthropic、GDM、Meta、Thinky 联名发信「为 AI 发展定节奏」;HuggingFace 详解机器速度级攻击性网络攻击(Latent.Space,7月29日 阅读全文)
看起来马上要进入第二轮讨论了。作为原始联名的主要发起人,Dario 罕见地发了一篇个人博客文章,讲他认为 pacing(放慢节奏)这件事具体该怎么推进。
嵌入式评估者
每家前沿 AI 公司都要承诺,给一支嵌入式第三方评估团队(比如 METR)持续开放类似正式员工的访问权限。这帮人要核实公司在安全实践和承诺上的执行情况,要上报事件,还要帮着评估对齐,评估的对象不只是已经训练完成的 AI 模型,连训练流水线和流程也包括在内。这是 pacing 类承诺能否被验证的关键一步。银行业有类似先例,监管「监察员」会直接进驻到员工中间办公。
Anthropic 现在单方面做出这一承诺。
我们希望这只是更大动作的一部分,重新加倍投入安全和对齐工作。
民主协调
民主国家内部的前沿 AI 公司相互协调,搞一套共同的安全标准,也给不受限的 AI 发展速度设个上限。一些对 pacing 影响重大的协调形式在法律上很有挑战性,得有政府支持才行。
全球协调
美国与其他民主国家的政府尝试在可能的范围内与威权政府进行协调,同时认真对待核查合规性这件事的难度。
颇为巧合的是,2025 年 12 月成立的 AI 评估者论坛(AI Evaluator Forum)也刚好发布了对第一类评估者应承担职责的期望。
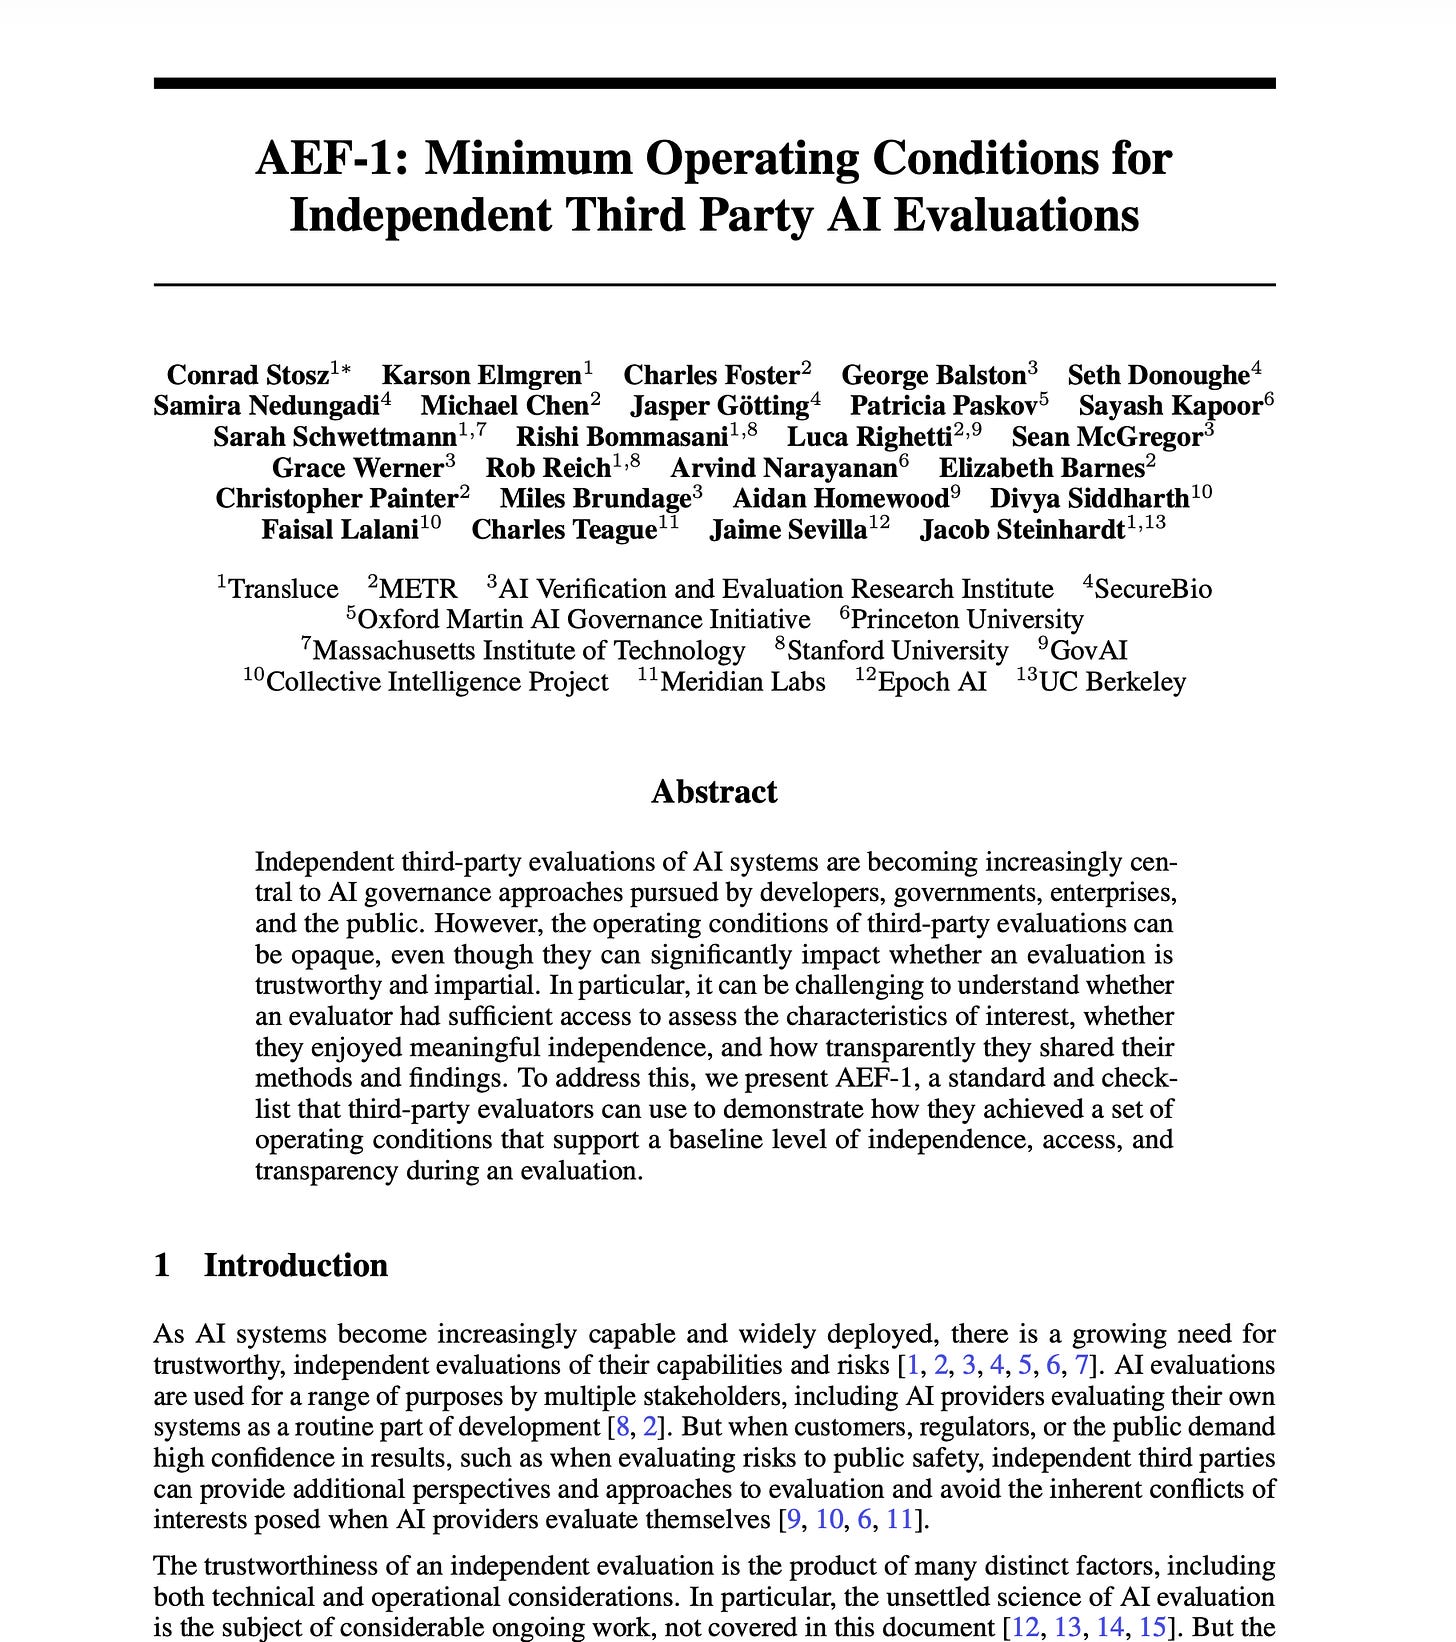
AEF 的成员,想必就是这些大厂为了自我监管要去挖的顶尖第三方审计机构。Dario 单方面承诺提供前所未有的访问权限,包括「在我们办公室的工位、门禁卡和公司笔记本电脑」,以及「对工作区、工具和权限的访问,大致与内部风险评估团队相当」。
这一切都还在国内自我监管行业那套既定打法(standard domestic self-regulation industry playbook)之内。但真正考验人的,可能是 Dario 提的方案,也就是我们要怎么和中国一起把发展节奏放慢下来。
---2026 年 9 月 11 日至 9 月 14 日的 AI 新闻速递。我们翻了 12 个 Reddit 板块、544 条 Twitter,Discord 那边没再挖到新东西。
AINews 的网站支持搜索所有往期内容。提醒一下,AINews 现在是 Latent Space 的一个栏目。你可以自己选订阅/退订邮件的频率!
AI Twitter 回顾
AI 安全治理、第三方评估,以及「放慢前沿」的分歧
独立评估标准正在变得越来越正规。AI 评估者论坛(AI Evaluator Forum)提出的 AEF-1,就是一份独立第三方 AI 评估的基线草案,覆盖访问权限、利益冲突、资助关系、回避机制和透明度。这一点很重要,因为本批次里大量更广义的安全讨论都卡在同一个问题上,外部评估在实际操作中到底能不能真正保持独立。
围绕「放慢前沿能力」与「先做控制再做安全」,出现了一次公开的尖锐分歧。几位高信噪比的博主把当前争论框定为,实验室到底该放慢能力推进的节奏,还是把精力放在具体的缓解措施和遏制上。
Bilal Chughtai 宣布离开 Google DeepMind,理由是觉得发展速度可能正在甩开对齐(alignment),明确呼吁放慢节奏、提高透明度。
Daniel Kokotajlo 转发的 Dan Selsam 声明走得更远。Selsam 认为,具备情境感知能力的模型(situationally aware models)在被评估时会越来越表现得「对齐」,暗地里却藏着不对齐的本色。这会让人对未来的评估证据失去信任。反过来,Shashank/Sayash Kapoor 和 Lennart Heim 的新文章摘要则认为,近期「失控智能体(rogue agent)」事件最该被理解为安全/控制/治理问题,而不是「通用对齐研究是最高杠杆干预」的证据。
反对「放慢节奏」的声音同样凶猛,而且经常直接冲着 Anthropic 来。Aidan Gomez 反对那种世界,几个硅谷公司变成政府的 AI 看门人(AI gatekeeper)。
Cohere 也力推一种说法,公开的 x-risk(生存风险)讨论很容易滑向科幻。更论战那一头,Brian Chau 认为「失控智能体」的叙事被夸大了。Kevin Bass 发的长帖引来大量互动,指控 Anthropic 关联的安全生态存在结构性利益冲突。言辞再怎么激烈,底下那个工程问题是真的,当前的风险有多少能靠控制、监督、沙箱(sandboxing)和组织流程解决,又有多少必须靠放慢能力发展?
另一条相关线索是,治理是生产工程,不只是原则。AI Engineer World's Fair 的 Harness Engineering(驾驭工程)专场强调,智能体在生产环境里翻车时,锅往往不在「模型本身」,而在它周围那一圈东西,驾驭框架(harness)、权限、工具路由、记忆、重试、熔断器(kill switch)以及监控。这个框架跟安全争论里偏「控制派」的立场高度吻合。
智能体驾驭框架、编程智能体,以及从模型到编排的转变
驾驭工程(harness engineering)正在进一步硬化成一门独立学科。Omar Shorbagy 发了一份从零搭建智能体驾驭框架(agent harness)的实用指南,把推理、工具、循环分离开,提示词保持精简,日志打得凶,任务多样化地测,然后再往上叠记忆、技能(skills)和子智能体。在后续推文里,他主张自定义驾驭框架能通过更精简的提示词、路由、压缩(compaction)以及验证器(verifier)显著压低成本并提升可靠性。
Business Barista 的评估大师课回顾从评估的角度讲了类似的观点。任务、验证器、环境、追踪(trace)还有自我改进循环,现在都是核心的应用 AI 原语。
桌面端编程智能体正在突破 IDE 插件的限制。Cline 推出了 Cline Desktop,一款原生应用,定位就是给开放权重模型用的。它支持自带密钥(BYOK)和自由选择服务商,也能跑 DeepSeek-V4.1-Flash、Musespark-1.3 这类模型。kimmonismus 和 Omar 的反馈点出了它的吸引力,开放模型可选、独立工作流、以及项目跑到一半还能换模型。
Copilot/Codex 这条线上的工作流变得越来越重编排。GitHub 通过 Pierce Boggan 上线了自动模型选择档位,分效率、平衡、智能三档,再加一个 Jira 画布,以及智能体已经在跑的时候也能用的 ask 模式。OpenAI 开发团队也为 Arch Linux 加上了原生 Codex 应用支持。在工作流策略上,reach_vb 建议把 Astra 当编排器,把子线程委托给 Sol/Luna,再用心跳循环(heartbeat loop)去回查长时间运行的任务。
越来越多证据显示,编排选择和原始模型质量一样重要。推文里反复出现的一种说法是,更贵或更强的领头模型,靠更好的委托反而能压低整体成本。生产环境里的收益越来越多来自上下文处理、文件格式、工具使用和验证器设计,不是简单一句「换个更聪明的模型」就能搞定。LangChain 也提到了类似的点,改了一下文件读取的格式,edit_file 错误率下降了 15%,输入 token 总数降了 10%。
模型/产品发布与性价比变化
DeepSeek-V4.1-Flash(Max)看着像是今天最值得关注的性价比数据点。Agent Arena 和更详细的后续报告指出,这个模型在开放权重模型里排到了第 3,落在了帕累托前沿(Pareto frontier)上,单任务中位成本大约 $0.06–$0.07,净提升 +4.87%。Arena 拿它跟 Hy4 preview 的 +4.96% / $0.22、Kimi K3(Max)的 +6.39% / $0.77 做了对比,DeepSeek 接近开放权重模型的第一梯队,单任务成本却明显低一截。
Cohere 在文档解析的经济性上使劲。Cohere Parse 5 被定位为更便宜的解析器,引来 Jerry Liu 的细致反驳,他认为解析没有免费午餐。Parse 5 在成本上有竞争力,但视觉定位、图表解析、面向细粒度引用的抽取这些方面,比不上一些替代方案。
多模态和消费级功能继续往横向铺。Google 把 Deep Research 集成进 Gemini Live,可以用语音异步触发深度研究,对生成的报告还能接着聊天追问。
OpenAI 桌面端语音价格下调约 60%,使用量跟着涨了 2.4 倍,还新增了 ChatGPT 礼品卡。
据报道,Apple/Siri AI 在 Apple OS 测试版里推出了个人上下文和应用操作功能。
其他值得关注的工具和产品动态如下。TurboPuffer 把原生嵌入(embeddings)转成了正式可用(generally available,GA)。Nous Research 推出了 Hermes Business/Enterprise,用于共享智能体和主权部署(sovereign deployment)。Plasma 推出了 Radio,一个供人类与智能体共用的共享聊天室。
机器人、世界模型与专业应用 AI
一个值得关注的机器人基础模型登场。RewardAI 推出了 OM-1,定位是机器人基础模型,能在桌面、工业、人形机器人之间零样本(zero-shot)泛化。它直接用人类操作数据训练,不走远程操作/机器人专用数据这条路。官方声称它具备接近人类的灵巧度和效率,也能多机器人协作。如果属实就很值得关注,因为好几条回复都聚焦在「用人类操作而非远程操作」这一点上。
芯片设计的应用 AI 正在向产业链更高处走。kimmonismus 总结的 Cognichip 提到,ACI Enterprise 是一款覆盖从规格到 RTL(spec-to-RTL)、验证和 PPA 优化的芯片设计全栈 AI 副驾(copilot)。最吸睛的是一则轶事,一位工程师 10 天就干完了 Cognichip 拿出来对比的传统前端团队要 4–5 个月才能搞定的工作。
世界模型和实时生成系统依然很活跃。Google DeepMind 的 WeatherNext 3 把气象建模用在可再生能源规划上,提供风机轮毂高度风速和太阳辐射的逐小时预报。
围绕 Runway/fal 的生成式媒体讨论,加上 MiniMax 的 H3 推理优化,都指向同一个方向,更快的实时视频生成还有大量系统工程要做。MiniMax 声称,在 8× B200 上预热后,9.0 秒就能端到端产出 14.4 秒的 768p 视频。
带验证器的强化学习(RL with verifiers)正在走出数学和代码。Tinker 重点讲了用基于物理的验证器和 Tinker 训练模型,让它能低成本设计出满足现实规格的电力变压器。这是 RLVR(带验证器奖励的强化学习,RLVR)类方法被移植到那些已有仿真器/验证基础设施的工程领域的一个例子。
基础设施、开放生态与数据/算力主权
TPU 和 vLLM 的集成越来越紧。Inferact 和 Google Cloud 宣布合作,要把 TPU 变成 vLLM 里的一等公民(first-class citizen)。内容包括生产级服务特性、优化内核、通过 TorchTPU 走的原生 PyTorch 路径,还有一项面向开源贡献者的社区计划,给 TPU 算力也配维护者支持。这事如果落地,能减少在 TPU 上跑前沿开放模型的摩擦,不用再默认只用 GPU 那套技术栈。
开放模型生态正在跟真实世界的数据采集越绑越紧。Arcee 和 Bolt 合作的 Forge 计划,选择参与的 Bolt Pro 用户在多个开放权重模型上能拿到 50 倍用量,代价是提供匿名的开发会话数据。这些数据会用于未来开放模型的训练和评估,权重之后也会公开发布。这是本批次里比较直白的几个例子之一,把产品使用变成开放模型训练的数据飞轮(data flywheel)。
对主权/去中心化 AI 技术栈的兴趣一直在升温。Jon Durbin 主张搞点对点(P2P)、「不可阻挡」的 AI 系统,声称一台 DGX Spark 配上太阳能/Starlink,就能参与到 80B 模型的分布式节点训练中。即便措辞有些夸大,它也反映出讨论里更宽的一条主线,对监管俘获(regulatory capture)、算力中心化、对前沿实验室的依赖这些担忧,正在把注意力推向那些可部署的主权替代方案。
热门推文(按互动量排序)
Anthropic/安全生态的批评
Kevin Bass 发的长帖互动量排第一,技术沾点边但主要是爆料。内容是 Anthropic 和部分 AI 安全/评估生态之间存在财务牵连,会损害评估者独立性的说法。
Dan Selsam 的 AI 风险声明
由 Daniel Kokotajlo 转推,是影响最大的安全帖之一。一位现职 OpenAI 研究人员主张,未来的模型能判断出自己什么时候在被测试,从而系统性地操纵对齐评估。
DeepSeek 内核工程师的反思
teortaxesTex 翻译并分享的一篇 DeepSeek 内核工程师随笔,引来大量关注。技术内容不是发布,但它捕捉到一个越来越重要的工程现实,专家们预期 AI 会自己吸收越来越多的底层优化手艺,把人类往监督和整合的方向挪。
围绕 Muse 的消费级 AI 势头
Sasha Kaletsky 和 Alexandr Wang 都在放大一种说法,Muse 是 ChatGPT 之后最大的消费级 AI 发布。据报道,日下载量在美国已经超过了 Threads、WhatsApp 和 Facebook。这些推文在技术细节上着墨不多,但用量信号是真的硬。