AI DAILY / 2026-09-16
智能体一次通过任务,下一次还会成功吗?
Your Agent Aced the Task. Will It Do It Again?
全文中文翻译 · AI 生成,仅供学习交流
你的智能体(Agent)出色完成了任务。下次它还会做到吗?
这在舞台上只是令人尴尬,但在生产环境中却是一个可靠性问题:某次成功的工作流,可能在用户再次发起同样请求时失败。对于关键任务(比如核对一笔金融交易,或检查一份合同中的义务),这可能是致命的。
大多数基准测试用平均值掩盖了这种波动性。在 AppWorld 上,一个使用 GPT-4.1 的 ReAct 智能体在五次重复中的平均成功率是 77.4%。但它仅在 53.0% 的任务上五次全部成功,存在 24.4 个百分点的"一致性差距"。
大多数基准测试只报告前一个数字。我们构建了一种方法来衡量后者,并加以改进。
在早些时候的一篇文章中,我们介绍了 ALTK-Evolve,一个将智能体自身过往轨迹转化为可复用准则的系统,准则会被自动蒸馏(distill)并在推理时注入回提示中。它能显著提升任务成功率,但那些结果问的也是平均情况。本文介绍一致性准则(consistency guidelines),这是 altk-evolve 中的一种新准则类型,建立在我们称之为一致性分析器(Consistency Analyzer)的诊断工具之上,直接瞄准这一差距。
TL;DR:准确率掩盖了不可靠性问题。
在 AppWorld test_normal 上,一个使用 GPT-4.1 的 ReAct 智能体平均成功率 77.4%,但在五次重复运行中仅 53.0% 的任务每次都成功,存在 24.4 个百分点的一致性差距。在困难任务上,这一差距达到 30 个百分点。
我们正是为此构建了一个诊断工具。
一致性分析器通过对智能体自身记录的轨迹进行重采样(resampling),找出"容易翻转的决策点",即那些模型距离做出不同选择只差一次采样(token sample)的步骤。它只需要一条轨迹,不需要真值标签,不需要端到端重跑任务,而是用单次调用在该轨迹的每个决策点请求 k 个补全(默认 k=5)。
把这一诊断转化为准则后,这一差距被砍掉一半,从 24.4 个百分点降到 12.0 个百分点(同任务 Pass⁵ 提升 +16.0pp,相近任务提升 +13.0pp),同时不损失任何平均准确率。
完整方法和评估见 arXiv 上的技术报告。
几乎没人报告的指标
标准的智能体评估报告的是 Mean@k:把基准测试跑 k 次,取通过率的平均值。k 通常是 3,有时只是 1。这是每个排行榜上的数字,也是"准确率 77%"在实际中的含义。
Mean@k 回答的是"这个智能体平均有多好?"它并不回答真实用户关心的问题:如果我再问一次同样的问题,它还会表现良好吗?
为此你需要 Pass^k:在所有 k 次运行中都成功的任务占比。
⚠️ Pass^k 不是 Pass@k。
大家熟悉的 Pass@k 是乐观的,它只问 k 次尝试中是否有一次成功,前提是你能验证并重试。
Pass^k 是它的悲观镜像:每次尝试都必须成功。同样的字母,相反的问题。恒有 Pass^k ≤ Mean@k ≤ Pass@k。
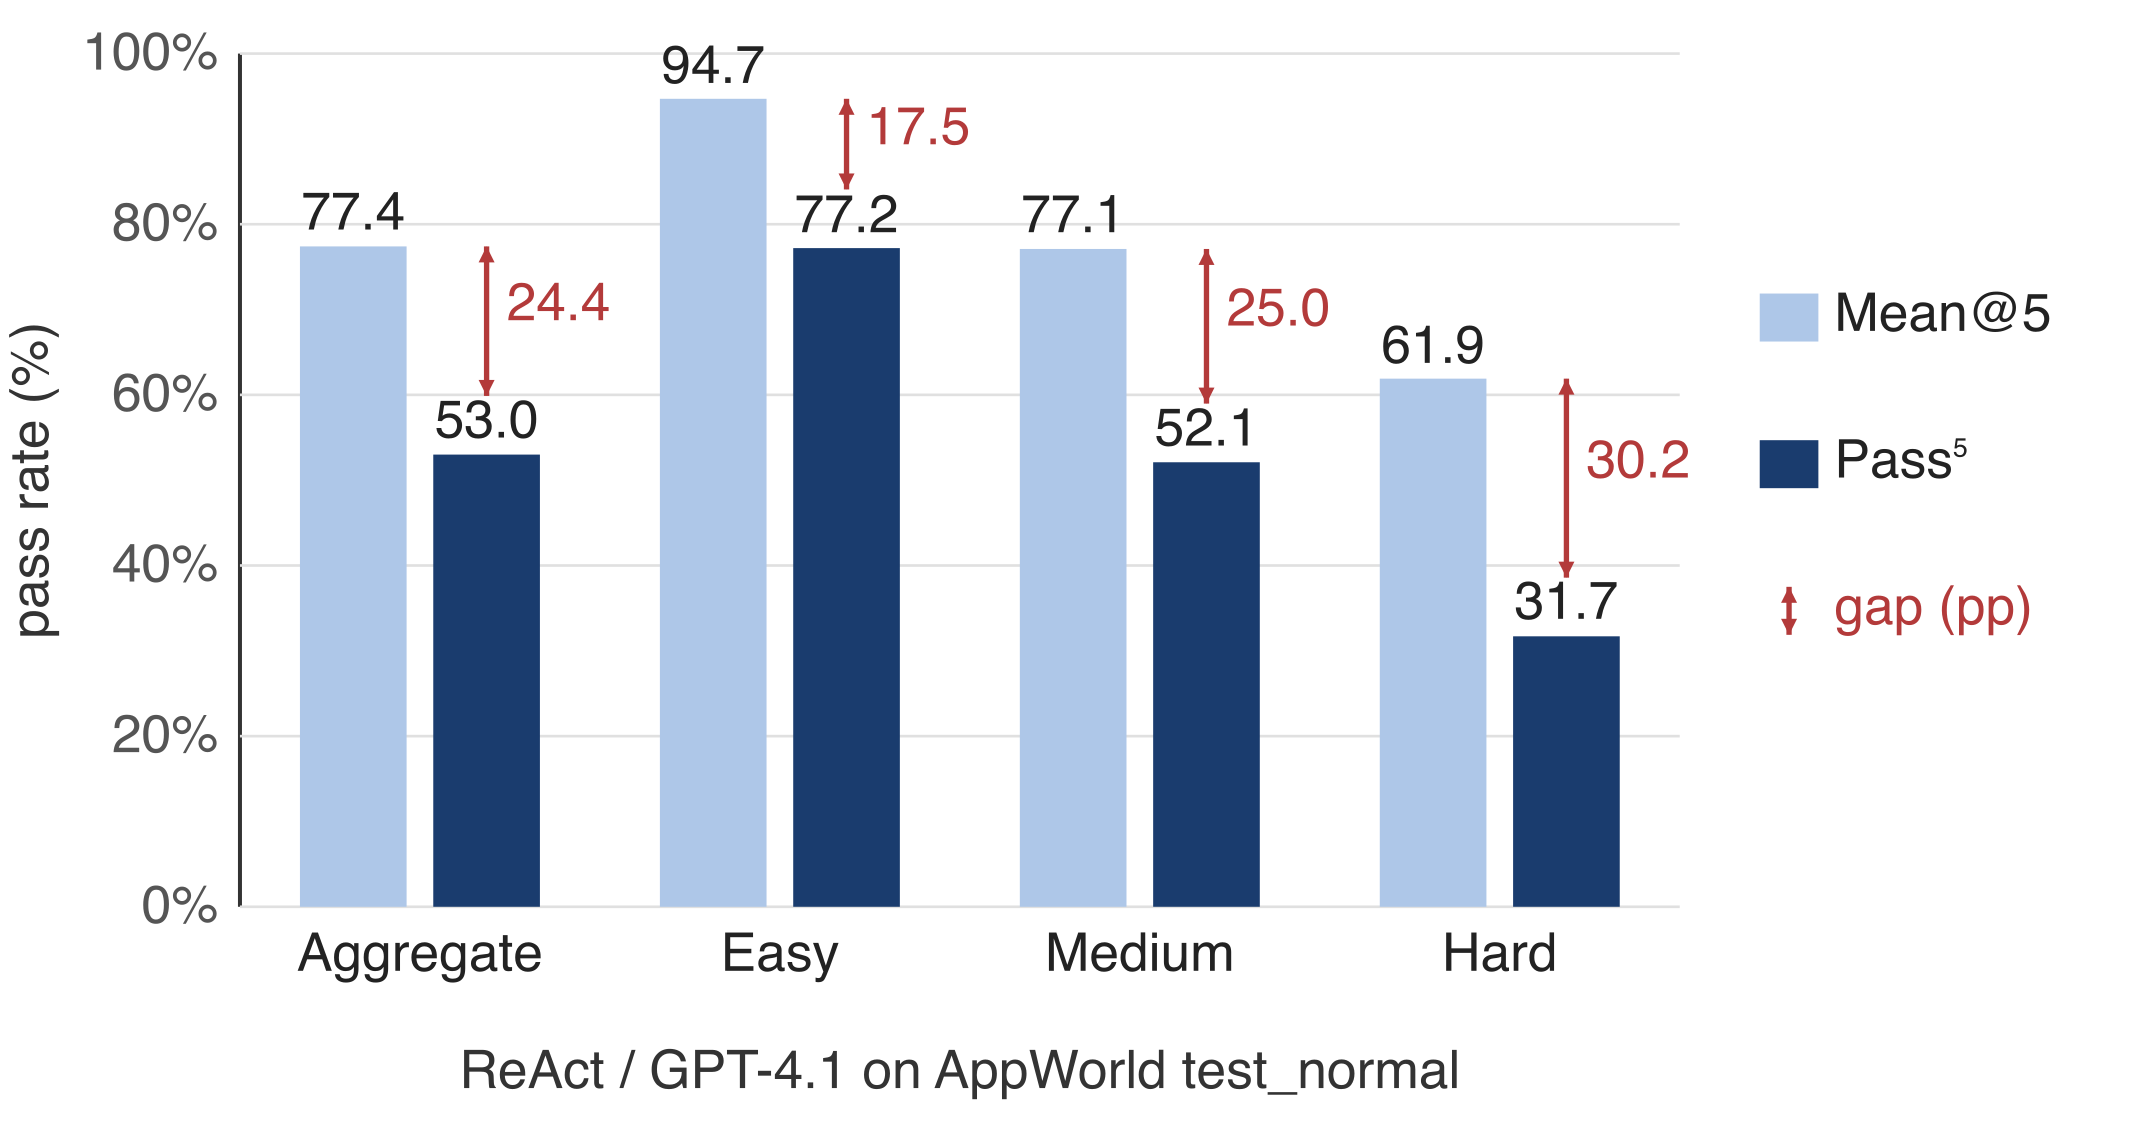
一个由 GPT-4.1 驱动的 ReAct 智能体达到了 77.4% 的 Mean@5,确实很强。但 Pass^5 只有 53.0%。将近四分之一的基准任务,智能体有时能解决、有时解决不了,而两次运行之间任务本身没有任何变化。我们把这一差距,Mean@k 减去 Pass^k,称为"一致性差距"。
这不是一个靠更大的模型就能解决的"能力"问题。它是一个正交维度:一个智能体可以同时具备能力却又不稳定。
智能体为什么会翻转:尖锐决策 vs. 平坦决策
每当一个基于大语言模型的智能体做出决定,调用哪个 API、传什么参数、是否重试,这个决定都来自对下一个 token 的概率分布。关键在于这个分布的形状。尖锐的分布把大部分概率质量集中在一个 token 上:候选项远远落后,每次运行都会做出同样的选择。平坦的分布则把相近的质量分散在几个势均力敌的 token 上,谁胜出几乎就像抛硬币。
形状决定了需要多大的噪声才能改变结果。尖锐的分布具有弹性,GPU 浮点运算的不结合性、请求批处理以及其他平台层面的因素会轻微扰动数值,但远远不足以改写一个明确的胜者。平坦的分布恰好对这种扰动很脆弱:势均力敌的选项在小扰动下可能重新排序。而由于一条轨迹由数十个决策串联而成,每一步微小的翻转概率会累积成某次运行跑偏的较大概率。24 个百分点的差距正是这样产生的。
这也是为什么这个问题无法靠解码设置来解决。贪心解码(greedy decoding)和固定种子(fixed seed)都只决定如何把分布转化为 token,它们对分布本身无能为力。在托管端点上,概率每次运行都会略有偏移,因此即使温度为零,同样的提示词、同样的模型,今天可能把一个势均力敌的局面推向一个方向,明天可能推向另一个方向。
我们的设置:ReAct 智能体以 temperature 0.0 运行,因此上述变异性都不是普通的随机采样带来的。
先诊断,再修复
这就把问题转化为一次搜索:在一条给定的轨迹中,哪些步骤是平坦的?找到之后又该怎么做?
一致性准则来自一条两阶段的流水线,嵌入 ALTK-Evolve 现有的机制中,靠一种新的源信号驱动准则的生成。
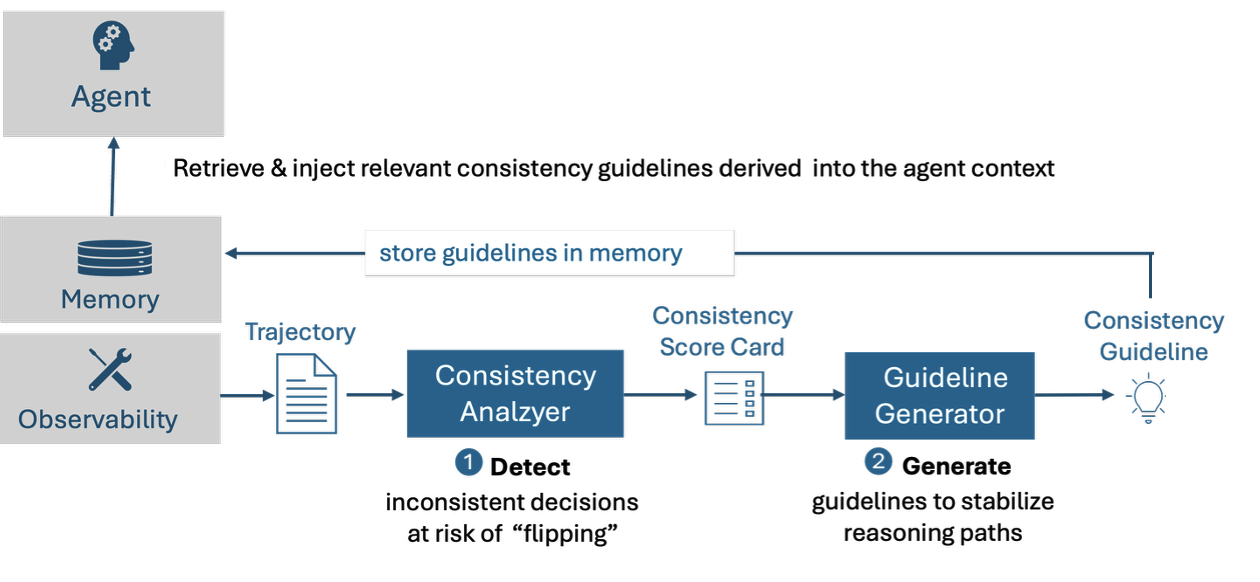
1. 检测,一致性分析器。给定一条已记录的轨迹,分析器通过受控的重采样回放每一个决策步骤,衡量模型在该点的输出实际波动有多大。具体来说,每个决策步骤额外调用一次模型,离线完成,一次性请求 k 个补全(默认 k=5),在已经记录好的上下文上回放,不触发新的工具调用,不产生新的环境交互,也不端到端重跑任务。这样得到每个决策步骤的一致性分数,写入一张评分卡(scorecard),精确定位哪些决策在下次运行中有翻转风险。检测完全黑箱,不需要 logits,不需要模型内部信息,除了你已有的那条轨迹之外不需要任何额外埋点。
2. 生成,针对性准则。每个被标记的步骤都会变成一条候选一致性准则,采用标准的 ALTK-Evolve 格式,从而接入已有的存储和检索流水线。下面是一个真实的例子,由 GPT-4.1 根据 AppWorld 任务"我的 SimpleNote 笔记中待办清单里完成了多少项活动?"的一条轨迹生成:
[Guideline 1] When counting checkbox-style markers in note content, use a line-anchored regex match rather than a plain substring count — note titles often repeat the marker symbol in a legend line.

[Guideline 2] Always verify search results for note queries by checking for multiple matches and confirming the correct note before proceeding.
这里没有任务专属的细节。字符串计数的 bug 和未经验证的搜索结果,是许多 AppWorld 任务中都会以高不确定性出现的决策点。这正是重点:分析器瞄准的是不稳定性,而非失败,它捕捉的是那些智能体这次恰好做对、下次很容易做错的步骤。
观看这段 2 分钟的演示,同一任务上,智能体的五次并行运行因为计数策略上的不确定性以 3:2 分裂,加入这些准则后再跑一次:五次全部达成一致。
结果:在不损失准确率的前提下缩小差距
我们在 AppWorld test_normal(168 个任务)上使用基于 GPT-4.1 的 ReAct 智能体进行评估,从每个任务的一条基线轨迹生成一致性准则,并在 5 次全新运行上进行测试。
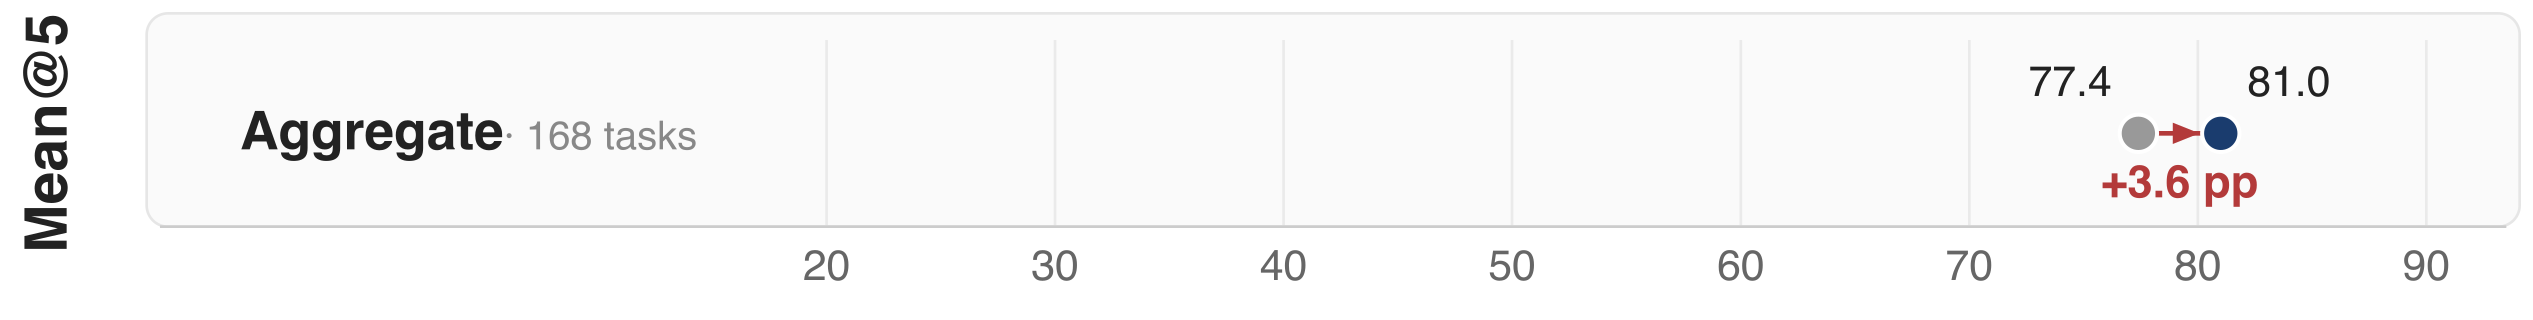
Mean@5(%),汇总,与上文 Pass^5 的尺度相同。
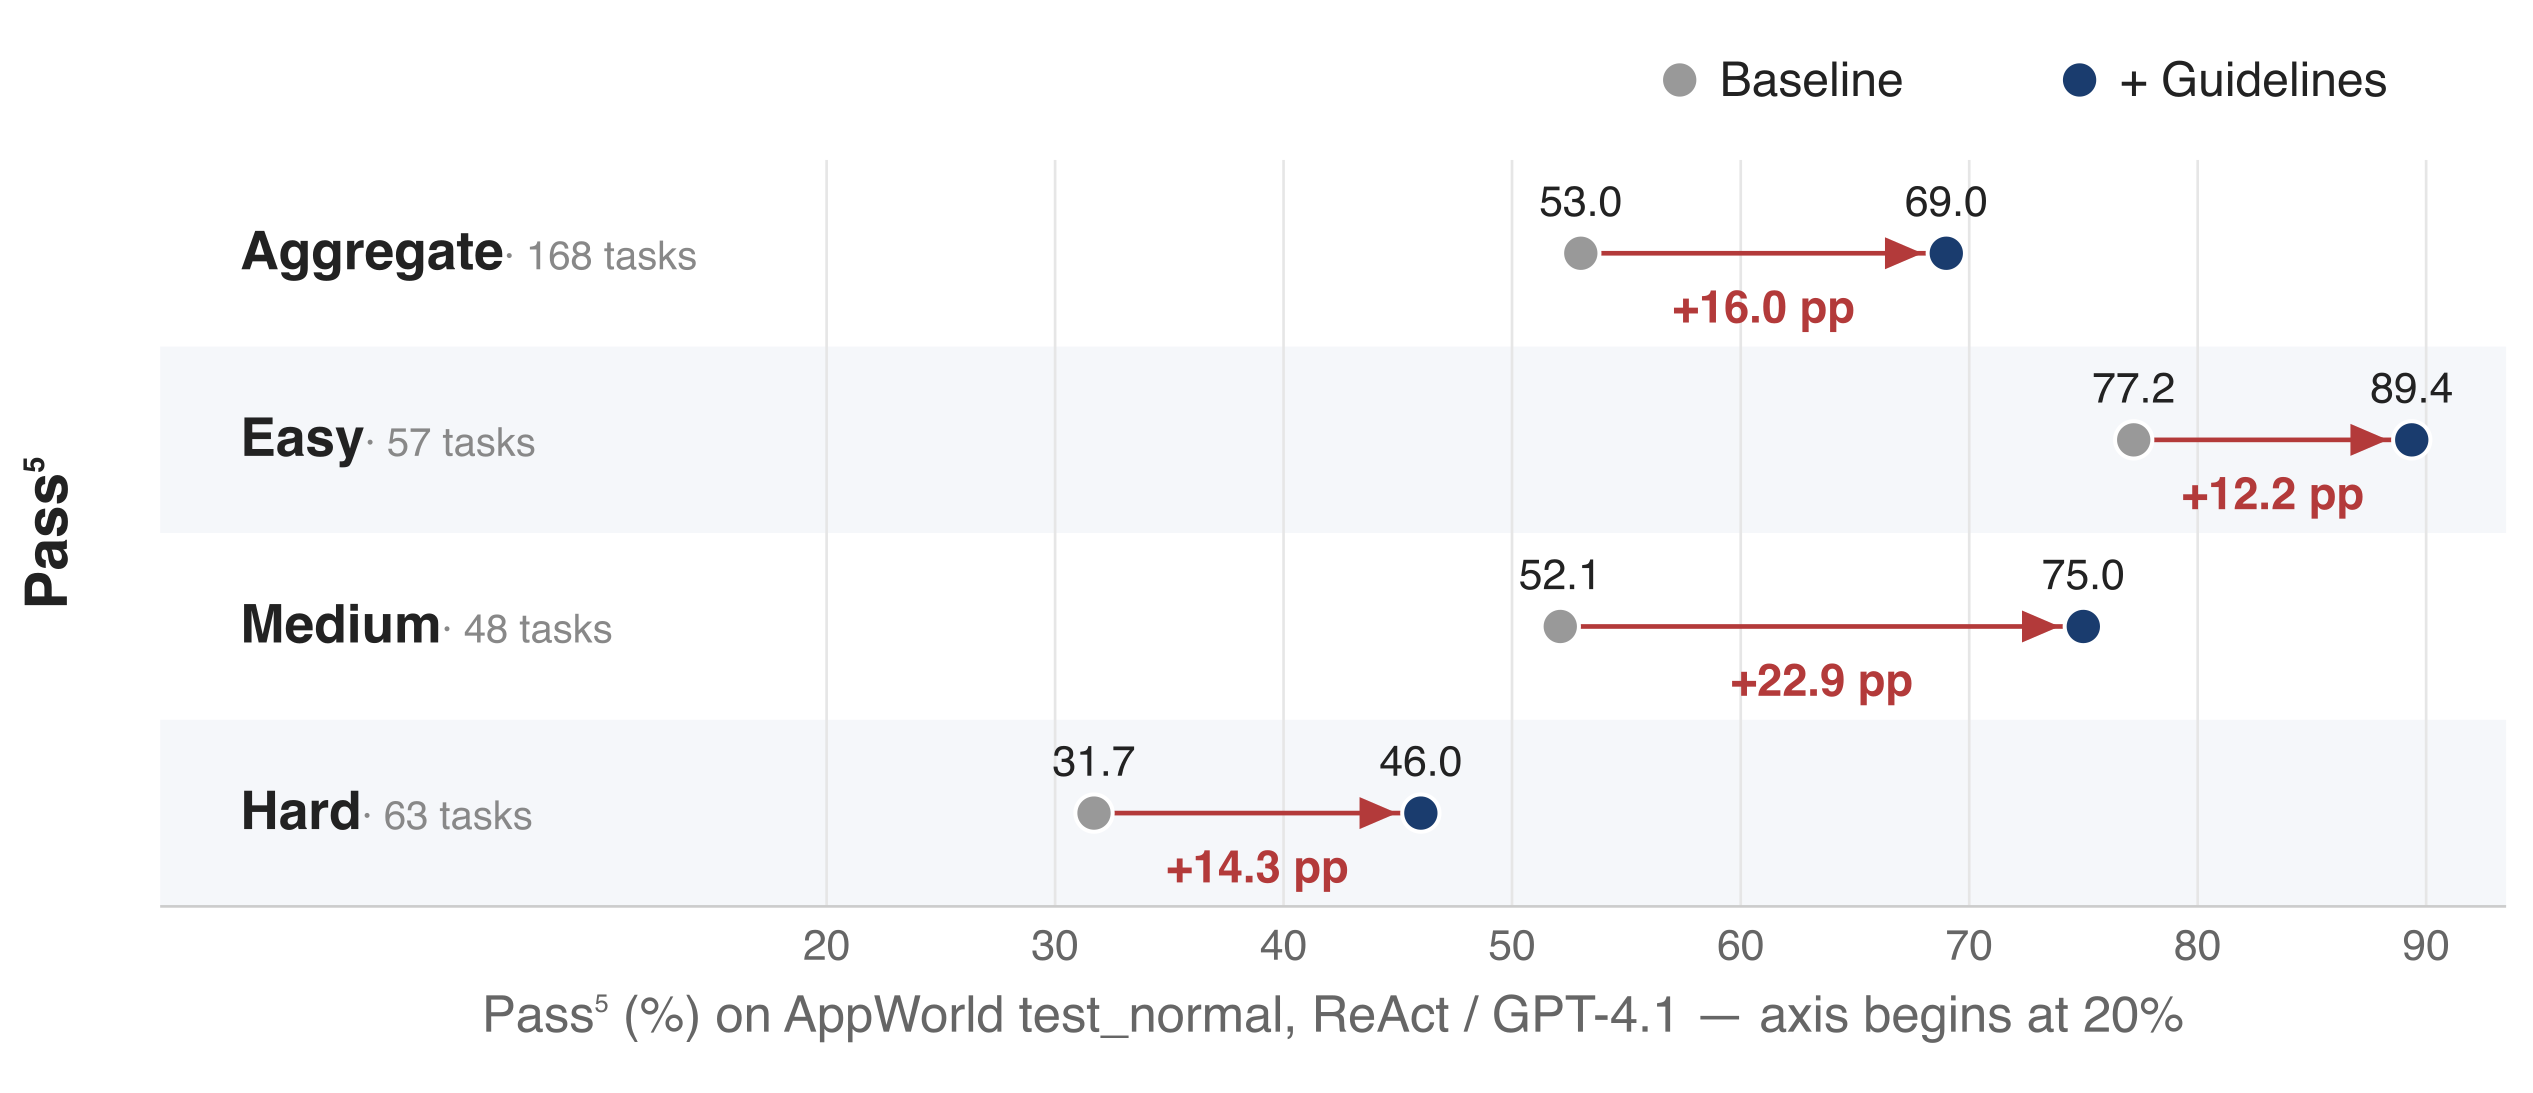
一致性差距被大致砍掉一半。汇总 Pass^5 从 53.0% 提升至 69.0%,同时 Mean@5 从 77.4% 提升至 81.0%,把"看起来有本事"与"靠得住"之间的差距从 24.4 个百分点收窄到 12.0 个百分点。将近三分之一原本不一致的任务,变成了智能体每次运行都能通过的任务。
中难和困难难度受益最大。中等难度 +22.9pp(相对 +44%),困难难度 +14.3pp(相对 +45%),相对幅度几乎持平,中等难度绝对值领先。简单难度 +12.2pp,因为它本来就没什么提升空间。这正是一致性准则被设计来做的事情:找出并稳定那些智能体自身不确定性正在渗透到结果中的具体决策点。
Mean@5 从未下降。保持平均准确率是一条硬性要求,而非锦上添花:一个用 Mean@5 换取 Pass^5 提升的系统,只是把不可靠性挪了个位置,并没有真正修复它。在每个难度等级上,平均准确率都保持不变或有所提升。
准则可以泛化,它们不是补丁某条轨迹。把准则用到同一 AppWorld 场景中另一个相关但不同的任务,也就是从中挖掘准则的那个场景的另一个变体,Pass^5 仍提升了 +13.0pp,仅比同任务结果低 3 个百分点。从一次运行中提炼出的准则不仅仅是给那一次运行打补丁;它捕捉到了某种可以迁移的东西。
更锐利的证据来自一个较弱的模型 gpt-oss-120b。同任务 Pass^5 从一个低得多的基线(10.1% → 16.1%)上升了 +6.0pp,有意思的是,相近任务的泛化幅度(+8.7 pp)甚至超过了同任务增益,这说明准则捕捉到的确实是真正可复用的失败模式,而不是记忆了某条轨迹的细节。
如果你正在上线一个智能体
在 Mean@k 旁边报告 Pass^k。平均值无法区分一个可靠的智能体和一个幸运的智能体;即使 k=3 也会暴露出你不知道的差距。
预期差距会随难度增大。你的最困难难度等级上,单一平均值最具有误导性。
先别急着换更大的模型。一致性与能力是正交的。更强的模型会抬高 Mean@k,却未必能缩小一致性差距。
诊断不需要打分器,也不需要在线重放。每个决策步骤额外调用一次大语言模型(默认采样 k=5 个补全)就够了,不需要真值标签,不需要把任务对着环境重跑一遍。这正是它可以用于生产流量的原因:在生产环境中,你往往连一次端到端重放都做不到。
试一试
试用 ALTK-Evolve 工具包,开源仓库现在已经包含了这些实验中用到的一致性分析器和一致性准则生成功能,或者阅读 arXiv 上的技术报告,了解完整的方法论。
如果你对自己任务上的准确率数字无法复现这件事深有感触,我们很乐意听听,你自己智能体中那些容易翻转的行为的具体例子,正是塑造我们下一步工作方向的反馈。