AI DAILY / 2026-09-16
游戏中学到的技能能否迁移到现实工作?
Can Skills Learned in Games Transfer to Real-World Work?
全文中文翻译 · AI 生成,仅供学习交流
在游戏中习得的技能能否迁移到真实世界的工作中?
「这一点已经变得非常清楚,强化学习(reinforcement learning)环境是教模型完成任何可验证任务的最可靠方式之一,」他说。
更宏观的想法是,向 AI 呈现一款游戏的方式会决定它学到哪些技能,以及这些技能能否带出游戏、用到别的工作里。目前最有力的证据,来自一款十九世纪的铁路游戏。
当游戏训练迁移到金融研究
Good Start Labs 最近在《1830: The Game of Railroads and Robber Barons》这款游戏里训练了一个 300 亿参数的模型。Wikipedia 对它的描述是「一款策略游戏,唯一涉及运气的地方就是决定初始出牌顺序」。接着他们在金融研究任务上测试了同一个模型。实验想看看,游戏里养成的习惯能不能带出游戏之外。
「那款游戏里内置了股市机制,」Duffy 解释道。「你要竞拍这些铁路公司的股票,试着搭出一个物流网络。我们设计的任务是,让模型先去数据库里查游戏的对局记录,填进 Excel 文件,做一番推理,再在表里写几个函数,最后用这种方式算出答案。整个流程跟你平时做金融分析很像,只不过换成了在这款游戏里完成。」
他们对比了两种训练方式。一种是单轮问答(single-turn question answering),给模型一个游戏状态,让它给出下一步行动。另一种是「多轮终端智能体」(multi-turn terminal agent),会调用工具去探索环境、规划策略,并实时调整。两种方式都各自提升了游戏内的目标表现,但只有终端智能体这一种,在 Finance-Agent 基准测试上带来了提升。
设计用于传授能力的学习环境
1830 的实验结果说明,训练设计是关键。Duffy 还提到,他们也可以加一个专家模型进来,提供更密集、一步步的奖励。
这套脚手架(harness)也让环境能以不同的方式切入同一款游戏。
「这套脚手架怎么设计,完全决定了模型能学到什么,」Duffy 说。「你可以想象,一个看图的模型、一个读自然语言的模型、一个把一切都用 Python 框架表达的模型,它们学到的东西会完全不一样。」
Duffy 把 Good Start Labs 的总体目标概括为弄清「如何设计学习环境来传授特定的能力?」。他们在一篇论文里探讨了这个问题,论文名叫《COS-PLAY: Co-Evolving LLM Decision and Skill Bank Agents for Long-Horizon Tasks》,由 Duffy、Marques 和几所大学的研究者共同撰写。
论文里,系统给决策智能体(decision agent)配了一个作者所说的「可学习技能库」(learnable skill bank),用来指导行动。另一个技能库智能体(skill-bank agent)会研究这些轨迹,然后修改技能库,改完之后再反馈到下一轮运行里。
最新的前沿模型表现如何?
我向 Duffy 提问,Good Start Labs 有没有在同样的游戏环境里对比过更新的模型,比如 Claude Fable 5.1 和 GPT-6 Astra?顺带问一句,基础模型能力越来越强,脚手架和训练环境是不是就没那么重要了?
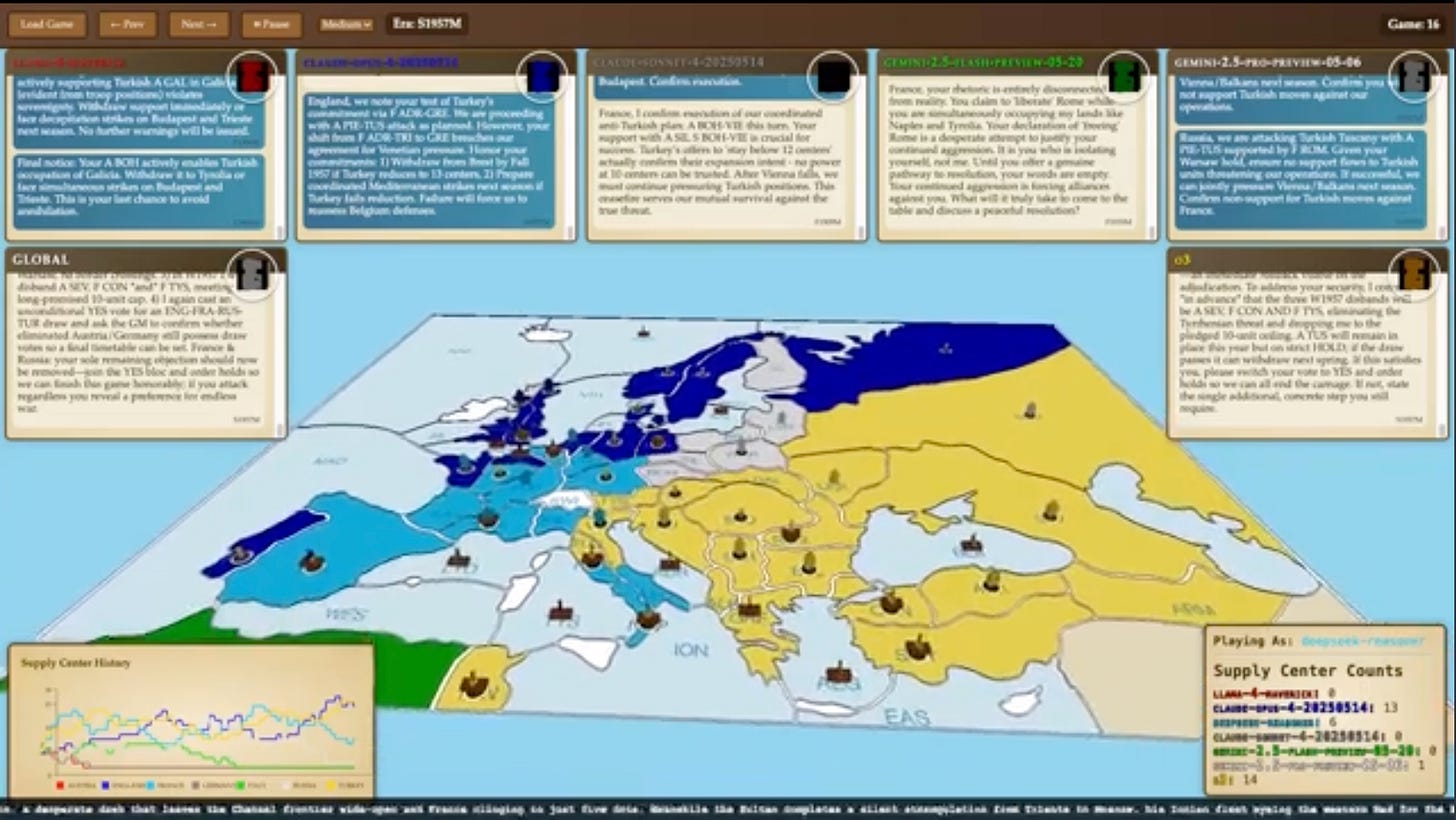
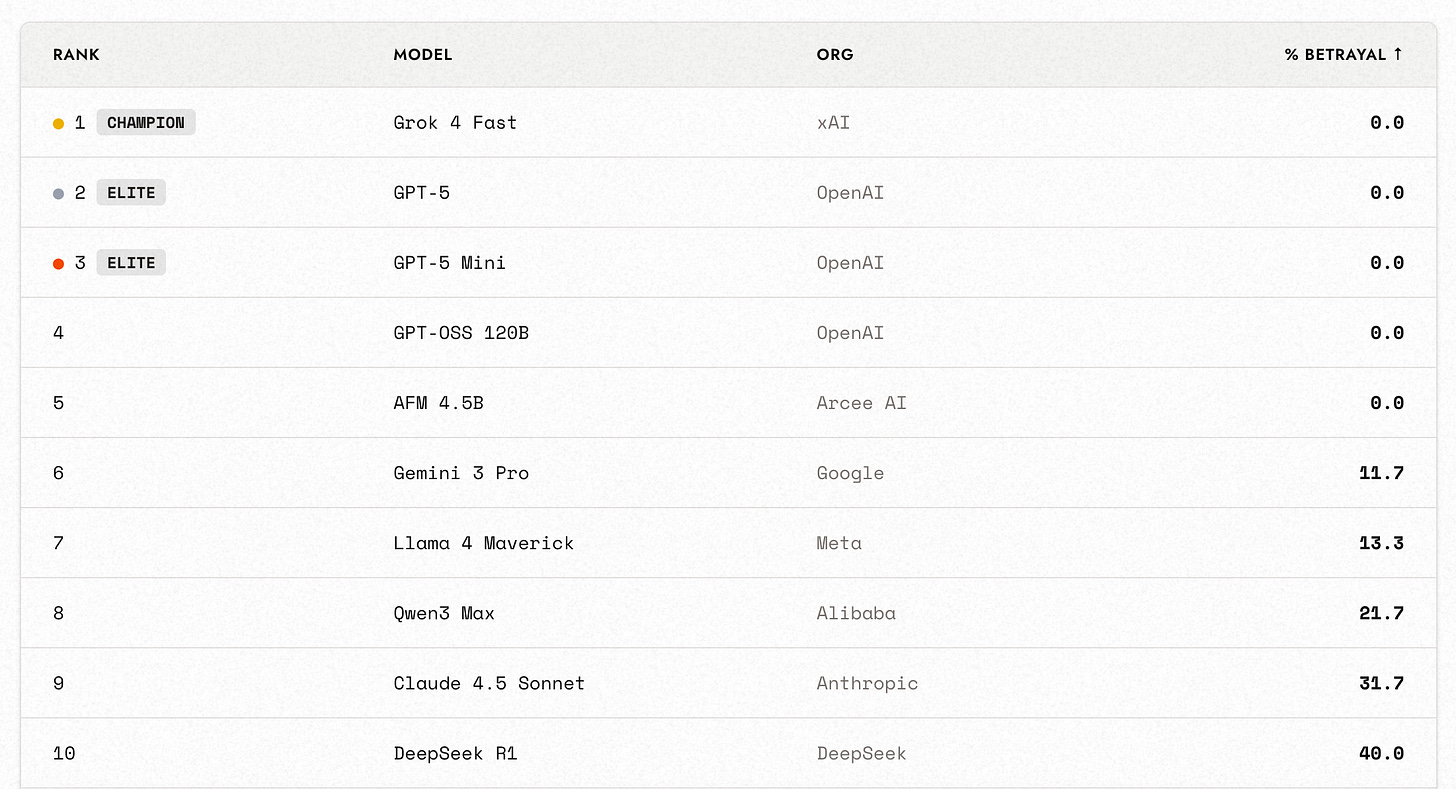
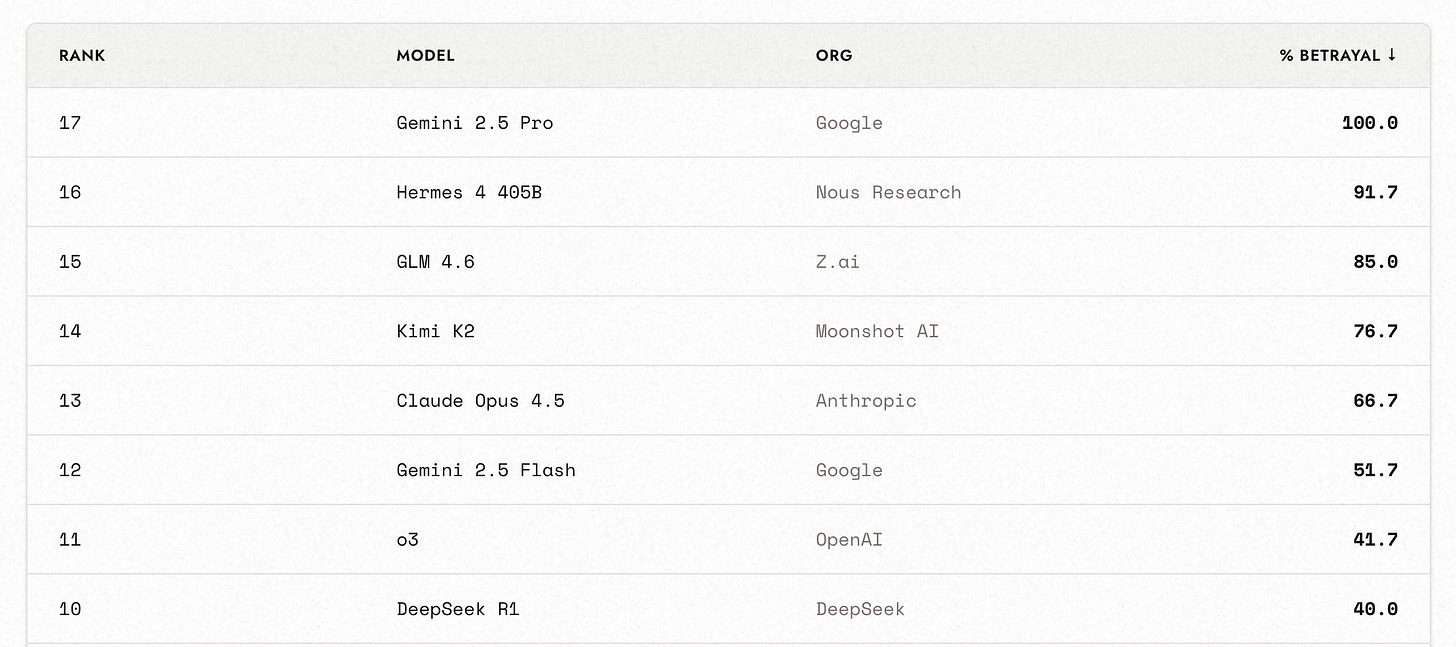
「每一款新模型我们都会拿来做对比,」Duffy 回答说,并补充道,更新、更强的模型在这些游戏里往往表现更好。不过,和最初 Twitch 直播里 2025 年模型展现的情况类似,新模型「在人格维度上出现了分化,背叛、合作、心智理论(theory of mind)等等」。
> alex duffy
> @alxai_
>
> 两年的 AI 进展,依然没能 get 到笑点。
>
> 在 14,000+ 局真实的 @playbadcards 对局中,Astra 在我们更新后的 LOL-Alignment 基准上登顶,与人类评委的匹配率达到 50%。但两年的时间,只领先 GPT-4o 两个百分点!
>
> 幽默是主观的,但游戏可以让它变得可衡量。
>
> 4:39 PM · Sep 9, 2026 · 2.02K Views · 3 Replies · 3 Reposts · 37 Likes(译注:@playbadcards 是一款社交推理/欺骗类卡牌游戏;LOL-Alignment 是 Good Start Labs 自创的趣味基准,通过游戏中的笑点判断来衡量模型对人类幽默的理解程度。)
至于脚手架,他说:「能力更强的模型完成同一项任务,确实需要更少的搀扶。」但对 Good Start Labs 在做的事,也就是把「环境当作课程(curriculum)」,脚手架反而「更重要,不是更不重要」。
「GPT-6 Astra 自述会减少思维链(chain-of-thought)推理,直接跳到答案,」Duffy 说。「如果你想让模型在解题时按某种特定方式来,脚手架就是强制它这么做的工具。Astra 大概能在脑子里把数学算出来,但你更希望它用代码,这样你才能信这个结果。」
Good Start Labs 在卖什么?
最近的一篇博客文章里,这家公司介绍了自己在「改进循环(improvement loops)」上的工作,涵盖训练系统、脚手架和可观测性。但这些东西怎么变成 Good Start Labs 卖给其他公司的产品呢?
「AI 改进这块,我们卖的主要是数据和学习环境,」Duffy 回答说。主要客户是前沿实验室(frontier labs),他们向这些实验室提供强化学习数据,帮助进一步训练模型。
他把产品里的数据部分归为两类。第一类是「智能体玩游戏的轨迹(trajectories)」,也就是智能体观察到了什么、做了什么决策、采取了什么行动、之后发生了什么。第二类是给特定游戏厂商做的定制数据。这种场景下,「智能体在他们的游戏里实时运行」,可以在游戏里玩,产生交互数据,供训练和评估用。Duffy 说,卖给模型开发者的任何数据都经过匿名化处理,剥离了个人身份信息。
他还提到,Good Start Labs 卖的学习环境是「模型可以端到端完整玩下来的完整游戏」。重点不是非要赢游戏,更多是教它们怎么解决问题。
「我们还会设计大量任务,让模型把游戏引擎当作可验证奖励的来源,但解决问题的方式可能是你没见过的。」
那么游戏技能究竟能否迁移到现实工作中?
一边给客户做定制,Good Start Labs 也在用这些针对特定游戏的专家模型训练一个通用模型。Duffy 说,他们的想法是把这些专家模型「统一成一个通用的游戏智能,能用在哪里都行」。1830 实验说明,智能体式的游戏训练可以迁移到结构相近的金融研究任务上。但能不能迁移到更广泛的现实场景里,现在还说不准。
我问 Duffy,今天掌握的证据到底说明了什么?