AI DAILY / 2026-09-17
Weaviate 1.39推出4位旋转量化
4-bit Rotational Quantization
全文中文翻译 · AI 生成,仅供学习交流
4-bit Rotational Quantization
(或 RQ),并提供 8-bit 和 1-bit 两种位宽。这些量化技术能够在降低内存占用的同时实现快速向量搜索,并且相比标量量化和二值量化等替代方案具有更好的召回率。
Weaviate 1.39 扩展了 RQ,新增对 4-bit 的支持,并附带一整套量化改进。旋转、距离核(distance kernel)、编码以及内存路径都得到了改进,综合效果如下:1.39 中的 8-bit RQ 显著更快,4-bit RQ 在召回率相当的情况下将堆内存(heap)占用减少了 45%。
本文记录了这些工作的来龙去脉,并在此过程中回答两个常见问题:RQ 在数据集规模扩大时的表现如何?RQ 与 TurboQuant 相比又如何?
改进
旋转量化基于 Extended-RaBitQ,并采用结构化的快速旋转以及简化的逐向量区间拟合(interval fitting),以加快编码速度。快速编码性能(即将原始向量转换为量化表示的过程)是优秀量化算法的重要组成部分,因为它会显著影响导入性能。
这些方法的第一步是将原始向量乘以一个随机旋转矩阵(random rotation matrix)。这看起来可能违反直觉,但随机旋转矩阵能让向量具备更好的性质,尤其是把各个维度的值分散到整个量化区间(quantization interval)的长度上。
为了加速随机旋转,我们使用快速沃尔什-哈达玛变换(Fast Walsh-Hadamard Transforms,FWHT)来旋转原始向量。在 1.39 中,我们为 FWHT 新增了 SIMD 支持,并在与 Go 参考实现位完全一致(bit-identical)的前提下获得了以下加速:
Transform          CPU                                 1.38 (Go)   1.39 (SIMD)   Speedup
FWHT64             Intel Xeon 8581C (amd64/AVX)        81.3 ns     26.5 ns       3.1×
FWHT256            Intel Xeon 8581C (amd64/AVX)        515 ns      84.5 ns       6.1×
FWHT64             Apple M1 (arm64/NEON)               67.4 ns     21.6 ns       3.1×
FWHT256            Apple M1 (arm64/NEON)               428 ns      96.2 ns       4.5×
再加上对 SIMD 编码核(encode kernel)的一些其他增强,整个 RQ 系列的编码性能得到了以下总体提升:
Quantizer            CPU                                 1.38        1.39        Speedup
RQ8                  Intel Xeon 8581C (amd64/AVX)        27.3 µs     7.11 µs     3.8×
RQ1                  Intel Xeon 8581C (amd64/AVX)        15.2 µs     6.84 µs     2.2×
RQ4 (uncentered)     Intel Xeon 8581C (amd64/AVX)        —           6.36 µs     new in 1.39
RQ4 (centered)       Intel Xeon 8581C (amd64/AVX)        —           8.08 µs     new in 1.39
RQ8                  Apple M1 (arm64/NEON)               14.7 µs     6.18 µs     2.4×
RQ1                  Apple M1 (arm64/NEON)               13.0 µs     6.18 µs     2.1×
RQ4 (uncentered)     Apple M1 (arm64/NEON)               —           5.65 µs     new in 1.39
RQ4 (centered)       Apple M1 (arm64/NEON)               —           7.00 µs     new in 1.39
距离核
距离核通过使用 SIMD 半字节(nibble,即半个字节)函数适配到了 4-bit。我们还在可能的情况下切换到了 UDOT(arm64)和 VPDPBUSD(amd64)字节点积(byte dot)函数,这也提升了 8-bit 量化的性能。注意 8-bit 和 4-bit 的距离函数很相似,但对内存带宽的影响则大不相同,这一点将在下一节解释。
单次 query→code 距离计算(余弦),1.38 vs 1.39:
Kernel               CPU                                   1.38       1.39       Speedup
RQ8                  Intel Xeon 8581C (amd64/AVX2)         34.3 ns    16.6 ns    2.1×
RQ8                  Intel Xeon 8581C (amd64/AVX2)         42.8 ns    19.8 ns    2.2×
RQ4 (uncentered)     Intel Xeon 8581C (amd64/AVX2)         —          16.0 ns    new in 1.39
RQ4 (uncentered)     Intel Xeon 8581C (amd64/AVX2)         —          17.7 ns    new in 1.39
RQ4 (centered)       Intel Xeon 8581C (amd64/AVX2)         —          21.9 ns    new in 1.39
RQ4 (centered)       Intel Xeon 8581C (amd64/AVX2)         —          23.4 ns    new in 1.39
RQ8                  Apple M1 (arm64/NEON)                 24.9 ns    17.0 ns    1.5×
RQ8                  Apple M1 (arm64/NEON)                 31.1 ns    20.0 ns    1.6×
RQ4 (uncentered)     Apple M1 (arm64/NEON)                 —          17.8 ns    new in 1.39
RQ4 (uncentered)     Apple M1 (arm64/NEON)                 —          21.0 ns    new in 1.39
RQ4 (centered)       Apple M1 (arm64/NEON)                 —          24.5 ns    new in 1.39
RQ4 (centered)       Apple M1 (arm64/NEON)                 —          27.0 ns    new in 1.39
预取与内存访问
要把距离核做到 30ns 以下,还需要向量能被 CPU 缓存有效缓存。由于图 ANN 索引(graph ANN index,例如 HNSW)的 DRAM 访问是分散的,内存带宽往往是性能的主要瓶颈,而不是距离计算本身。
为了在 1.39 中改进这一点,我们为 AMD64 和 ARM64 架构都加入了高效的预取(prefetching)机制(并修复了一个存在多年的 AMD64 预取 bug)。预取通过向处理器提示接下来将使用哪些向量来提升性能。在 HNSW 扩展并计算邻居距离的过程中,我们现在会在一批向量距离计算之前进行预取或提示。
在一个 1M 向量索引上(d=1536,约 800 MB 的压缩码,远超 CPU 缓存容量),仅移除预取提示的 A/B 对比显示,预取提示贡献了 7–11% 的查询吞吐量(随 ef 增大而增长)以及 12% 的导入速度提升。
中心化与离群值
在整条流水线达到硬件速度上限之后,我们开始寻找 4-bit 的召回率提升空间。其中一个未解决的事项是中心化(centering),我们知道它能提升许多嵌入数据集的召回率。中心化利用了许多嵌入具有非零均值向量(mean vector)这一事实。我们在向量子集上计算这个均值 μ,然后在压缩时把 x − μ 针对一个拟合的均值进行编码,查询时用相同的均值进行中心化,最后再把交叉项(cross-term)补回。
在许多数据集上,中心化带来了显著的召回率提升,多个数据集的 recall@10 提高了 +0.1 到 +6.1 个百分点,因为嵌入往往呈现出各向异性(anisotropic),尤其是 late-interaction 模型(译注:late-interaction 模型指 ColBERT 类在表示层之后才进行交互的检索模型)。然而一些嵌入模型会通过正则化去除这种均值,因此我们通过 centering=true 标志位将这一功能设置为可选启用(opt-in)。
此外,在量化一个向量时,最极端的旋转坐标会给该向量的每个维度都带来量化噪声。通过精确存储(不量化)幅值最大的两个坐标,我们在中心化的基础上又额外获得了 +0.2 到 +1.7 个百分点的召回率提升;并且通过精心打包元数据字节,我们发现可以将其存放在我们已有的 16 字节标准元数据头(metadata header)中。
结果
召回率
下表展示了每种量化方法可达到的 recall@10。该表展示的是排除 ANN 索引的暴力召回率,以单独隔离量化本身的影响。
Dataset                                   RQ4 recall@10 / rescored@20   RQ4c recall@10 / rescored@20   RQ8 recall@10 / rescored@20
dbpedia-ada002-1536-1M (cosine)           93.5 / 100.0                  96.8 / 100.0                   99.0 / 100.0
sphere-dpr-768-1M (dot)                   90.9 / 99.4                   96.3 / 100.0                   98.2 / 100.0
sift-128-1M (l2)                          81.4 / 97.2                   87.5 / 99.3                    96.7 / 99.9
glove-100-1.2M (cosine)                   87.0 / 99.2                   89.9 / 99.8                    98.5 / 100.0
dbpedia-cohere-v2-4096-500k (dot)         98.1 / 100.0                  98.5 / 100.0                   99.9 / 100.0
msmarco-arctic-embed-m-768-1M (cosine)     94.7 / 100.0                  95.8 / 100.0                   99.3 / 100.0
nfcorpus-mlateon-mv-128 (maxsim)          72.0 / 88.6                   94.1 / 99.9                    93.4 / 99.9
scifact-mlateon-mv-128 (maxsim)           77.7 / 94.0                   94.5 / 100.0                   94.9 / 100.0
接下来更重要的是,我们在 Weaviate 中使用 HNSW 索引展示了召回率与查询性能的关系:
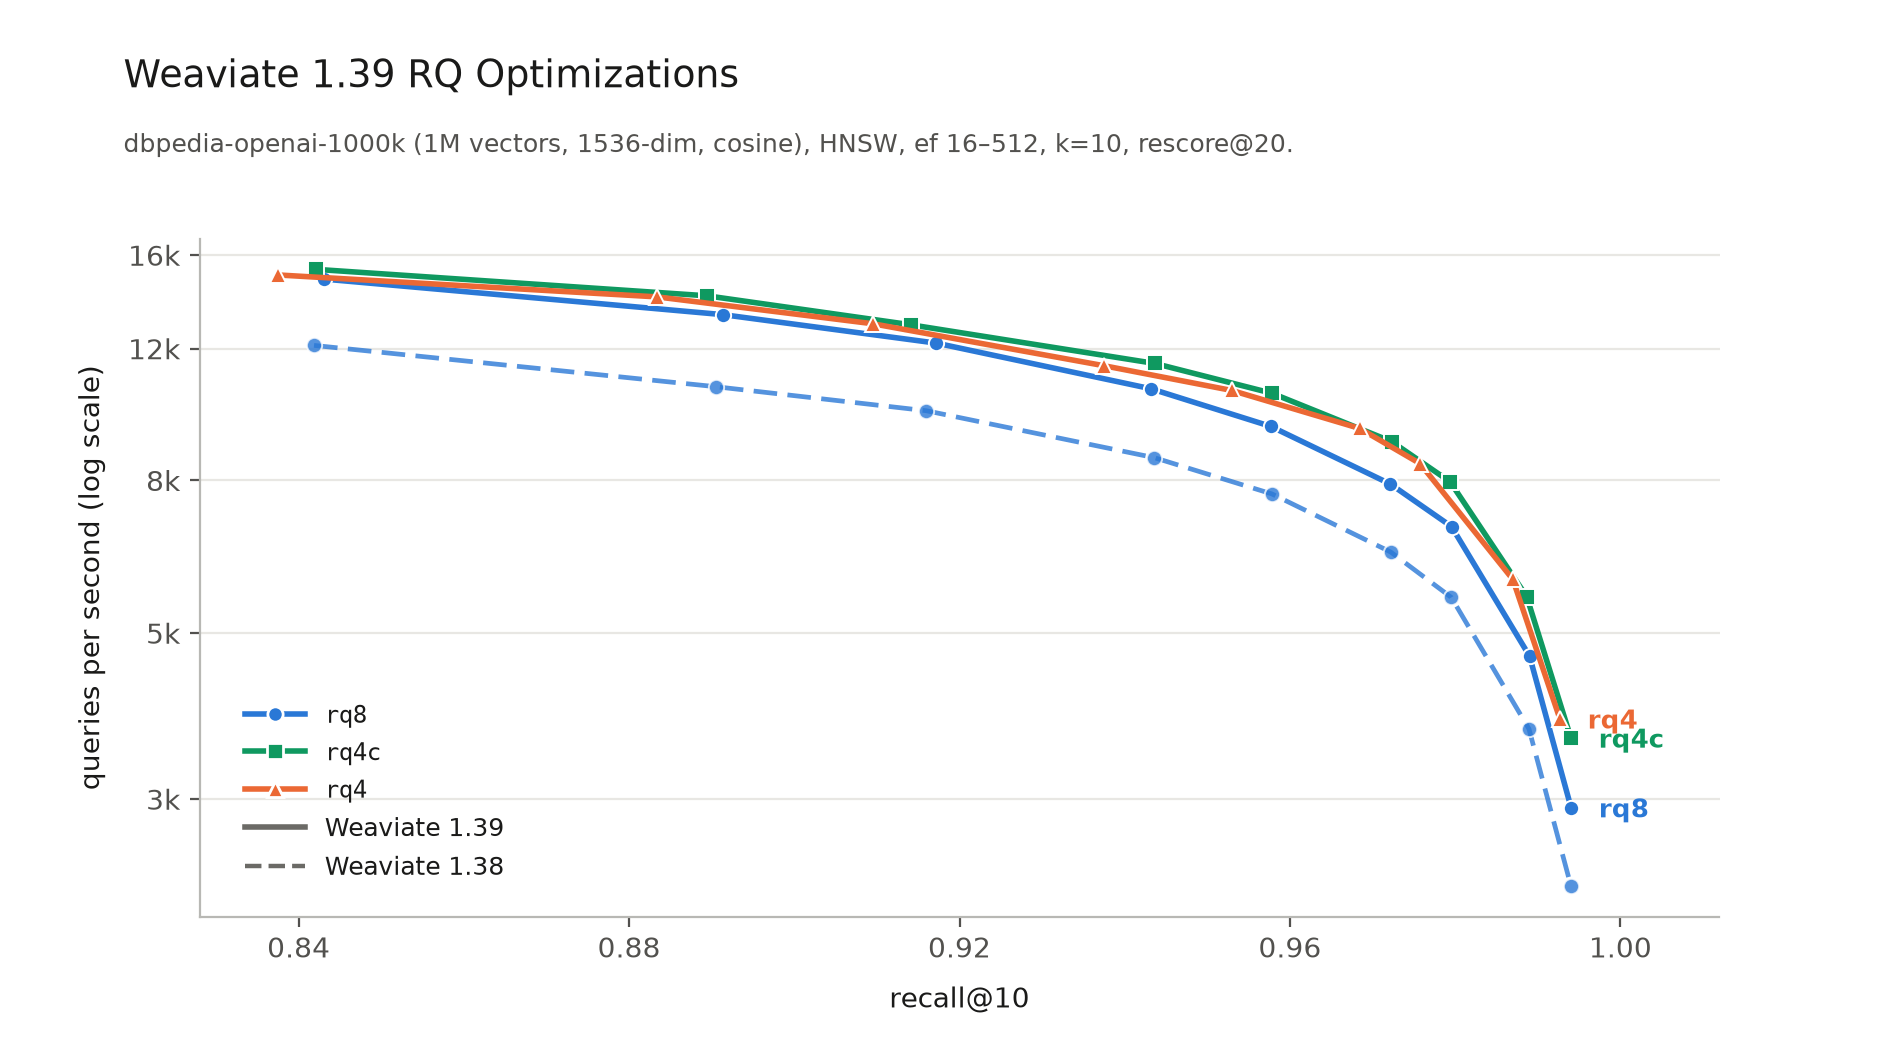
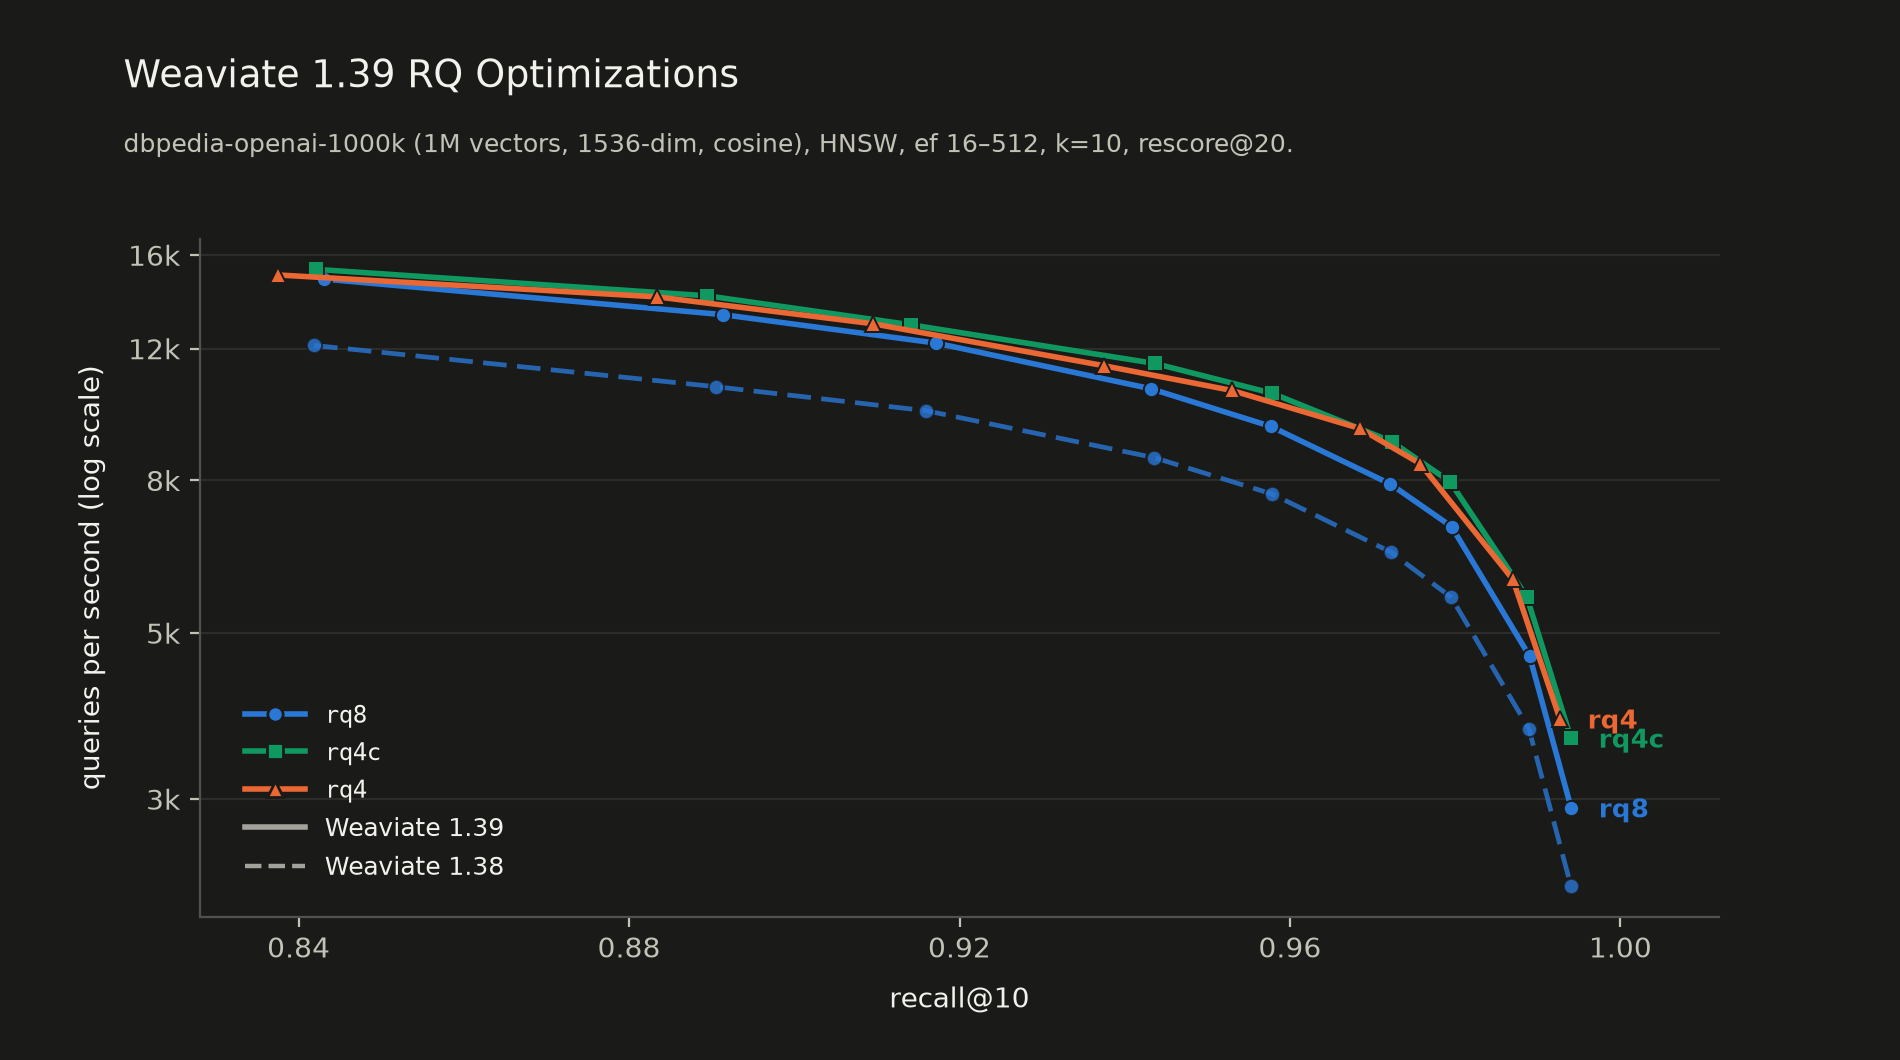
可以非常明显地看到相同 8-bit 量化器在 1.38 到 1.39 之间的性能跃升。此外,4-bit 的性能-召回率曲线在占用显著更少内存的同时超越了 8-bit。
下面是在 1536 维向量数据集上的堆内存影响。注意你并不会看到内存占用减半(只有 45%),因为 HNSW 图的元数据(主要是打包的连接信息)同样占用内存。作为参考,未量化存储该数据集需要 5.7 GiB 加上图元数据。
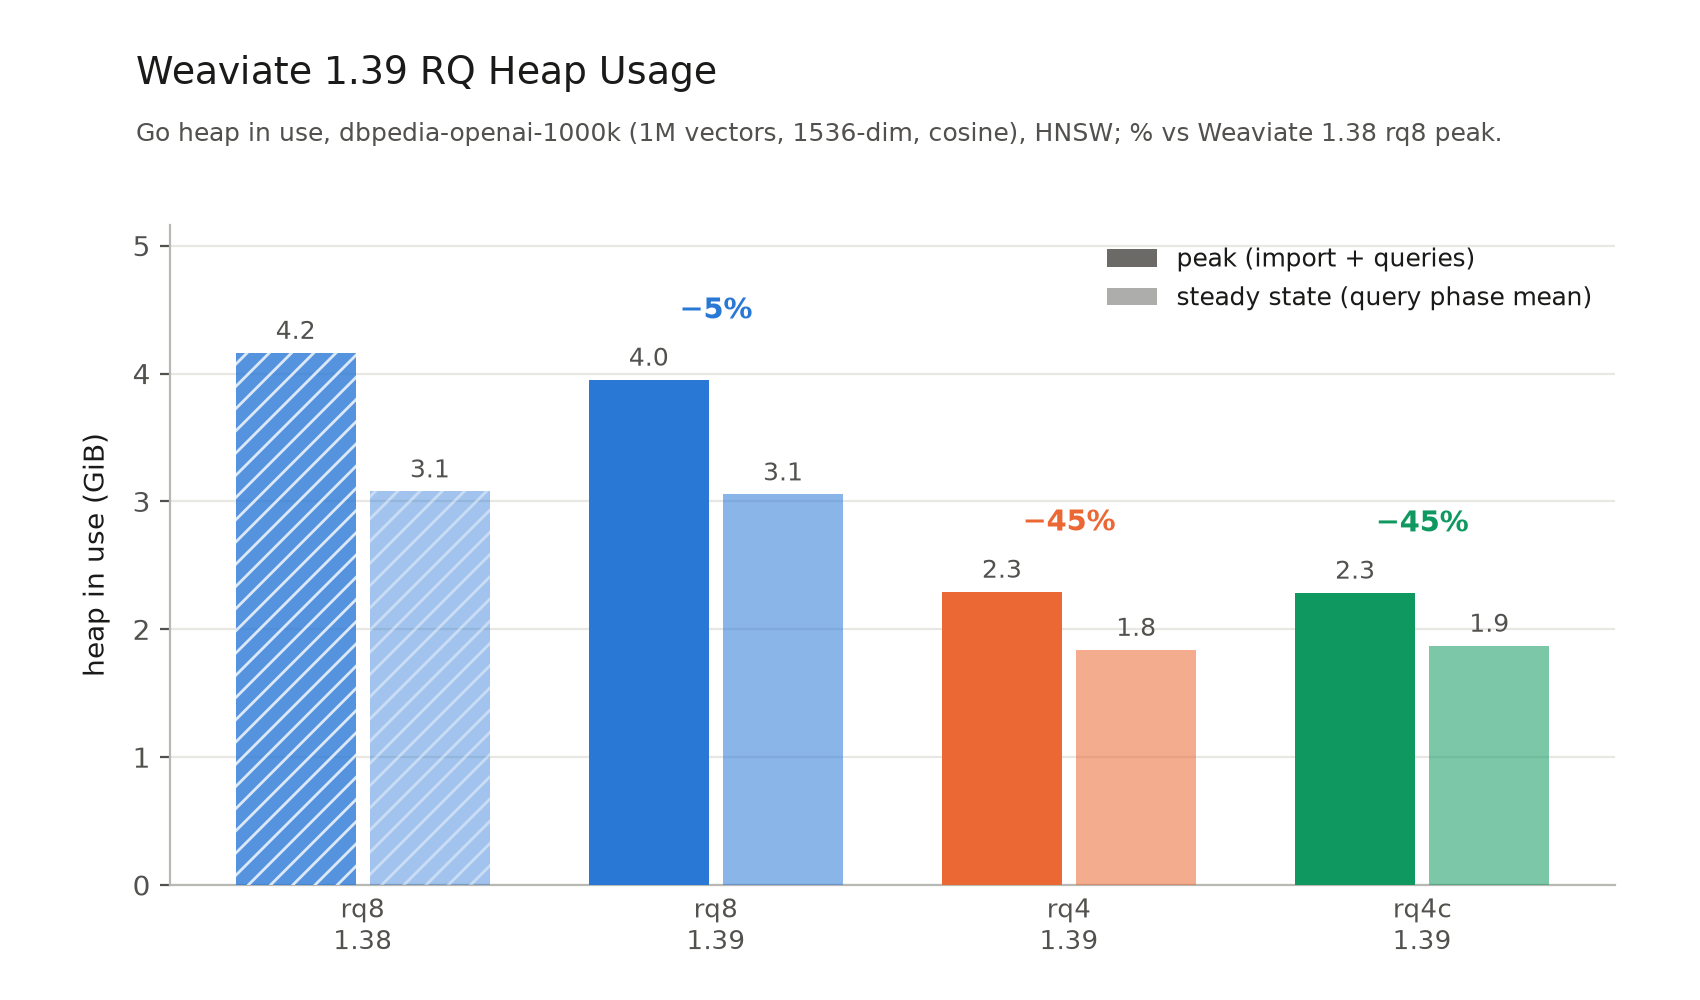
由于编码和距离函数更快,导入时间也有所改善。在同一数据集上,RQ8 从 1.38 到 1.39 的导入时间下降了 16%,RQ4 和 RQ4c 则分别比 1.38 基线少 37% 和 32%。
在规模扩大时是否仍然有效?
我们做的一个有趣的实验是:对 Meta 的 Sphere 语料库(DPR,768 维,点积)的随机采样子集进行规模扩展,然后使用每点 1,000 个查询对精确真值(ground truth)进行暴力 recall@10 测试,规模从 1M 到 250M 向量。
Quantizer    Recall 1M    Recall 10M    Recall 100M    Recall 250M
rq8          97.15        97.09         97.09          96.90
rq4c         94.00        93.51         93.82          93.53
rq4          84.58        83.41         84.63          85.02
这里最大的结论是,在 1M 到 250M 范围内,召回率基本保持平稳。即使使用独立的查询重新运行,结果仍处于相当紧凑的区间内。
这张图也清楚地展示了重排序(rescoring,即用未量化向量对前 20 个向量距离进行重打分)带来的巨大召回率收益,以及 RQ4 centered 为何能更准确地处理均值偏斜(skewed mean)的数据集。
该结果的一个注意点:尽管量化器在该范围内能实现几乎与规模无关的召回率,但 ANN 索引确实存在随规模退化(degrade)的参数。处理这种情况的一种标准方式是合理地对数据集进行分片(sharding)(无论如何,在扩展到大型数据集时通常都建议进行分片)。
RQ4 的均值需要多少向量?
RQ4 centered 通过一个默认上限为 10,000 个向量的样本来拟合均值 μ。启用异步索引(async indexing)时会自动完成此操作。我们可以在数据集前 N 个向量上拟合均值,然后测量它与全语料均值之间的距离,从而评估区间所覆盖的分布范围:在默认的 10k 时,拟合均值与再多 100 倍数据所确定的均值相比,落在大约 1% 的语料半径以内。在整个语料上拟合则没有带来可衡量的收益(跨七个数据集的最大差异为 0.20 个百分点,其中两个数据集反而是 10k 拟合更好)。因此对于 RQ4,默认的训练上限为 10,000,这样可以让内存节省更早开始生效。
与 TurboQuant 的比较
关于 RQ,我们经常被问到一个问题:它与 TurboQuant 比较如何?TurboQuant 是另一种量化技术,同样使用随机旋转,但在旋转后使用 Lloyd-Max 码本(codebook)而非均匀网格来量化向量。
为进行下面的比较,我们运行了自己的实现与一个流行的开源 TurboQuant 实现之间的召回率基准测试。如果你想了解更多比较 RaBitQ 和 TurboQuant 的细节,我们还推荐 Revisiting RaBitQ and TurboQuant: A Symmetric Comparison of Methods, Theory, and Experiments 一文,该文更深入地比较了这两种算法。
Dataset                                   RQ8    RQ4    RQ4c   4-bit TurboQuant (paper)   4-bit TurboQuant (renorm)   4-bit TurboQuant (centered+renorm)
dbpedia-ada002-1536-1M (cosine)           99.0   93.5   96.8   87.4                       94.5                        96.4
sphere-dpr-768-1M (dot)                   98.2   90.9   96.3   76.6                       91.6                        95.8
sift-128-1M (l2)                          96.7   81.4   87.5   80.4                       81.0                        85.3
glove-100-1.2M (cosine)                   98.5   87.0   89.9   79.0                       85.4                        86.9
dbpedia-cohere-v2-4096-500k (dot)         99.9   98.1   98.5   97.4                       98.2                        98.2
msmarco-arctic-embed-m-768-1M (cosine)     99.3   94.7   95.8   91.5                       95.1                        95.9
nfcorpus-mlateon-mv-128 (maxsim)          93.4   72.0   94.1   26.8                       76.2                        93.2
scifact-mlateon-mv-128 (maxsim)           94.9   77.7   94.5   36.7                       81.1                        94.1
其中 TurboQuant (paper) 是论文中标准的 TurboQuant MSE 变体,(renorm) 增加了重归一化(renormalization),这已被发现对改进基础 TurboQuant 很重要,而 (centered+renorm) 还增加了均值中心化,以便与 centered RQ4 进行公平比较。
忠于论文实现的 TurboQuant 在每个数据集上都输了(并且在像 mLateOn 这样高度各向异性的多向量模型上表现尤其糟糕)。加入中心化和重归一化后,差距有所缩小,但 RQ4c 在 8 个数据集中的 7 个上获胜。
最后,你可能已经注意到大多数公开实现中并没有"8-bit" TurboQuant。这是因为在 2-bit 或 4-bit 上有效的 SIMD 码本技巧在 8-bit 上不再奏效(性能会大幅下降)。RQ 在这方面适应性更强,可在全范围内使用。
使用 4-bit RQ
4-bit RQ 在 Weaviate 1.39 中作为现有 RQ 量化器上的一个 bits 设置发布。
"vectorIndexConfig": {
    "rq": {
        "enabled": true,
        "centering": true,
        "bits": 4
    }
}
在 Python 客户端中:
from weaviate.classes.config import Configure, Property, DataType

client.collections.create(
    name="Recipes",
    vector_config=Configure.Vectors.text2vec_openai(
        quantizer=Configure.VectorIndex.Quantizer.rq(
            bits=4,
            centering=True,
        ),
    ),
    properties=[
        Property(name="title", data_type=DataType.TEXT),
    ],
)
总结
我们很高兴地宣布对 Rotational Quantization 进行的整套性能改进,以及新增的 4-bit 位宽。旋转量化为快速编码和距离计算进行了调优,实现了具有竞争力的召回率,并显著节省了内存。尽管我们在 Weaviate Cloud 中仍保留 8-bit 作为默认值,但我们邀请你