AI DAILY / 2026-09-18
is-gpt-nerfed:检测 Codex 输出是否被暗中削弱的工具
kiyoakii/is-gpt-nerfed
全文中文翻译 · AI 生成,仅供学习交流
kiyoakii/is-gpt-nerfed
你在 Codex 里选定一个模型。本工具能告诉你,真正在回答问题的到底是不是你选的那个模型。如果不是,你会看到这条提示:
🎉 恭喜!你被降级(nerf,在游戏圈中指"削弱",译注)了!你请求的是 gpt-6-astra;指纹显示是 gpt-5.6-luna(91%)。好好享受这份额外的"折扣"吧。
> 示例输出,并非真实判定结果。
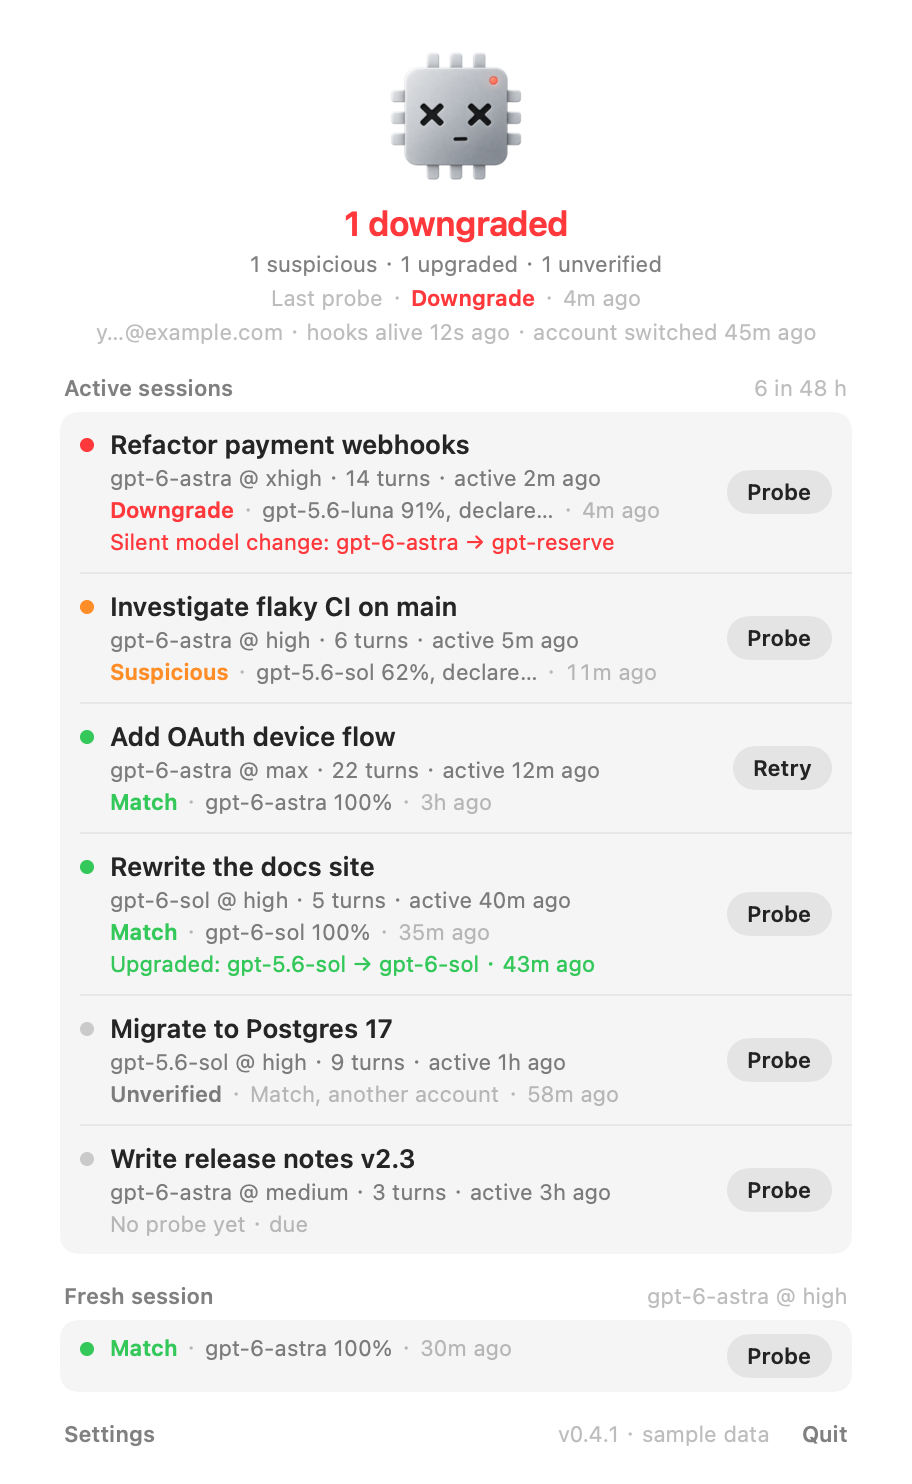
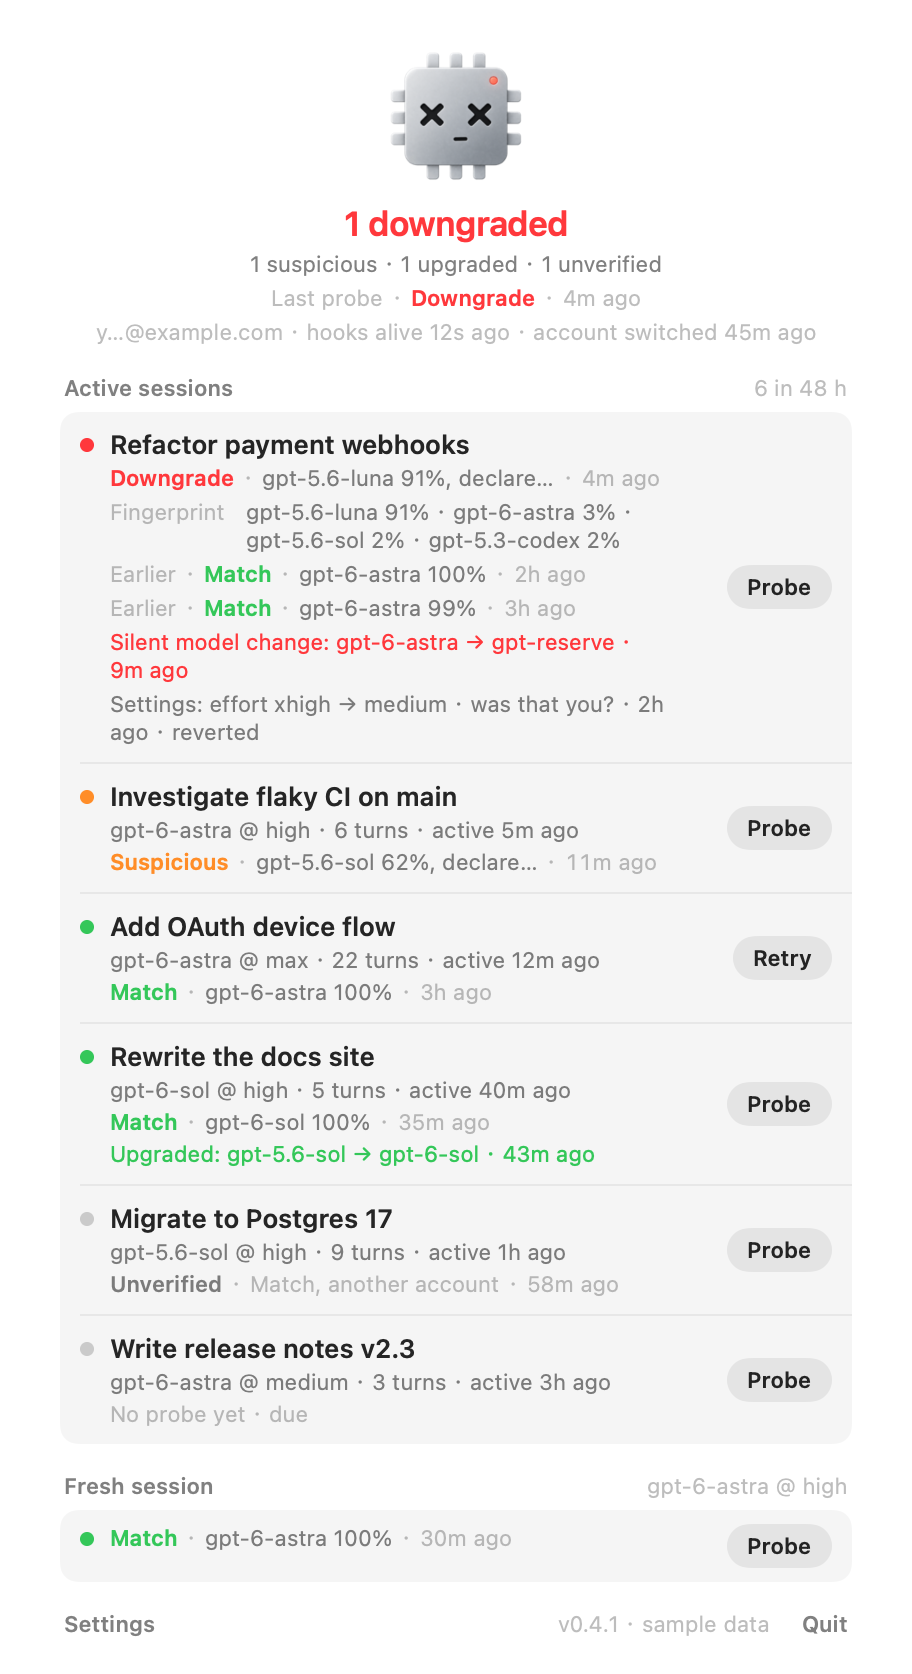
> 面板,以及在其中打开的会话。样本数据,非真实会话。
正常 · 可疑 · 降级
它检查什么
一切都在你的 Mac 上运行,不会上传任何内容。
Codex 会为每一轮记录请求的模型和推理强度(reasoning effort)。插件在每轮之后读取这些记录,并标记出在你未做改动的情况下发生的变化:模型被替换、推理强度被调低、出现隐藏的内部模型(比如 gpt-reserve)、上下文窗口变小。换成了更新或更大的模型也会被报告,因为灰度推送(rollout)可能往任一方向进行。整个过程不消耗 token(令牌)。
按既定计划,插件还会通过桌面端用于侧边聊天(side chat)的同一个 app-server 调用,把你的会话分叉(fork)三次,每次分叉都是临时的,并沿用该会话自身的模型和推理强度。每个分叉会被要求给出约 300 个"随机"数字。语言模型在生成随机数时带有该模型独有的偏置(bias)。
ModelTrace 的校准样本库(calibrated bank)会把三次回答转换为一个指纹(在交叉验证中,用三次回答即可达到 100% 准确率),并据此与你选定的模型进行比对:
| 判定结果 | 含义 |
|---|---|
| 匹配 (Match) | 你选定的模型确实在回答 |
| 可疑 (Suspicious) | 指纹倾向于其他模型,但置信度不足;保留此判定直到下次探测 |
| 降级 / 升级 / 改道 (Downgrade / Upgrade / Rerouted) | 明确不匹配:首选候选 ≥ 80%,你的模型 ≤ 20%,且至少在两次回答中出现 |
| 已降级 (Downgraded) | Codex 自己的记录显示发生了一次静默切换,不需要指纹 |
| 已升级 (Upgraded) | Codex 自己的记录显示换到了更新或更大的模型 |
| 未收录 (Unlisted) | 你选定的模型尚未进入指纹样本库 |
| 无效 (Invalid) | 没有得到可用回答(工具调用、被拒、网络问题);不是判定结果,该行保留上一次的判定,并提供"重试" |不匹配会通过 macOS 通知、会话内消息以及菜单栏中的红色表情图标来告诉你。匹配则不会通知。
安装
需要 macOS 26。
在终端(Terminal)中用一行命令即可安装最新版本并打开它:
curl -fsSL https://raw.githubusercontent.com/kiyoakii/is-gpt-nerfed/main/install-app.sh | sh你也可以从 Releases 下载磁盘映像(disk image),然后把 IsGPTNerfed 拖进 Applications(应用程序)。
该应用尚未通过苹果公证(notarized),因此首次启动时 macOS 会阻止它,直到你在"系统设置 → 隐私与安全性"中放行。
点击菜单栏中的表情图标,然后按下"安装"。这一步会把自带的插件注册到 Codex,并信任其钩子(hooks)。
当有更新版本发布时,页脚会给出提示,且只会收到一次通知;点击通知后,应用会下载新版构建、校验校验和(checksum)、替换自身并重新启动。
不使用应用本身,在任意 macOS 上也可以:
git clone https://github.com/kiyoakii/is-gpt-nerfed ~/is-gpt-nerfed && cd ~/is-gpt-nerfed && ./install.sh在询问是否信任钩子时,回答 yes。Codex 不会运行任何你未信任的钩子,而且它不会主动告知你。
需要带插件钩子的 Codex(桌面应用或 CLI;在 0.154 上测试通过)以及系统自带的 python3。
./uninstall.sh会移除全部内容。
使用方法
macOS 界面支持英文和简体中文,遵循系统的首选语言设置,英文为回退语言。这包括应用生成的证据、进度消息以及应用显示的诊断信息。用户会话标题、模型 ID、推理强度数值以及无法识别的外部诊断信息保留原文。存储的记录、CLI 输出、通知以及 ModelTrace 的校准探测提示词保持不变。
你正在使用的每个会话,都会在累计 30 分钟活动后在后台被探测。要立即探测某个会话,在该会话中输入 $is-gpt-nerfed。
菜单栏面板会列出过去 48 小时内的会话以及其最近一次的判定结果。点击某个会话可查看其报告(指纹、早先的探测、证据),右键可执行操作。每个会话都有"探测"和"重试","全新会话"这一行则会探测一个全新的会话,展示当前新会话得到的服务。
在终端中:
- nerfed probe now(选择一个会话)
- nerfed report
- nerfed explain <probe>
- nerfed log --since 2h设置在应用中,也可以使用 nerfed config set <key> <value>:
| 键 (key) | 默认值与说明 |
|---|---|
| frequency | 30m per session:每累计 N 分钟活动 (30m),或每 N 轮 (turns:8) |
| fresh_frequency | manual probe:无论你在做什么,每 N 分钟探测一次全新的会话 |
| mode | auto:在后台进行探测;nudge 仅作提醒 |
| halt_on_mismatch | false block:在不匹配后暂停工具调用,直到你输入 resume |
| notify_on_ok, announce_ok | false:也报告"匹配" |
| hide_titles | false screenshot:模式,使用中性的会话名称,不显示账号 |
| check_updates | true:每 10 分钟向 GitHub 查询是否有新版本 |
账号
会话在 Codex 账号之间是共享的,降级可能绑定的是账号而非会话本身。
因此每次探测都会打上当前登录账号的标签(一个哈希值,绝不会是账号 ID)。切换账号后,更早的判定会显示为"另一个账号",并且这些会话会被重新探测。
限制
"你选定的模型"指的是 Codex 请求的那个模型。如果服务端换掉了权重却保留了模型名,只有指纹或更小的上下文窗口能看出问题。
样本库是封闭集合(closed-set):库外的模型会被映射到最相近的"替身"模型上。
一次探测在你的账号上消耗三次简短回答。在五分钟内尚未给出回答的分叉会被替换一次,因此较慢的模型也不会从样本中掉队。
通过 Codex 自身设置进行的模型或推理强度变更,会以一个问题("这是你做的吗?")的形式显示,因为插件无法分辨是你还是 Codex 改了它。
探测在私有的 app-server 进程中运行,并以被检测的客户端(桌面应用或 CLI)的身份标识,因为服务可能会按客户端来路由。桌面端自身连接与探测连接之间其他的差异,对它来说都是不可见的。
隐私
插件读取 ~/.codex(会话记录、模型缓存,以及仅用于账号哈希和脱敏邮箱的 auth.json),并写入 ~/.codex/is-gpt-nerfed(探测、判定、log.jsonl)。
分叉就是用你的账号进行的普通 Codex 推理。
它自身唯一的网络请求,是应用打开期间每十分钟向 GitHub 查询最新发布标签;在"设置"中关闭后就不会发起任何请求。
致谢
ModelTrace(xqy2006,MIT)提供了指纹样本库、打分器、提示词,以及 hlwy-ai-checker 中"用随机数识别模型"的想法;simple-term-menu(MIT)提供了会话选择器。
采用 MIT 许可证。内部实现、构建与贡献说明见 docs/DEVELOPMENT.md。