AI DAILY / 2026-09-22
KLPO:面向智能体强化学习的KL正则策略优化项目
yifanzhang-pro/KLPO
全文中文翻译 · AI 生成,仅供学习交流
yifanzhang-pro/KLPO
默认情况下:终止奖励(terminal reward)提供反馈,独立的辅助 token 采样估计采样器条件分数修正(sampler-conditioned score correction)。无需同提示词(prompt)的响应组,也不需要学习的价值函数(value)或归一化(normalizer)模型。
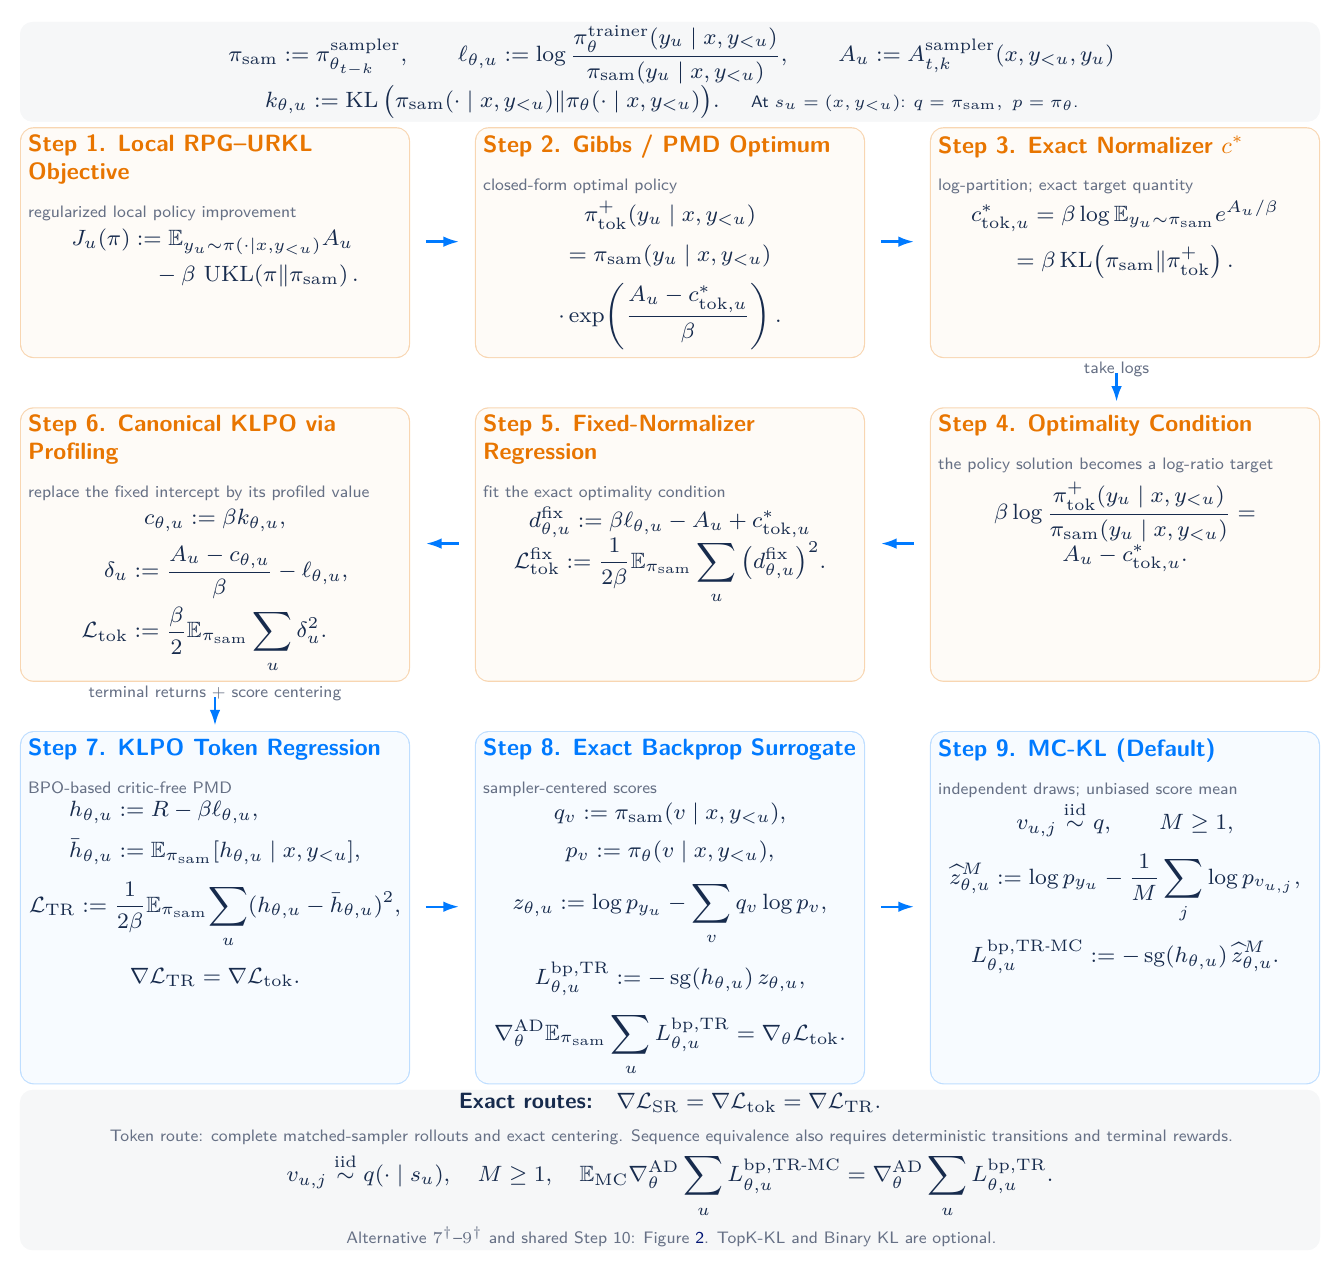
概览
每个提示词(prompt)只需一个完整响应即可。
MC-KL 在已访问的前缀(prefix)处使用辅助 token