AI DAILY / 2026-09-22
Jev与System One决策模型:TypeSafe AI的非自回归路径
Jev: System One models for Prod, not God — with Diogo Almeida, CEO, TypeSafe AI
全文中文翻译 · AI 生成,仅供学习交流
Jev: System One models for Prod, not God,对话 TypeSafe AI CEO Diogo Almeida
一上线就直接霸占了 AI 时间线,完整的 Jev 科普我们就跳过了,你常刷的 AI 博主估计早讲过了。我们顺手整理了一些东西:
先看官方 patterns 和 cookbooks,从基于速度的用例讲起:游戏、电脑使用;1 小时 34 分那段聊到的语音 + 电脑使用例子;语音 + 浏览器控制;不能错过的 Doom 演示;游戏里开车;Excalidraw 虚拟试穿;「Smart Games」/智能 NPC;短信里的引导式回复。Jev 用在 coding agents 上有一份官方指南;用在 linting、压缩 tool calls 上也有;Theo 那边的合理质疑。
- Diogo 发了一篇关于 Tyranny of the KV Cache 的笔记,建议在听完播客里 Jev + coding agents 那段之后读一读,因为他坚信 Cache Rules Everything(译注:戏仿 Wu-Tang Clan 名曲 C.R.E.A.M.「Cash Rules Everything Around Me」,把 cash 换成 cache);构建在 Jev 之上的编程语言(Diogo 最爱);Jev 用于分析回放和用户旅程复盘;「暗数据(dark data)」;实体解析;自然语言搜索;「智能软件」。Jev 的一个核心目标是「消失于无形」,比如像正则表达式那样毫不显眼;Jev as a judge;Jev memes;Jev vs LLM 能力;融合 transformer 与 classifier;关于 confidence API;Jev vs GLiNER(注意两者的差异与反驳,同意,同意,同意);Jev 上的电车难题;Jev Bush(译注:戏仿美国前总统候选人 Jeb Bush 的名字)。
这一长串我们就不挨个展开了。我们会把精力放在自己能给出的独特视角上,更宏观的哲学和使命层面的东西,聊聊 Jev 为什么会诞生,TypeSafe 接下来的模型(比如 ReasoningJev?)你可以期待什么,哪些用例和想法值得你去投入,而不是去做第 55 个粗制滥造的 Jev API 克隆,或者搞一个泛泛的 JevBench 基准,后者 Diogo 已经公开拒绝过。
为什么是 RLCD:三种 RLHF,以及为什么它们全都是错的北极星
Diogo 对 RLHF 知根知底,毕竟他是在 OpenAI 开创 post-training 阶段的成员之一,他把 RLHF 的三条支流追溯到 Christiano 等人 2017 年的论文(机器人后空翻那个 demo)、Stiennon 等人 2020 年的论文(学习摘要),以及他主导的 Ouyang 等人 2022 年的论文(InstructGPT)。从那以后,从 Function Calling 到 Structured Outputs 再到 Reasoning,每一项创新都像是在「基于字符串的序列到序列预测」这个范式上打的补丁。他在节目里也聊到,2023 到 2024 年他一直在苦苦尝试,想训练一个真正能解决「把 LLM 作为软件核心」这一根本问题的模型:可靠性(reliability)。但没能成功,既有个人层面的低估,也有组织层面的低估。
Jev 的核心创新是 Reinforcement Learning for Calibrated Decisions(用于校准决策的强化学习,简称 RLCD),一种尚未发表的新方法。它要优化的目标是「在系统一任务上给出带有认知诚实概率(epistemically honest probabilities)的答案」,所以既不是人类评分反馈(RLHF),后者会带来幻觉、谄媚,以及对人的永久依赖,也不是带评分标准的可编程验证输出(RLVR),后者虽然能搞定纳维-斯托克斯方程(译注:Navier–Stokes,经典流体力学方程组,长期被当作衡量 AI 高级推理能力的标志性问题),却会加剧锯齿状智能(jagged intelligence,指模型在不同任务上表现极不均衡),也很难跟其他软件集成。
校准(calibration)问题我们之前在节目里聊过。但要搞明白 RLCD 为何成为必需,最好的去处还是 Diogo 在 AIE 的演讲,里面讲了为什么一代被训练来服务人类的 AI 助手模型,已经让它们不再适合被训练成「可组合、可编程、用于自动化的 AI」。
演讲最后,他还抛出了自己对 scaling laws 的反主流观点,暗示怎么在不花大实验室几十亿美元的前提下,建一个现代的 neolab。
最苦涩的教训:任务和数据胜过算力
我们花了不少时间聊他写的 The Bitterest Lesson(最苦涩的教训):
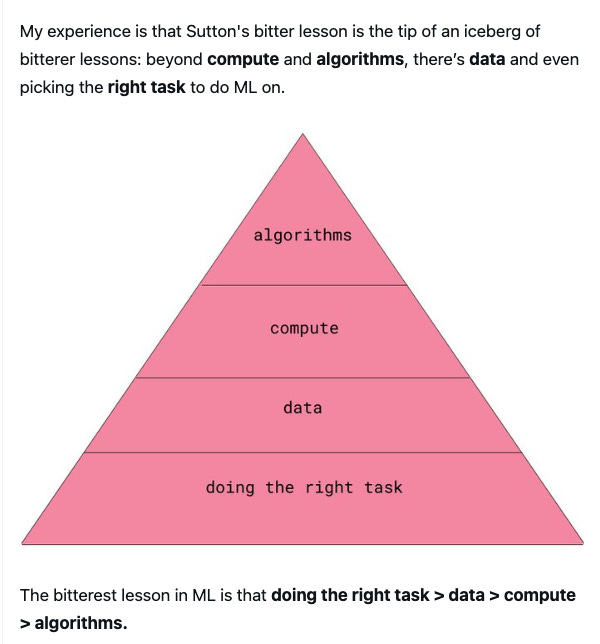
他的核心观点是:「你得到你所优化的东西。ML 里最苦涩的教训是,其中最重要的部分根本不是 ML 本身。」挑对北极星,比如是要用户点赞,还是要集成到 tool call 里,其他一切就自然顺了。
我们兴奋地逮到了刚染完头发的 Diogo,一起聊了下面这些话题:
为什么 AI 能解决超难问题,却还是搞不定基础工作的自动化;什么是系统一模型,以及为什么 Jev 是为软件而不是为对话而生的;RLHF、模式坍缩、校准,以及优化人类偏好的隐性代价;当 AI 被埋在软件的依赖里时,拒答(refusals)为什么会变成问题;为什么 TypeSafe 拒绝公开基准,而是优化每美元智力(intelligence per dollar);「最苦涩的教训」:为什么正确的任务和正确的数据可能比算力更重要;为什么 TypeSafe 把自己定位成数据实验室而非模型实验室;RLCD 跟 RLHF、RLVR 作为根本不同的 AI 北极星;为什么可靠性和鲁棒性比单纯的确定性更重要;Jev 的编程原语,以及智能如何映射成软件的控制流;为什么开发者应该把 AI 工作流拆成小的、可度量的决策;为什么结构化状态取代了庞大的 prompt 和系统消息;Diogo 为什么觉得 AI 最终应该消失在软件背景里;「反向 SaaS 末日(inverse SaaS-pocalypse)」以及 AI 怎么放大现有软件;系统一与系统二的智能,以及推理模型(reasoning models)的局限;暗数据、电脑使用、实时智能,以及 Jev 最早期的最大用例;为什么 Jev 可能会重塑围绕单一模型架构搭建的 coding agents;Diogo 为什么说有 10 亿美元也不会拿去 pre-train;引领他走向 TypeSafe 的 OpenAI 经历,以及他为什么觉得很多新实验室做 AI 的方式不对;超越 KV 缓存的 coding agents、共享状态、子代理(sub-agent),以及多代理的未来。
Diogo Almeida LinkedIn: https://www.linkedin.com/in/diogomda
X: https://x.com/CompleteSkeptic
TypeSafe AI: https://typesafe.ai/
时间戳
00:00:00 Jev 发布周与 AI 经济革命
00:02:50 Jev 是什么?系统一模型与可编程 AI
00:05:54 RLHF、模式坍缩、校准与 Yann LeCun
00:10:29 可编程 AI、拒答与安全对齐
00:17:21 为什么 TypeSafe 拒绝公开基准
00:20:43 最苦涩的教训:数据、算力与正确的任务
00:24:59 RLCD vs RLHF 与 RLVR
00:28:42 为什么强大的 AI 仍未能自动化经济
00:39:55 可靠性、鲁棒性与确定性
00:48:11 模型版本管理、LTS、速度与每美元智力
00:54:04 Jev 的 API 与编程原语内幕
00:58:28 如何用 Jev 构建:结构、拆解与小决策
01:18:28 反向 SaaS 末日与 AI 消失于软件之中
01:33:21 电脑使用、暗数据与 Jev 最大的用例
01:38:48 Jev 如何重塑 coding agents
01:41:00 AI 安全、前沿节奏与 RLVR 的局限
01:48:03 为什么 Diogo 即便有 10 亿美元也不会拿去 pre-train
01:55:19 TypeSafe 背后的 OpenAI 故事
02:01:41 为什么 Diogo 认为大多数新实验室都误解了 AI
02:08:00 超越 KV 缓存的 coding agents 与多代理未来
转写稿
引言:Jev 发布周与开发者势头
Swyx [00:00:00]:好,进录音棚了。这是个特别的时刻,因为本周 Diogo,我的好兄弟,发布了 Jev,它已经席卷了整个时间线。你感觉怎么样?现在做你自己是什么感受?
Diogo Almeida [00:00:16]:感情上吗?
Swyx [00:00:17]:嗯。
Diogo Almeida [00:00:17]:从来没这么糟过。我现在像是一具破烂不堪的行尸走肉,事情太多了,而且我是技术型 CEO,到处都是火要救。
Swyx [00:00:29]:嗯。
Diogo Almeida [00:00:29]:但精神上我觉得,我经常这么说,在我的 over-under 活动上讲了好几年了。我感觉整个 AI 领域就像那种狂欢节的哈哈镜屋,每个人都疯疯癫癫地说着最怪异、最说不通的话。但感觉就是仅仅这一周,我跟现实对上了,哦,人们终于看清了。AI 可以远比人们曾经以为的更强大。
Diogo Almeida [00:01:06]:就像,是的,我们要搞起来了。是的,一场基于 AI 的经济革命重新摆上了台面,这真是太他妈爽了。
Diogo Almeida [00:01:17]:开发者们 get 到这一点让我超级兴奋。是,是,Swyx [00:01:25]:嗯。
Diogo Almeida [00:01:26]:我对社区和这一切都超级兴奋。太棒了。
Swyx [00:01:28]:嗯,你昨天说,你决定把 town hall 排在前面,而不是一堆 VIP、投资人那种人,因为你想让他们成为你最关注的人,对吧?工程师、开发者。
Diogo Almeida [00:01:43]:嗯,感觉有点,哦老兄,我现在在跟一些真正重要的人聊。
Swyx [00:01:47]:嗯。
Diogo Almeida [00:01:47]:我可能不该透露是谁。
Swyx [00:01:48]:嗯。
Diogo Almeida [00:01:48]:但对我来说感觉有点脏,我这个人可能对事情过于真诚。如果在我那堆人山人海的待办日程里,社区不在其中,就感觉有点脏。
Swyx [00:02:04]:嗯。
Diogo Almeida [00:02:04]:其实在理想世界里,应该全都是社区。我当时还想,「我是不是该一边走去录音棚一边开 town hall?」然后我说,「不,那也太疯了。」
Swyx [00:02:12]:是啊。你们一直在 Discord 上开 town hall。Discord 现在有 10 万人了。你的 Twitter Diogo Almeida [00:02:19]:我不看这些数据。
Swyx [00:02:20]:嗯。
Diogo Almeida [00:02:20]:我靠,厉害了。
Swyx [00:02:21]:你的 Twitter 爆了。真的很好笑,因为在 AIE,你就是说,「对,请关注我」,然后你连自己的 handle 都没给。
Diogo Almeida [00:02:29]:我是菜鸟。我是菜鸟。
Swyx [00:02:29]:你真的是个菜鸟。
Diogo Almeida [00:02:30]:我是菜鸟。
Swyx [00:02:31]:但,不,但这就是一种气场,那种Diogo Almeida [00:02:33]:酷Swyx [00:02:33]:你不知道怎么自我推销。
Diogo Almeida [00:02:35]:嗯。我发「我靠,我们三个都上 trending,热搜」的时候有人戳穿我,说「那是你个人的 feed」。
Swyx [00:02:42]:那是个人,对。
Diogo Almeida [00:02:43]:我就,「哦,不。」
Swyx [00:02:44]:当然,当然会给你推上去。
Diogo Almeida [00:02:45]:社死。嗯。
Swyx [00:02:45]:对,因为你点了它。
Diogo Almeida [00:02:47]:嗯。
Swyx [00:02:47]:好的。好的,恭喜你,一切顺利。
Jev 是什么?系统一模型与每美元智力
Diogo Almeida [00:02:50]:谢谢。
Swyx [00:02:50]:细节我们后面再聊更多。但现在,对那些活在信息茧房里、或者就想听个权威定义的人来说,Jev 是什么?
Diogo Almeida [00:03:02]:呼。让我想想。这题挺难。
Swyx [00:03:07]:好。你想让我重新问一遍Diogo Almeida [00:03:09]:不用。我很乐意Swyx [00:03:10]:好Diogo Almeida [00:03:10]:我很乐意,就这么聊。
Swyx [00:03:12]:嗯。
Diogo Almeida [00:03:13]:我要说,关于这个问题让我最先松一口气的是,我不用再向我爸妈解释它了,因为 ChatGPT 可以直接讲。
Swyx [00:03:20]:不错。
Diogo Almeida [00:03:21]:所以我的看法是,我们需要一类新模型。我们并不执着于给这类模型命名。我们能想到的最准确的名字是系统一模型(System 1 models)。
Swyx [00:03:33]:嗯。
Diogo Almeida [00:03:33]:有原因的。这就是我们之所以不叫它们 decision models 的原因,因为它们将来会是那种东西。系统一比那更大。我只能说到这里。我们没料到这会是我们的重大发布,所以我们手里还有东西。
Swyx [00:03:48]:你应该说低调点,叫 research preview。
Diogo Almeida [00:03:52]:其实也算,对吧?其实也算。但我们。所以有一类模型,我们把它们描述为机器原生、系统一、大型可编程。我觉得这类模型的目标是让代码成为消费者。所以相对于那些预训练的大型语言模型,它们是为互联网自动补全而生的,或者 RLHF 模型,比如 chatbot 指令遵循模型,它们是为回复文本而生的,或者 RLVR。它跟 RLHF 之间有个模糊地带。这类模型的目的是让结果直接被代码消费,这就是 type safe 这个名字的由来。所以我们真正想要的是,让 AI 尽可能强大,而实现它的方式是把它跟软件集成在一起。我们设计的一切,不只是表面,还包括模型的深层内部,都为软件做了优化。所以第一,Jev 是我们的第一个大型可编程模型,或者叫系统一模型,随你怎么叫。Jev 旨在为每美元智力(intelligence per dollar)而优化,这也是 Jev 这个名字的由来。
Swyx [00:05:03]:杰文斯悖论(Jevons Paradox)。
Diogo Almeida [00:05:03]:对,杰文斯悖论。它为每美元智力而优化。我喜欢跟人争论可靠性、成本、校准和速度之间哪个最重要。Jev 的目标就是这个。Jev 会成为在每美元智力前沿上站的模型的名字。还有其他的优化方式,比如机器学习,至少如果你擅长机器学习,一切都是权衡。我们就是在这条路上全押。
校准、模式坍缩与 RLHF 的局限
Swyx [00:05:31]:嗯。对我来说,校准是之前人们不太常谈的新东西之一。我们以前跟 Hugging Face 的 Clementine Foreia 做过一期,她们就,「是啊,实际上,他们就是。」或者说,这就是你关于 RLHF 的全部论点,它们会向你最想听的方向坍缩Diogo Almeida [00:05:50]:哦Swyx [00:05:50]:或者最可能的方向,而不是它们自己对一件事情的内部置信度。
Diogo Almeida [00:05:54]:我能就此高谈阔论一会儿吗?
Swyx [00:05:56]:请。
Diogo Almeida [00:05:57]:好。我听说你的听众是技术性最强的,所以我真的想讲透。
Swyx [00:06:02]:好。
Diogo Almeida [00:06:03]:我下了极大的功夫确保我们发布视频里所有东西都准确真实。显然这非常不寻常。没人注意到的一件事是 RLHF 的缺点,特别是 mode dropping。
Swyx [00:06:17]:mode dropping 还是 mode collapse?
Diogo Almeida [00:06:19]:一回事。
Swyx [00:06:19]:你是这么叫的吗?
Diogo Almeida [00:06:20]:一回事。
Swyx [00:06:20]:好的。
Diogo Almeida [00:06:21]:我以后想专门写一篇博客讲这个,但我想尽可能多告诉一些人,因为我觉得这非常有意思。这个辛辣观点是,我非常相信 Yann LeCun。我觉得 Yann LeCun 的观点其实是Swyx [00:06:36]:这个你怎么看?
Diogo Almeida [00:06:37]:嗯,我现在就讲还是等会儿再讲 mode collapse?
Swyx [00:06:40]:不,待会儿。先讲 mode collapse。
Diogo Almeida [00:06:42]:所以其实我认为在各种观点里,Yann LeCun 的观点是最准确的之一。但他有一张非常出名/臭名昭著的幻灯片,关于Swyx [00:06:52]:那块蛋糕?
Diogo Almeida [00:06:53]:LLM 注定失败。
Swyx [00:06:54]:好。
Diogo Almeida [00:06:54]:就是那张有一个饼图的,饼图里有一小块,一小块东西,然后他说随着序列长度的增加,模型犯错的概率上升。是的,就是这张。我很喜欢这张,因为它看起来数学上显而易见,但显然是错的,对吧?它数学上显而易见,但经验上并不成立。这也是我最喜欢教人的一件事,就是哪里Swyx [00:07:21]:脱节的地方,对吧?
Diogo Almeida [00:07:22]:没错。我可以说还是你想说?
Swyx [00:07:27]:关于 mode collapse?
Diogo Almeida [00:07:28]:哦不。哦,所以 mode clop…… collapse 跟这个有关。
Swyx [00:07:31]:嗯。
Diogo Almeida [00:07:31]:脱节之所以出现,是因为如果你处于 mode covering 或者一个校准良好的分布里,你就不会因为存在离群值而被过度惩罚。你会预期,一部分时间你会落在分布之外,一部分时间你会落在分布之内。当你覆盖整个分布时,这就是会发生的事。这就像 GAN 之前的模型。它们生成的图像很糊,对吧?
Diogo Almeida [00:07:54]:而 GAN 会 mode drop。它们会丢掉少数类,只生成那些非常常见的。这就是为什么这种效应不会发生,对吧?就像,要想生成很长的字符串而不犯错,它们需要变得非常保守,因为错误很容易被发现。而一些看起来正确但微妙有误的情况则很难被发现。这种校准对字符串的概率分布来说就像是毒药。
Swyx [00:08:22]:嗯。
Diogo Almeida [00:08:23]:这是个微妙的观点,而且我觉得这就是为什么这件事没有发生,这就是为什么字符串在决策上如此糟糕,把字符串模型硬塞去做决策就是一个糟糕的体验。
Yann LeCun、JEPA、Scaling Laws 与务实研究
Swyx [00:08:38]:既然讲到 Yann,你同意他提出的解决方案吗?也就是用一个世界模型、像 JEPA 那样的 embedding 东西,正确的解法?所以基本上,其中一个失败的原因是,你在尝试基于 token 输出做推理,然后再循环回去,继续,继续,直到你到达一个句子的结尾。他是这么解决的吗,也就是 JEPA,对吧?
Diogo Almeida [00:09:02]:对。
Swyx [00:09:02]:也就是 joint embedding,joint Diogo Almeida [00:09:04]:嗯Swyx [00:09:04]:联合嵌入预测(joint embedding prediction)。你怎么看?是正确的解法吗?
Diogo Almeida [00:09:10]:哎。我可能不该对 ML 内部讲太多,但我要说,我的标签除了「放飞自我」之外就是「务实」。
Diogo Almeida [00:09:20]:就像,我在这里的观点也很务实。我是不是 scaling law 的拥趸?要看情况。它取,这是,这是,就像。Scaling laws 告诉你,花多少钱,能在某个事情上变好多少。
Diogo Almeida [00:09:33]:Scaling law 意味着资源指数级增长、收益通常是次线性的,看起来像是一笔糟糕的投资,除非那些线性收益非常珍贵。但这一切,对我来说,关键在于:就我们手头这点东西,怎么才能做出他妈最大的改变?我可以爆粗口。
Swyx [00:09:51]:嗯。
Diogo Almeida [00:09:51]:是啊。
Swyx [00:09:52]:嗯。
Diogo Almeida [00:09:52]:是啊。
Swyx [00:09:53]:我们,我们,这是面向成人的节目。
Diogo Almeida [00:09:54]:必须的。
Swyx [00:09:55]:我们后面也有一个 scaling law 的东西,如果你想聊。
Diogo Almeida [00:09:58]:哦,可以如果我们。瞧,那部分现在不太相关。
Swyx [00:10:02]:嗯。
Diogo Almeida [00:10:03]:我其实,如果你想聊我的最苦涩的教训,我觉得那个更相关。
Swyx [00:10:06]:好。
Diogo Almeida [00:10:06]:但对我来说,我关注的就是实用主义。我觉得 JEPA 这东西是非常酷的早期研究。我很喜欢很棒的研究。它现在实用吗?
Diogo Almeida [00:10:21]:可能不该说。但就像,还有很多Diogo Almeida [00:10:29]:我只是觉得现在研究界到处都是未经打磨的璞玉,因为大家不知道怎么去打磨它们,就像