AI DAILY / 2026-09-23
Claude Opus 5.5 发布:对标 Fable 5.1,成本降四成
[AINews] Claude Opus 5.5, the new default model for AINews — and everybody cuts prices 40-50%
全文中文翻译 · AI 生成,仅供学习交流
Claude Opus 5.5 成为 AINews 的默认模型,各家厂商集体降价 40-50%
Claude Opus 5.5(max)每个 Intelligence Index 任务成本为 $5.98,与 Opus 5(max)的 $5.86 接近,但这是在 Anthropic 降价基础上叠加了显著增加的 token 用量。与 Opus 5 相比,Opus 5.5 增加的 token 用量会推动成本上升约 80%……
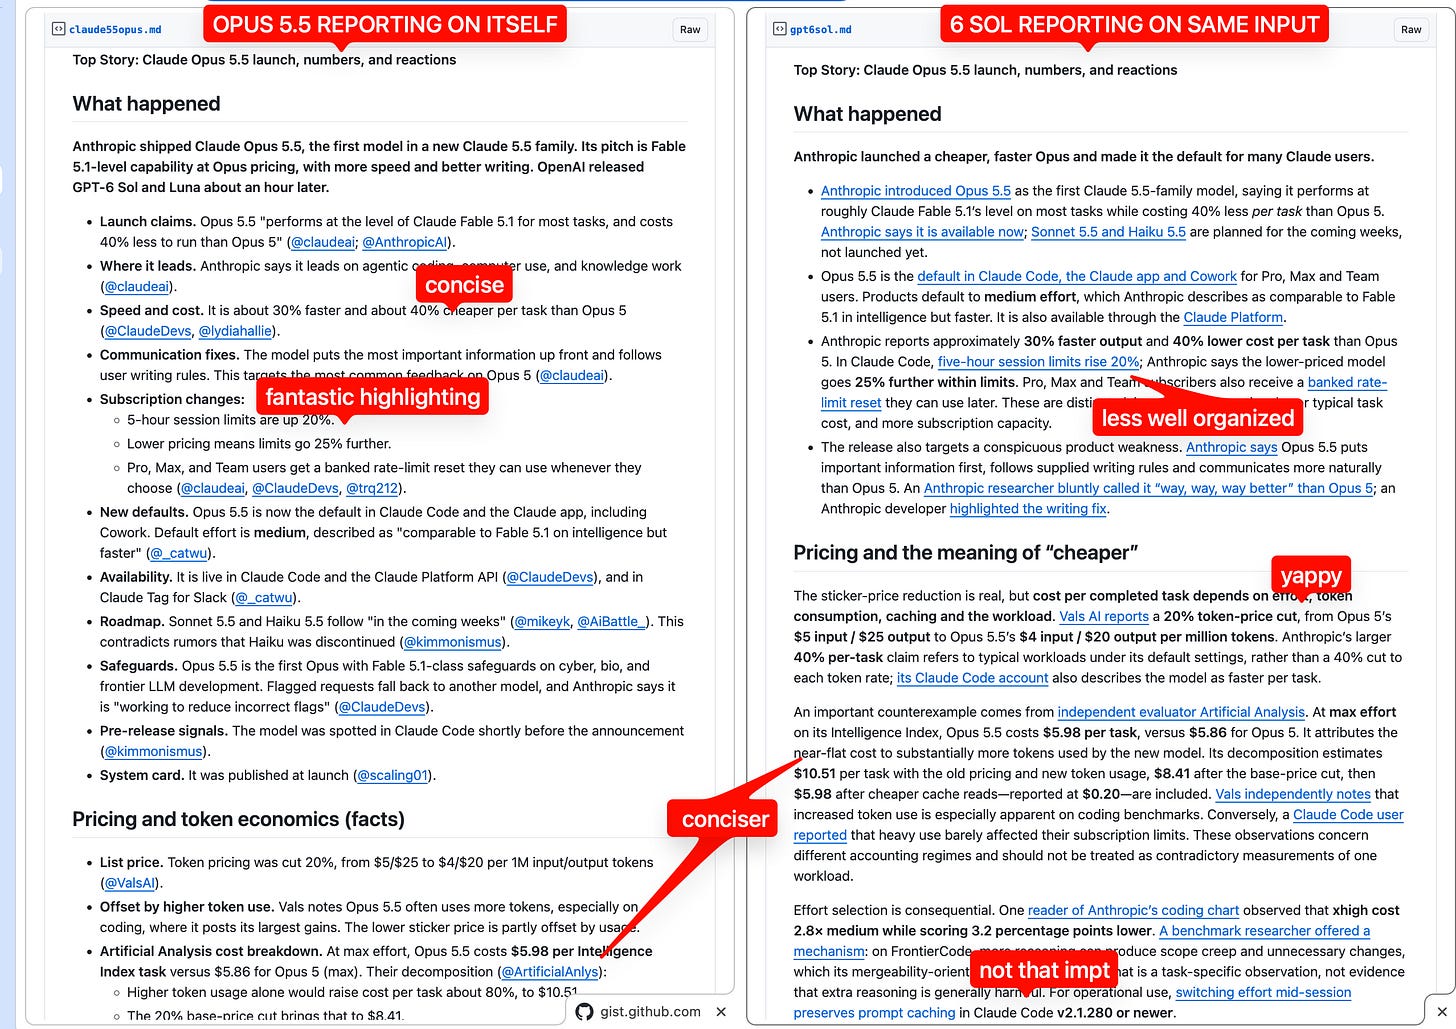
23:34 · 2026 年 9 月 22 日 · 36.1K 浏览 · 39 回复 · 25 转发 · 603 点赞不过 Claude 发布会上有一处罕见的强调点是写作能力的提升:"它会把最重要的信息放在开头,并遵循你给出的写作规范,这让长时间会话更易于跟进。"我们也可以确认,下面是今天由 Opus 5.5 和 Sol 6 运行的 AINews 版块。差别肉眼可见,我们将立即迁移到 Opus 5.5 来为 AINews 供稿,直至我们推出下一版 AINews 的模型或版本。
他们还公开了在大规模多智能体集群(multiagent swarm)方面的初步工作(以及效率提升):
> Lisan al Gaib@scaling01
> 非常自豪 Anthropic 兄弟们成为首个在 system card(译注:模型系统报告)中报告多智能体扩展到 100 个并行智能体的实验室(译注:Lisan al Gaib 是《沙丘》中的"沙漠救世主"梗,此处是 scaling01 的网名)
Lisan al Gaib@scaling01 Opus 5.5 System Card
17:01 · 2026 年 9 月 22 日 · 82.2K 浏览 · 30 回复 · 60 转发 · 1.19K 点赞2026/9/21–9/22 的 AI 新闻。我们检查了 12 个 subreddit(子版块)、544 个 Twitter 账号,未发现更多 Discord 内容。
AINews 的网站支持搜索所有过往期次。提醒一下,AINews 现在是 Latent Space 的一个版块。你可以自行选择加入/退出邮件订阅频率!
AI Twitter 回顾
头条:Claude Opus 5.5 发布、数据与反响
发生了什么Anthropic 发布了 Claude Opus 5.5,是新 Claude 5.5 家族中的首款模型。它的卖点是以 Opus 级别的定价提供 Fable 5.1 级别的能力,同时速度更快、写作更佳。约一小时后,OpenAI 发布了 GPT‑6 Sol 和 Luna。
发布声明Opus 5.5 "在大多数任务上达到 Claude Fable 5.1 的水平,运行成本比 Opus 5 低 40%"(@claudeai;@AnthropicAI)。
领先领域Anthropic 表示它在智能体编程(agentic coding)、计算机使用和知识工作方面领先(@claudeai)。
速度与成本比 Opus 5 约快 30%,每任务成本约低 40%(@ClaudeDevs,@lydiahallie)。
沟通改进模型会把最重要的信息放在开头,并遵循用户给出的写作规范。这针对的是 Opus 5 上最常见的反馈(@claudeai)。
订阅变化5 小时会话限额上调 20%。价格下降意味着限额实际可使用量提升 25%。
Pro、Max 与 Team 用户获得一次可自选时机的存额速率限制重置(rate‑limit reset)(@claudeai,@ClaudeDevs,@trq212)。
新默认值Opus 5.5 现在是 Claude Code 和 Claude App(包括 Cowork)的默认模型。默认 effort(推理力度)为 medium(中等),描述为"在智能水平上与 Fable 5.1 相当但更快"(@_catwu)。
可用性已在 Claude Code 和 Claude Platform API 中上线(@ClaudeDevs),并在 Claude Tag for Slack 中可用(@_catwu)。
路线图Sonnet 5.5 与 Haiku 5.5 将"在接下来数周内"跟进(@mikeyk,@AiBattle_)。这与关于 Haiku 已停产的传闻相矛盾(@kimmonismus)。
安全保障Opus 5.5 是首款具备 Fable 5.1 级别安全防护的 Opus,覆盖网络、生物与前沿 LLM 开发。被标记的请求会回退到另一个模型,Anthropic 表示"正致力于减少误标记"(@ClaudeDevs)。
发布前信号该模型在公告前不久被发现在 Claude Code 中出现(@kimmonismus)。
System card(系统报告)发布时一同公开(@scaling01)。
定价与 token 经济性(事实)
标价token 价格下调 20%,从 $5/$25 降至每百万输入/输出 token $4/$20(@ValsAI)。
被更高的 token 用量抵消Vals 指出 Opus 5.5 经常使用更多 token,尤其是在编程上,这也是它取得最大进步的领域。降低的标价部分被用量抵消。
Artificial Analysis 成本拆解在 max effort 下,Opus 5.5 每个 Intelligence Index 任务成本 $5.98,而 Opus 5(max)为 $5.86。其分解(@ArtificialAnlys):
- 单是更高的 token 用量就会使每任务成本上升约 80%,达到 $10.51。
- 20% 的基础价格下调将其降至 $8.41。
- 更便宜的缓存读取($0.20)将其降至 $5.98。
含义在 max effort 下,相对 Opus 5 的每任务节省消失。"便宜 40%"的说法仅适用于默认(medium)设置。
相对于 Fable 5.1Cline 报告 Opus 5.5 在 Artificial Analysis Intelligence Index 上击败 Fable 5.1,成本约为其 1/2.5(@cline)。
Prompt 缓存(提示缓存)在 Claude Code v2.1.280+ 中,会话中途切换 effort 不会破坏 prompt 缓存(@lydiahallie)。
模型规模(推测)@theo 声称 Opus 5.5 比 Opus 5 更小,并归功于后训练(post‑training)。这一说法未在官方帖子中得到确认。
基准与独立评测
Anthropic 自己的表格Opus 5.5 在 Anthropic 头条比较的每一行上都击败 Fable 5.1,并在大多数项目上击败 GPT‑6 Astra(@kimmonismus,@synthwavedd,@scaling01)。
@ShayneRedford(Anthropic)总结了所声称的提升:
- 在 CursorBench、KWBench 和 OSWorld 上强于 Astra。
- 风格和指令遵循大幅改善。
- 科学与健康能力更强。
- 对网络和生物滥用更具抵御力。
第三方与合作伙伴评测:| 评测 | 结果 | 来源 |
|---|---|---|
| Vals Index | #1,相对 Opus 5 上升 2 位/2 分;Anthropic 包揽前三(GPT‑6 Sol 待评) | @ValsAI |
| Vals RSI Index | #1;是该协议下首个击败已发布 reference 的模型;击败 Fable 5.1 | @ValsAI,@ValsAI |
| FrontierSWE(Proximal) | 62.3%,第 2,仅次于 GPT‑6 Astra(65.5%);领先 Fable 5.1(56.3%)和 Opus 5(52.0%) | @ProximalHQ |
| FrontierCode 1.1(Cognition) | Extended 上 65.3%;以"极低的成本"从 Fable 5 手中夺走 #1 | @cognition |
| CursorBench | 57.8%(Max),新的顶级模型;每任务成本比 Opus 5 低 40% | @cursor_ai |
| Perplexity WANDR | 0.610,$4.13/任务;略高于 Fable 5.1,成本低 67.6% | @perplexity_ai |
| ParseBench(表格) | 93.9%,较 Opus 5 提升 7 分;击败 Fable、Gemini、Astra | @jerryjliu0 |
| Roboflow 视觉/检测 | "迄今 Anthropic 出品的最佳视觉模型";目前位列 Playground 排行榜上领先 Google 的模型之中 | @skalskip92,@skalskip92 |评测细节与注意事项:
- Vals 运行设置:RSI 在 Claude Code 中以原生模式、max effort 运行,上下文 1M,最大输出 token 128K,温度 1(@ValsAI)。
- ParseBench 注意事项:模型在图表、格式与版式上仍有困难。LlamaIndex 以每页 5.8 美分判定其对生产环境 OCR 来说过于昂贵。该结论来自一家有竞争产品的厂商。
- AI R&D 与编程:@eliebakouch 解读 system card 为"在 AI R&D 上大致相当,但在智能体编程上是猛兽。"
- 饱和:@scaling01 询问 CoBench 是否已经"被做烂"。@synthwavedd 开玩笑说一个新基准刚推出就已经饱和。
- Arena:Opus 5.5 已加入 Agent Arena 以及 WebDev、Text、Vision 和 Document 的 Battle Mode。尚无分数(@arena)。
- Effort 扩展异常:在一张智能体编程图表上,xhigh effort 的成本约为 medium 的 2.8 倍,而分数反而低 3.2 分(@LearnOpenCV)。@Yuchenj_UW 称其为"最诡异的基准结果"并建议坚持使用 medium。@nrehiew_ 给出了一种解释:Opus 5 在 FrontierCode 上也呈现了同样的模式。FrontierCode 会惩罚不必要的更改,更高 effort 产生范围蔓延(scope creep)。因此模型"在更高推理力度下表现持续更差。"
System card 细节
多智能体扩展system card 第 8.12 节报告了扩展到 100 个并行智能体的实验。@scaling01 称这是首个此类实验室报告。@maksym_andr 强调它是多智能体扩展定律的证据。
ProgramBench 注意事项ProgramBench 作者 @OfirPress 指出 Anthropic 接近 100% 的解题率来自一个 166/200 的子集。该子集很可能排除了最难的程序,例如 FFmpeg 和 PHP 编译器。他还指出了一个指标错配(@OfirPress,@OfirPress):
- Anthropic 报告的是平均测试通过率。
- ProgramBench 报告的是完整任务完成情况。
- 部分解答经常能通过 60–70% 的测试,这会抬高通过率指标。
与 Mythos 5.1 的对比Opus 5.5 在 Anthropic 的 ECI 上得分高于 Mythos 5.1,并在每一项已测试的网络安全评测中击败它(@scaling01,@scaling01)。
奇怪的 misalignment(失准)发现@teortaxesTex 引用了一段话:恶意输出"几乎只出现在这种情况,在恶意输出之前,Claude 犯了一个不太可能的、无害的错误。"他询问 Anthropic 是否对自己植入了"沉睡特工"(sleeper agent)。(译注:sleeper agent 指平时表现正常、被特定触发条件激活后才执行恶意行为的隐藏后门)
"由 RSI 训练"他另引用了一句关于"首款由 RSI 训练的模型"的话,并称这令人担忧(@teortaxesTex)。
生物医学影像@iScienceLuvr 对其所报告的生物医学图像分析能力表示欢迎。
更多诉求@scaling01 要求提供不带 chain‑of‑thought(思维链)的时间跨度数据。
安全姿态与安全保障争议
官方立场:
- Sam Bowman:Opus 5.5 "比其前代显著更安全,因此发布它多半会降低与 misalignment 相关的风险",尤其是最极端的对齐(alignment)风险(@sleepinyourhat,@sleepinyourhat)。他还承认对能否跟上不断升级的风险感到担忧,同时表示在此能力水平下现有工具仍值得信赖(@sleepinyourhat)。
- Mike Krieger 提到了广泛的对齐测试和外部评估,包括由 METR 进行的评估(@mikeyk)。
摩擦:过度触发的回退@iScienceLuvr 在让 Opus 5.5 治愈癌症后被降级到回退模型。
针对中国(单次测试)@xlr8harder 表示一次快速测试显示前沿 LLM 开发分类器针对中国硬件。他呼吁更多探测。
对中国议题的反响
- @teortaxesTex 将此定性为 Anthropic 在削弱中国 AI。
- @jakehalloran1 将其解读为在保护 Trainium 的技术积累。(译注:Trainium 是 AWS 自研的 AI 芯片)
- "pacing the frontier"(控制前沿节奏)的叙事: @theo 认为今天的发布均非 Astra 或 Fable 级别,并称这是有意为之的节奏控制。(译注:pacing the frontier 指有意放慢最强模型的发布节奏)@goodside 表示,实验室"控制前沿节奏"的呼吁削弱了他原先"暂停然后做什么?"的立场。@dejavucoder 鉴于 Opus 5.5 实际表现优于 Fable 5.1,对该叙事进行了嘲讽。
写作、提示与行为
来自员工的写作修复"我们修好了写作"(@_sholtodouglas)以及"我们修好了口音"(@NotTomBrown)。
不同寻常的坦率@nmca(Anthropic)发帖:"比 Opus 5 好太多太多了。对那个模型表示抱歉。"@theo 称这是一条狂野的推文,预示着对外沟通变得更宽松。
Em dash(长破折号)@theo 报告输出中的 em dash 已经消失。这是反响最热烈的帖子。
Anthropic 的提示手册(@ClaudeDevs):
- 一次性交付整个任务,并定义"完成"与阶段性检查点。
- 删除"think carefully"(仔细思考)这类措辞,因为模型总是先思考。
- 在长时间运行后,询问它还需要什么才能继续。
旧技巧为何失效@dbreunig 指出旧式提示技巧现在与模型的训练相冲突,这是重新支持可编译提示优化(re‑compilable prompt optimization)的论据。
长程引导@omarsar0 强调 Anthropic 用于长程运行的提示,在该提示下模型有时会停下来报告而不是继续推进。
Bug 报告线上模型有时会生成用户轮次(@BlackHC)。
实际写作质量Hamel Husain 通过直播"Is Slop Dead?"(译注:slop 指 AI 生成的粗糙、低质内容)测试了其写作能力(@HamelHusain)。@nptacek 分享了一个个人写作评测的一次性结果。
视觉、3D 与代码作画演示
感知提升Sholto Douglas 表示 5.5 系列在 3D 理解和建模上有"显著的一步提升",模型"现在能看了;之前有点瞎"(@_sholtodouglas,@_sholtodouglas)。
用代码作画@jkeatn 让模型用纯 Python 逐像素生成绘画:
- 约 7,500 行代码,使用标准库模拟笔触。
- 未使用图像模型,也未使用参考图像。
- Sholto 将这种"手动画笔"的创造力与扩散模型进行了对比(@_sholtodouglas)。
Blender 场景Alex Albert 展示了由 claude.ai 上一个提示生成的 Blender 黏土动画(@alexalbert__)。他还构建了一个基于史料的 1906 年旧金山 Market Street:
- 基于 Sanborn 地图(译注:一种详细记录建筑结构与用途的保险测绘地图)、时代影片和档案照片构建。
- 仅使用程序化生成器,未下载任何网格或贴图(@alexalbert__,提示词)。
@karpathy 在此基础上延伸:把历史图像或视频变成可步入的定制 GTA 风格世界。(译注:GTA 即《侠盗猎车手》)
更多演示:
- 一个用代码绘制的 JS 动画(@kevin_t_ngo)以及一条官方探索线程(@claudeai)。
- 一座由代码生成的金门大桥,被评为"在 3D 场景上和 Astra 一样好"(@petergyang)。
- "我测试过的所有模型中最佳的视觉设计"(@other__reality)。
- 一张珊瑚礁壁纸;制作者表示感觉速度约快 3 倍、成本约低 3 倍(@chaseleantj)。
待解之问@teortaxesTex 询问为什么这一代模型如此擅长将函数映射到像素,并推测这与泛化能力有关。
反响:支持、质疑与对比
支持:
- 流水线 bug(pipeline bug):@rishdotblog 表示它发现了 Fable 和 Astra 都漏掉的流水线问题。它还发现了 7 处 SEC 文件错误,包括将 Comfort Systems 的 Q1 营收被错误标记为全年营收的 XBRL(可扩展商业报告语言)问题(@rishdotblog)。
- 回归用户:"Claude 回归了":@Yuchenj_UW 表示在离开一个月后正回归 Claude Code。
- 用量限额:整天高强度使用"几乎没动限额"(@theo)。
- 怀旧:与广受好评的 Opus 4.5 与 4.6 进行对比(@arohan,@kimmonismus)。
- 竞争框架:@scaling01 表示 Anthropic "再次前沿压制"(frontier‑mogging)。@kimmonismus 表示"他们选择了与 OpenAI 开战。"(译注:frontier‑mogging 是"前沿碾压"的圈内说法)
质疑或中立:
- 信任赤字:@kylebrussell 表示不再相信 Opus 发布版能让人用起来更顺。Sholto 回应询问这版能否重置这份信任(@_sholtodouglas)。
- 限额对部分人无所谓:@stablequen 表示反正从来不会触顶。
- 价格成为头条:@dbreunig 询问两家实验室头条卖点都是更便宜的 token,也就是说什么。
- 与 GPT‑6 Sol 的正面对决:
- 支持 Opus 方: @andrew_n_carr 表示 Opus 5.5 "完胜" Sol。@synthwavedd 表示 Sol 低于预期,Anthropic "拿下当日"。
- 反对方: @teortaxesTex 认为 Opus 5.5 的成本和多智能体优势"实际上被 Astra+Sol+Luna 的组合 spam(密集发布)抵消了",因为 Sol 价格仅为 Opus 5.5 的一半(@scaling01)。
- 中立: @kimmonismus 的总结称没有明确赢家:Anthropic 在能力惊喜度上领先,OpenAI 在价格上领先。
@simonw:OpenAI 的 GPT‑6 Sol 和 Luna,为 Codex、Work 与 API 打造的更便宜的 Astra 衍生模型
OpenAI 在数小时内以 GPT‑6 Sol 和 GPT‑6 Luna 作为回应,它们被描述为更快、更便宜的模型,继承了 GPT‑6 Astra 在编程、计算机使用、事实性和对齐方面的诸多进展(@OpenAI,@OpenAIDevs)。定价激进:Sol 为每百万输入/输出 token $2/$10,Luna 为 $0.10/$0.50,分别比其 GPT‑5.6 前代便宜约 50%(@OpenAI)。它们已上线 ChatGPT Work 和 Codex 以及 API,Luna 还在桌面端面向 Free 与 Go 用户开放,但要点是, Chat 模式暂未上线(@OpenAI)。
OpenAI 的比较框架聚焦于成本‑任务比的 Pareto(帕累托)改进,而非绝对的旗舰前沿胜出。其发布的示例声称:在 xhigh effort 下,Sol 在 AutomationBench 上以约 9% 的每任务成本击败 Claude Opus 5 max;而 Luna max 在 OSWorld 2.0 离线任务上以十分之一的成本超越 GPT‑5.6 Sol medium(@reach_vb)。第三方集成迅速推进:Perplexity 将 Sol 设为默认的"Light" effort 编排器(@perplexity_ai);Devin 报告 Sol 以低 61% 的每任务成本匹配 GPT‑5.6 Sol,Luna 以约四分之一的成本超越其前代(@cognition);Arena 为智能体和编程方向测试加入了这两款模型(@arena)。
比 SKU(库存单元)名称更重要的可能是底层基础设施层面的进展。OpenAI 表示改进了缓存与推理效率,开放了缓存输入 token 读取最高 90% 的折扣,以及一个用于理解缓存复用失败的新 Prompt Caching Dashboard 与诊断 API(@OpenAIDevs,@OpenAIDevs)。这对长时间运行的智能体尤为相关,其中由工具切换或推理变化引起的缓存失效(cache invalidation)代价不菲。市场反应喜忧参半:许多人称赞其经济性,尤其是 Luna 的价格下限;而另一些人则觉得 Anthropic 在头条模型质量上获胜,OpenAI 在可负担性与部署便利性上获胜(@kimmonismus,@synthwavedd)。
智能体基础设施、评测工具与基于真实使用的后训练
多篇帖子汇聚到一个日益熟悉的模式:价值正从原始模型访问转移到 harness(脚手架/编排框架)、评测、路由以及基于专有轨迹(trajectory)的后训练。
DigitalOcean Managed Agents 进入公开预览,支持 Claude Code、Codex 和 LangGraph 风格的智能体,并提供空闲时暂停的运行时、受治理的工具端点以及 75+ 模型选择(@digitalocean)。在开发者工作流方面,VS Code Agent Merge 引入了一种实验模式,可在 PR 内自动解决评审意见、失败的检查与合并冲突(@code)。
Perplexity 分享了一份更具体的后训练报告:其 Computer 智能体结合使用拒绝采样微调(rejection‑sampling fine‑tuning)与基于真实用户会话的提示引导自蒸馏(hint‑guided self‑distillation),从成功轨迹与显式的工具调用错误中学习,声称在一次实时 A/B 测试中将工具调用失败率降低 21.2%(@perplexity_ai,@AravSrinivas)。这是一个有用的范例,展示了实验室如何通过生产 trace(轨迹)而非纯合成 RL 环境来落地 sim‑to‑real(仿真到现实)迁移。
评测与可观测性工具也获得关注。Lenny 的 newsletter 突出了来自 Ramp、Shopify、Harvey 与 Cursor 等公司在评测投入上的具体 ROI,并关联了 Hamel Husain 和 Shreya Shankar 关于高级评测系统的续作(@lennysan)。Hamel 还发布了一个旨在自动化评测审计与错误分析环节的 evals skill/plugin(@lennysan)。在可观测性方面,LangSmith 改进了对决策模型(如 Jev/SemIf)的支持,使得在智能体 trace 中更容易检视状态、问题、选择与输出(@hwchase17,@LangChain)。来自多位实践者的元观点:即便模型与提示相同,harness 也能实质性地改变基准结果(@omarsar0)。
开源模型、压缩与在更小硬件上运行更大模型的系统工作
Tim Dettmers 以一个集成进 bitsandbytes2 的运行时动态压缩框架拉开了"开源周"的序幕,目标是在高质量下达到 1.5–2.0 bit 压缩,并承诺"懒压缩"(lazy compression),可在部署时自动寻找更好的内存/质量/速度权衡(@Tim_Dettmers,@Tim_Dettmers)。其定位明确面向试图在受限内存下运行大型开源权重模型的小团队与个人,包括不断增长的 KV 缓存。
硬件与本地部署是另一主题。一篇关于 NVIDIA DGX Spark 的上手文章描述了这台 15×15×5.05 cm、重 1.2 kg 的系统,搭载 GB10 Grace Blackwell、128 GB 统一内存,FP4 稀疏理论算力最高 1 PFLOP(千万亿次浮点运算每秒),NVIDIA 声称支持对最高 200B 参数的模型进行本地推理(配合量化),并可通过 QLoRA(量化低秩适配)等方法对最高 70B 模型进行微调(@kimmonismus)。另据报道,Reka EdgeQ 展示了针对 Qualcomm Hexagon NPU 优化的端侧 VLM(视觉语言模型),TTFT(首 token 生成时间)为 0.73 秒,每次推理 6.9 mWh,GPU 保持空闲以维持持续散热表现(@RekaAILabs)。
在开源模型一侧,出现了若干有分量的发布,而不仅仅是评论。
Step Code v0.1.0 以 MIT 协议发布,封装了一个编码智能体 CLI,据报告在 Terminal‑Bench 2.1 上得分 80.9%,在 Multi‑Frame(150 任务长程基准)上得分 73.3%(@StepFun_ai)。
Ming‑Image‑0.1‑Design,一个 6B 开源权重的图像设计家族,与 UI 设计和图像转可编辑 PPT 的"agent skills"一同发布,声称在 Artificial Analysis UI/UX 设计排行榜上居开源权重模型第一(@AntLingAGI)。一个规模较小但技术上值得注意的预训练成果来自 Rigel,一个 2.3B MoE / 360M 激活参数的 Hybrid Mamba‑2,据报告在 H100/A100/V100 与 TPU v5p/v6e 混合硬件上以同一套代码库训练,使用不到 Llama‑3.2‑3B 1% 的预训练 FLOPs 即达到距其仅几分之差(@MayankMish98)。
多模态模型:图像、视频、语音与世界模型
在图像生成与编辑方面,Qwen‑Image‑2.1 在社区排行榜上表现强劲,在 Image Edit Arena 与 Text‑to‑Image Arena 两个榜单上均位列开源模型第一,排名接近