AI DAILY / 2026-09-23
Engram 实战指南:让智能体真正"记住"该记的事
Agent Memory with Engram: A Practical Guide
全文中文翻译 · AI 生成,仅供学习交流
智能体(Agent)记忆与 Engram:一份实战指南
你装过的每一种工具,都有一个会被你径直点过、连看都不看的引导页。默认值往往出自某个比你花更多心思去思考它的人之手。
Engram 的设置里也有这样一张引导页,过程也就一两分钟:给项目取个名字 → 选个模板 → 把已经预填好的话题(topic)一一点过去 → 生成一个 API key(应用程序接口密钥)。
> Engram 是我们提供的全托管记忆与上下文服务,专门用于帮助智能体(agent)随时记忆、学习并持续改进。
然后,你把原始对话数据喂给 memories.add,在调用模型之前先调一下 memories.search,一切就运转起来了。
而且它会持续运转下去。这才是有意思的地方,因为没有任何东西会再把你拉回那张引导页。但从"能跑"到"按我设想的方式跑起来"之间,有四个决定其实属于你,而不是 Engram:
- 哪些内容被记住(话题描述,topic descriptions)
- 记住多少、属于谁(有界话题与作用域,bounded topics and scope)
- 取回哪些内容(检索模式,retrieval mode)
- 放在哪里(在提示词里的位置)
本文将逐一拆解这四个决定,并给出一个主要跑着默认个性化模板(personalization template)的项目所产生的真实输出作为示例。
Engram 如何把原始数据变成记忆
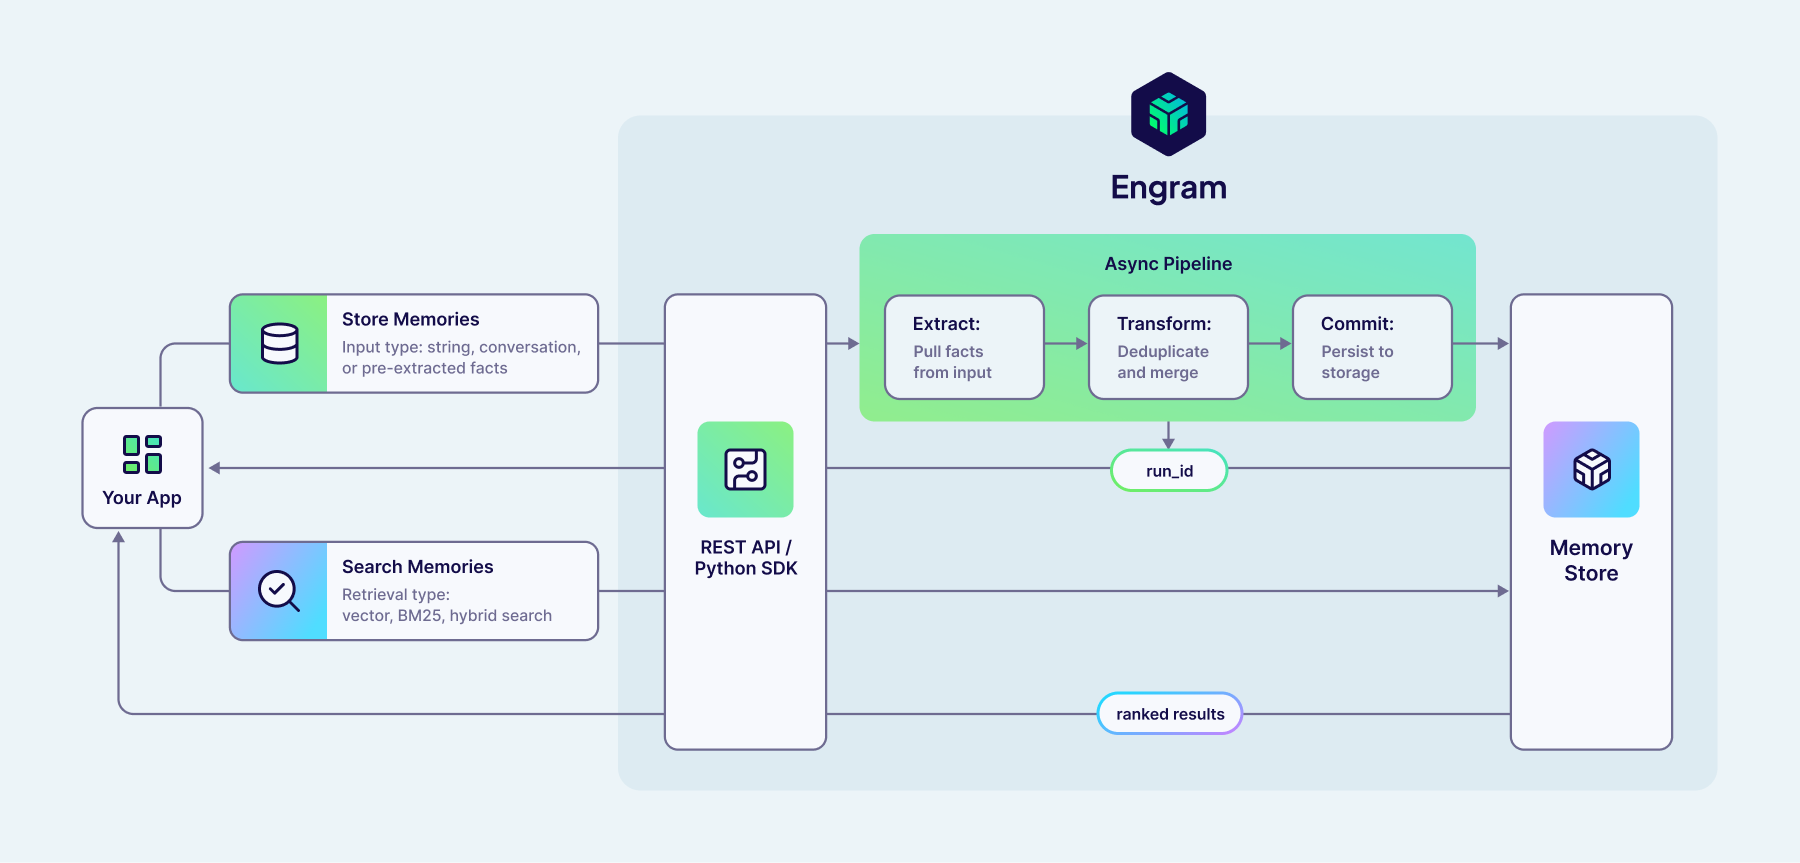
Engram 会在你发来的任何原始数据之上,跑一条异步流水线(pipeline)。默认情况下它会:抽取出有价值的记忆,把它们与已经存储的内容做转换(transform),最后提交(commit)结果。
Victoria 的演示视频完整地覆盖了这条流水线,包括控制台设置和 SDK:memories.add 返回的是一个 run(运行任务),而不是一条记忆;在该 run 完成之前,你发出去的任何东西都不可被检索。Run 状态指南讲解了各种状态,以及为什么通常不应该去阻塞等待它完成。
流水线本身的原理,可以阅读 Engram: Memory by Weaviate 这篇博客,里面一步步讲得清清楚楚。不过,流水线从你发来的数据中究竟抽出哪些记忆,是由话题描述(topic description)决定的,所以我们就从这里讲起。
话题描述如何决定哪些内容会被记住
当你在控制台里新建一个 Engram 项目时,User Personalization 模板会为你创建 UserProfile 和 UserKnowledge,并把 ConversationSummary 作为可选的第三个。我把这三个都选了,然后给项目发了一段关于我自己的介绍:
> "我是 Prajjwal,Weaviate 的一名开发者布道师(developer advocate)。我所有的演示都用 Python 写,并且有一条铁律:演示代码行数永远不超过 100 行。"
三个话题各自回传了一些记忆,总共五条:
[UserProfile]
The user's name is Prajjwal.

[UserKnowledge]
Prajjwal works as a developer advocate at Weaviate.

[UserKnowledge]
Prajjwal writes all his demos in Python.

[UserKnowledge]
Prajjwal enforces a hard rule that his demos stay under 100 lines.

[ConversationSummary]
Prajjwal introduced himself as a developer advocate at Weaviate, mentioned that he writes demos in Python, and follows a rule to keep demos under 100 lines.
> 还有其他开箱即用的项目模板,例如 Coding Assistant 和 Personal Claw Agent。当然,你也可以从空白项目起步,把话题完全定制成你所在领域的样子。
UserKnowledge 把那一句话拆成了三条原子化事实,每一条都可以独立被检索出来。
ConversationSummary 则把它作为一个完整的叙事保留下来。同一份输入、同一条流水线、同一个时刻,得到两种完全不同的形态,原因就在于这两个话题各自的描述写法不一样。
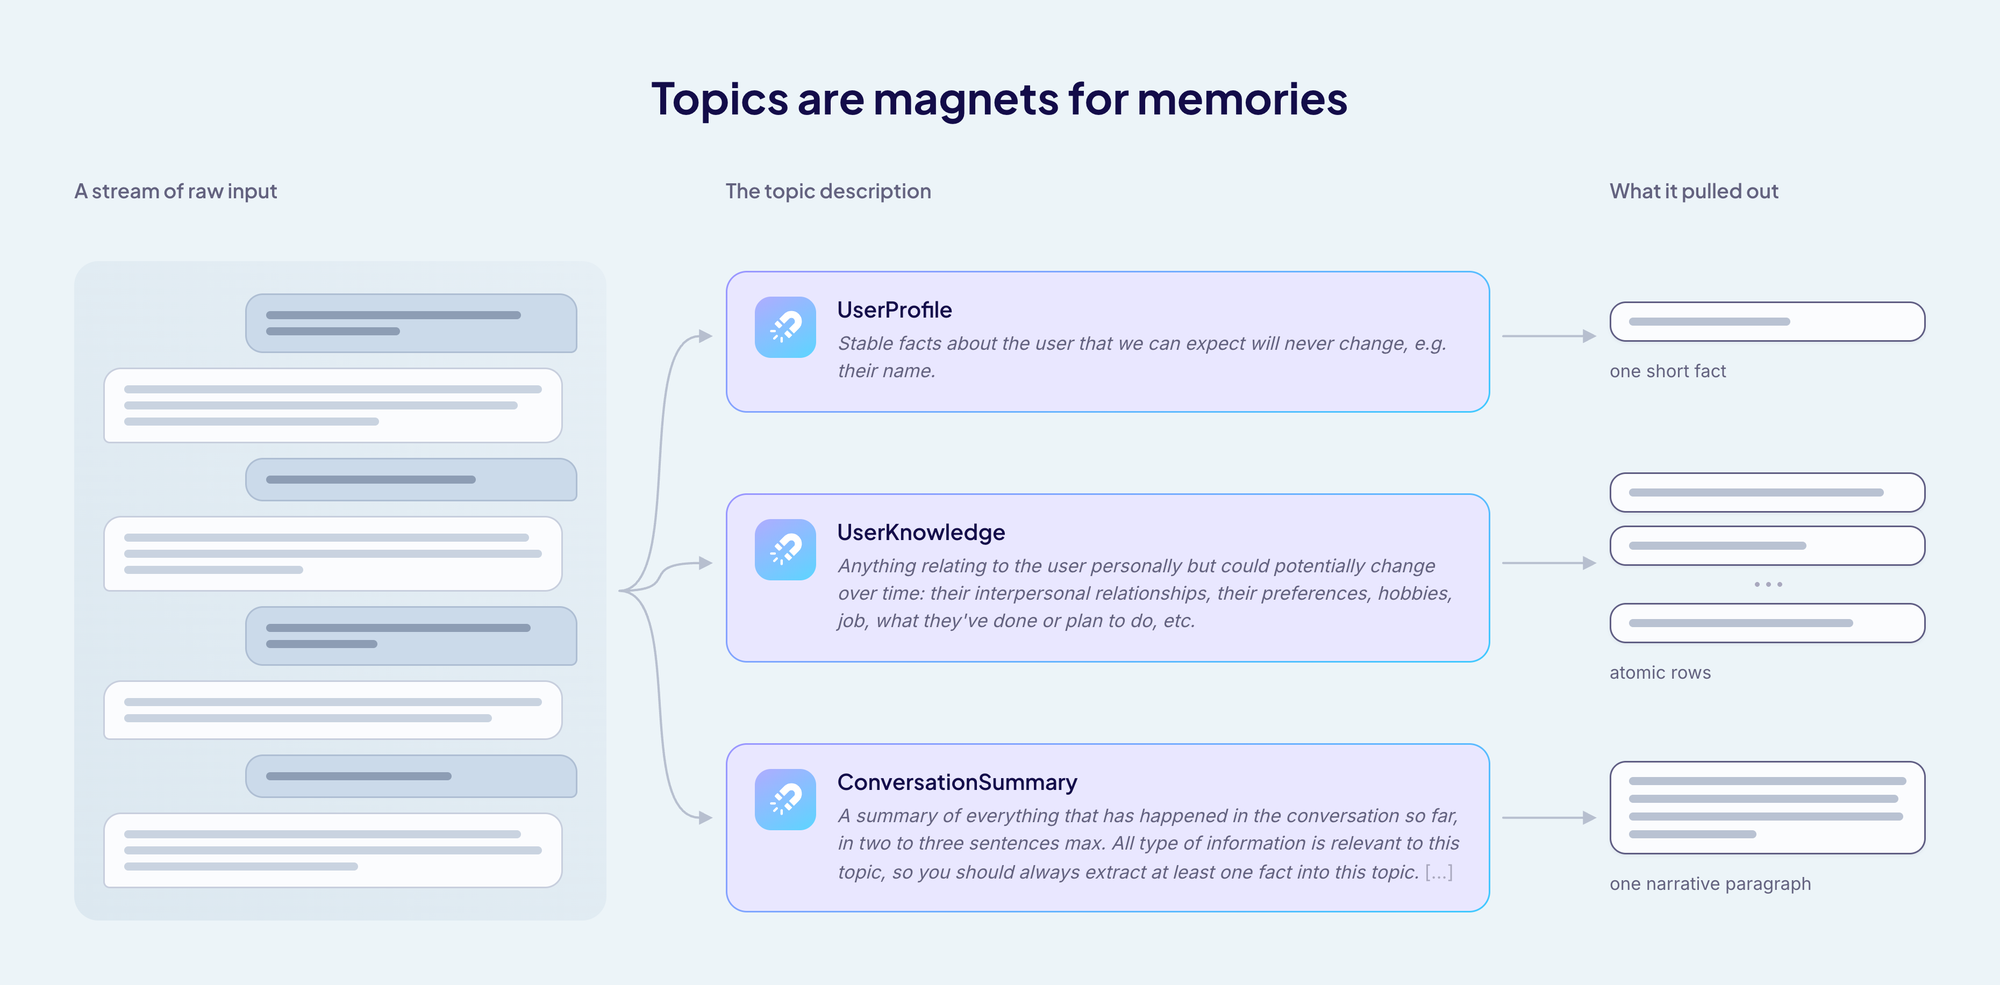
我们并没有写任何路由逻辑,也没有写格式化器。完全靠描述本身完成了这两件事,因为话题描述说到底就是记忆抽取提示词(extraction prompt),它同时控制着三件事:
要排除什么
UserKnowledge 是模板里的兜底话题,凡是关于用户的、可能随时间变化的个人信息都可以往里放。这让"宽覆盖"需求用起来很顺手。但当你想要的是一份聚焦、细分领域的记忆时,描述就不能只说"什么该收进来",还得说清楚"什么不该收进来"。
比如有这么一条随手发的消息:
> "Docker 重建折腾掉两个小时,耳机中途没电,出了门又正好下起了雨。Anyway,我总算把演示切到 qwen3-embedding-8b 了。"
结果回传了四条记忆,其中三条是天气、硬件之类的转瞬即逝的事件。智能体现在已经知道周四下过雨,除非显式调用删除,否则这条事实在数据库里会无限期地待下去。
要修复这个问题,可以用一个聚焦的话题替换掉那个宽泛的话题,只要在描述里明确指出你不想被记住的东西就行。我新建了一个叫 UserFacts 的话题来替换 UserKnowledge,并在描述末尾加了一条新规则:
> "Do not record events, incidents, or passing conditions."
就这一行起了决定性作用,它给模型提供了一条"什么该忽略"的通用判据。我用三条新的消息对它做了测试:晚点的火车、键盘上的猫、被偷的午餐,每一条都搭配了一条真正想留存的决定。跑了 24 次实验,所有噪声类事件都没有被 UserFacts 生成的记忆捕获到,而那些决定则被稳定保留了下来。
所以,对于一个聚焦的话题而言,"该排除什么"的规则比"该包含什么"的清单更有用。指出你想要被忽略的那一类事物,而不是穷举每一个你想到的例子,这条规则就能泛化到你从未预料到的场景上。另外,UserFacts 仅仅是这次实验临时建的,从这里开始,我会切回模板自带的 UserKnowledge。
要以什么形态来写
你几乎一定会把记忆读回提示词里,所以描述里不仅要写"主题是什么",还要写"你要的形式是什么"。比如:
> "Two or three sentences of plain prose, second person, no headings or bullet points"
这样你拿到的内容,可以原封不动地塞进上下文里用。又或者要求返回原子化事实,你就能拿到一行一行的、可以单独检索的条目。
何时值得记住
描述是对一段输入一次性生效的,同时配合流水线为这段输入拉来的相关记忆一起工作。这让它非常擅长在当下就能做出的判断,但对任何依赖过往上下文的事情,它都帮不上忙。
"累积"是一个独立的步骤。默认情况下,流水线按 extract → transform → commit 的顺序串联起来。还有第四种步骤,缓冲(buffer),可以放在流水线中的任意位置。它会把记忆或原始输入先攒住,直到某个触发条件被点亮,触发条件可以是一个计数,也可以是一个计时器。涉及"随时间逐步累积"的规则,应该放在那里,而不是塞在描述的措辞里。
> 默认项目跑的是 extract、transform、commit 三步。增加 buffer,或者对流水线步骤重排序,是按项目配置的,目前仅对企业版(enterprise)开放。
另外,话题在控制台里任何时候都可以编辑,可以增删、修改措辞,不必重建项目。这让你可以反复迭代,直到它们符合预期为止。
其余的配置字段
描述只是一个字段。其余的都是配置项而非措辞,它们各自承担着不同的效果。这是在控制台里新增一个自己定义的话题时你看到的表单:
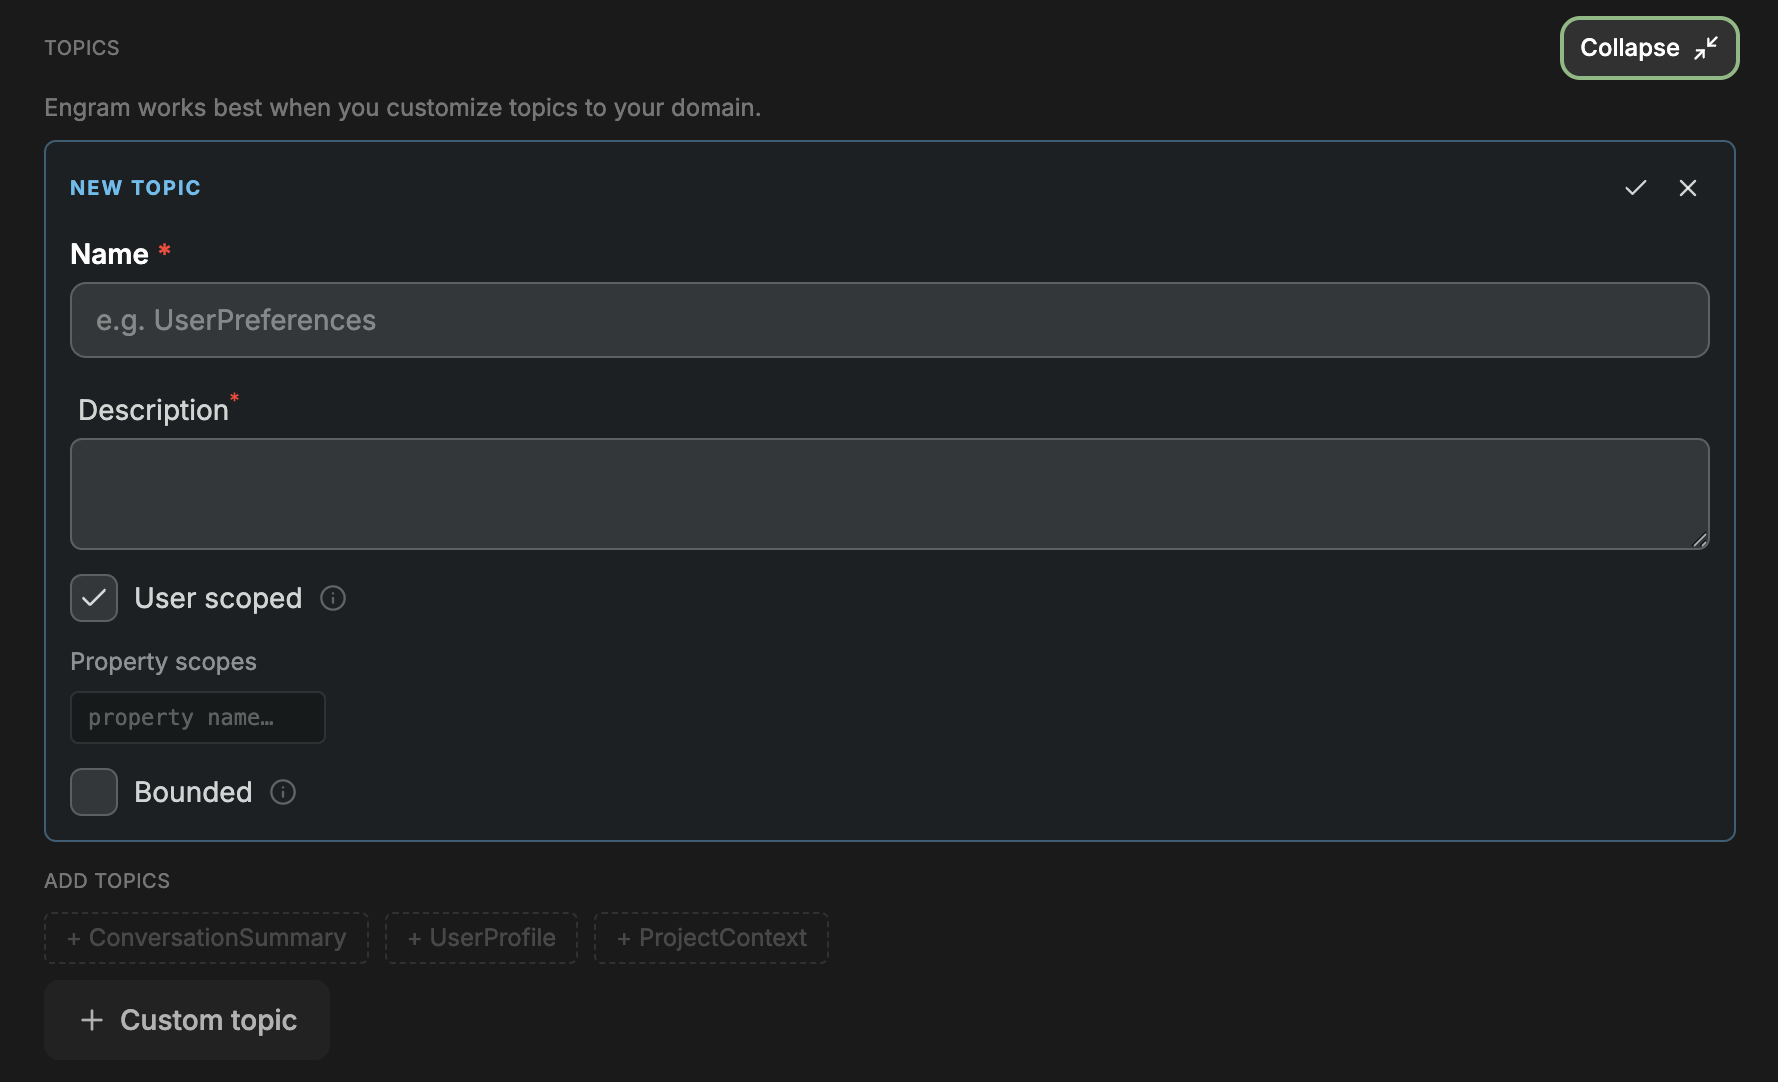
| 字段 | 它决定的事 | 如果配错会怎样 |
|---|---|---|
| Name(名称) | 你在代码里如何指代这个话题,例如 topics=["UserProfile"] | — |
| Description(描述) | 抽取提示词:抽什么、以什么形式写 | 话题要么什么都收,要么什么都收不到 |
| User scoped(按用户作用域) | 记忆属于某个 user_id | 不勾选的话,所有用户共用一个池子 |
| Property scopes(属性作用域) | 额外的分区键,例如 conversation_id 或 repo | 每次写入都必须带上它们,否则什么也到不了这个话题 |
| Bounded(有界) | 每个作用域最多保留一条记忆 | 不勾选的话,无法保证读回来的是单一记忆 |关于这些概念的更详细介绍,可以参考话题相关文档。
有界话题与作用域所保证的事
Bounded 限制了一个话题最多能保留多少条记忆。Scope(作用域)决定了某次读或写请求能触及其中的哪一些。两者都关乎当一条新消息到达时,已经存有记忆的那个话题会发生什么。
接着前面 100 行演示的例子。假设四天之后我发了一条:
> "Update: the demo is 400 lines now. The 100-line rule is officially dead."
新建了 0 条记忆,更新了 2 条。
更新后的 UserKnowledge 记忆:
[UserKnowledge]
Prajjwal works as a developer advocate at Weaviate.

[UserKnowledge]
Prajjwal writes all his demos in Python.

[UserKnowledge]
Prajjwal no longer enforces his previous hard rule of keeping demos under 100 lines; as of 5 Sep 2026 his demos are 400 lines long.
关于"100 行规则"的那条记忆被原地重写,规则本身消失了。剩下两条没动,因为新消息里没有任何东西与它们矛盾。这就是 Engram 流水线中 transform 步骤在发挥作用,不管是不是有界话题,每条记忆都会走这一步。注意删除数是 0,因为调和(reconciliation)通常是用新值覆盖,而不是直接抹除。如果你希望一条记忆显式消失,需要用 memories.delete() 把它删除。
Bounded(有界)
有界(bounded)额外提供的是关于数量的一条承诺。一个有界话题在每个唯一作用域下,至多保留一条记忆。Engram 用话题名和作用域一起衍生出记忆的 ID,因此每一次后续写入都会落到同一个 ID 上、更新那条已有的,而不是新增。
上面那次更新只是单次运行。把介绍消息和更新消息发给五个全新的用户,每个用户都从一个空库开始,看看会落下来多少记忆:
| | run 0 | run 1 | run 2 | run 3 | run 4 |
|---|---|---|---|---|---|
| UserKnowledge (unbounded) | 2 | 4 | 4 | 3 | 3 |
| UserProfile (bounded) | 1 | 1 | 1 | 1 | 1 |无界的 UserKnowledge 落下的记忆数在 2 到 4 之间摇摆,有时那条撤回变成一条记忆,有时变成两条,等等。
而 UserProfile 五次都稳定地只保留一条记忆,因为它是有界的。所以,如果你的代码需要为某个话题读取一条常驻记忆,那就应该把这个话题设为有界,而不是去相信"数量刚好对"。模板之所以给 ConversationSummary 设了有界也是同一个原因:一次会话应该只有一个会被不断重写的滚动摘要,而不是每条消息都生成一个新摘要。
Scope(作用域)
Scope 把一个话题做了分区,一共有两种。User scope 是一道硬墙,每次写入和每次读取都必须带上 user_id。Property scope(比如 conversation_id 或 repo)在写入时是必需的,在读取时是可选的,所以你可以一次只读一个分区,也可以一次把所有分区都读出来。
可选性恰恰是使用 property 的价值所在。模板把 ConversationSummary 按 conversation_id 分区,于是每个会话线程各自保留自己的摘要,而你仍然可以一次性问出某个用户所有的会话摘要。如果两个分区本来就不打算被一起读取,那就别用 property,给它们分不同的 user_id 即可。如果某条事实要跟随用户到处走,就维持在 user scope,不再加任何额外字段。
写入时必须带齐该话题声明的所有 key,否则会被拒绝,例如:
insufficient scope: missing required scope properties [conversation_id] to write memories
insufficient scope: missing required user_id to write memories
invalid scope property: [repo] not configured on any topic (configured properties: [conversation_id])
空字符串也算缺失;写入到一个没有任何话题声明过的属性,会报错并列出项目实际配置的属性。读取时则只强制要求 user_id。空的 conversation_id 会被视作缺省,等同于跨所有会话去搜,尽管同一次写入会被拒;一个从来没有被写入过的 conversation_id,从按会话分区的话题里读取时,自然什么也读不到。
如何把记忆读回来
一共四种检索模式。
vector、bm25 和 hybrid 都是用于搜索(search)的:你给出一个查询,它们给每条记忆打分,然后把得分最高的那几条按排序返回。
如果你不指定的话,默认跑的就是 hybrid;而 fetch 是为直接、无排序地取出记忆设计的。
Search(搜索)
search 按与查询的相关性排序。在聊天应用里,这个查询通常就是用户当前的消息:
from engram import HybridRetrieval

hits = client.memories.search(
    query=user_message,
    retrieval_config=HybridRetrieval(limit=...),
    user_id=uid,
    properties=props,
)

context = "\n".join(f"-{m.content}" for m in hits)
把 limit 设成你真正想塞进提示词里的记忆条数。默认值是 10,不管第 10 条与问题有没有关系,你都会拿到 10 条。要得太多,每一轮都要为不相干的记忆买单;要得太少,智能体就可能漏掉那一条真正关键的事实。
Fetch(取出)
fetch 更像是一个列表操作,而不是搜索:指定话题名,把该话题下的记忆全取回来,不打分排序。
from engram import FetchRetrieval

profile = client.memories.search(
    query="unused",  # fetch ignores this, but the API insists
    retrieval_config=FetchRetrieval(limit=...),
    topics=["UserProfile"],
    user_id=uid,
    properties=props,
)
返回的结果里没有分数,因为本来就不是排序出来的。它很适合用在有界话题上,对有界话题来说,"哪一条记忆"只有一个答案。
Get(按 ID 取)
如果你已经握有某条记忆的 ID,可以用 get 直接把它读回来:
memory = client.memories.get(
    memory_id,
    user_id=uid,
)
所以,从 Engram 读取记忆的正确姿势是:想拿到与查询相关的内容,用 search;想拿到某个话题里所有的记忆,用 fetch;想按 ID 查看某一条具体记忆,用 get。
API 的具体细节可能会变,因此请始终以最新文档中关于"搜索记忆"和"管理记忆"的定义为准。后者还涵盖了删除,删除是不可逆的。
取回的记忆应该放在提示词的哪里
最直觉的做法,是把搜索结果粘贴到系统提示词(system prompt)里,每一轮都检索记忆、重建系统提示词、然后发出去。这在短对话里完全没问题,你也感觉不出任何毛病。
账单要到长会话里才会暴露出来。绝大多数大模型(LLM)服务商都会从前向后缓存提示词:如果一次请求的开头部分和某次之前的请求相同,那么那段公共前缀就可以从缓存里读出,价格只有全价的一小部分。被缓存的部分一直延伸到一个断点(breakpoint)。只要断点之前的任何东西被改动,从那个改动点之后的所有内容都要重新按全价计费。
记忆搜索的结果每轮都可能在变,而当你把它们粘贴到系统提示词里时,它们恰好坐落在所有内容的最前面。于是它们之后的历史几乎永远无法命中缓存,每一轮你都要为整个提示词付全价。
也就是说提示词里其实有两处可以放记忆:
- 断点之前,放那些整轮会话都不会变的文本。
- 断点之后,放那些每轮都会变的文本。
Engram 的两种读法恰好与之对应:fetch 不带查询地返回一个话题的全部内容;search 返回的是与当前消息(或查询)相匹配的内容。
搜索结果放在最后
更好的做法,是把搜索结果挪到提示词的末尾,用户消息之后、单独的某条消息里。到了下一轮,你用新一轮的搜索结果去替换这一整条消息,而不是把两条都留着。把断点放在它前面那条用户消息上。这样一来,系统提示词和完整的历史都能命中缓存,你只需要为新消息和记忆块按全价付费。
断点才是最关键的一环,如果你不主动放置它,服务商会把它放到最后一条消息的末尾,而在这个布局里,最后一条消息恰恰就是记忆块。如果这条记忆块下一轮又变了,前缀就对不上了。在这种情况下,GPT-5.6 系列模型最终只能缓存到系统提示词那一段;而 Claude 系列模型则完全无法命中缓存。
断点要放在哪个字段上,不同服务商也不同:
- 在 GPT-5.6 及之后的模型上,是放在那条用户消息内容块上的 prompt_cache_breakpoint
- 在 Claude 系列模型上,是同一个块上的 cache_control
始终在线(Always-on)的话题放在最前面
有些记忆在每一轮都需要被用到,不管用户在问什么。比如我们内部有一个我搭建的智能体,那里的"始终在线"内容就是用户的个人资料和写作偏好。如果有人说自己写英式英语(British English),或者做了自我介绍,那么本次会话里的每一条回复都应该知道这一点,而不仅仅是搜索恰好命中时的那几条回复。
每轮都去搜它们是浪费,而且还会把一段"从不变"的文本塞进"总是在变"的记忆块里。替代方案是:在会话开始时用 fetch 取一次,把结果放进紧跟在系统提示词之后的一条用户消息里。整个会话期间它都保持不变,从第二轮起它就会一直从缓存里读取。
哪些话题该放前面,取决于它们被重写的频率,而不是它们是不是有界。在我们的例子里,UserProfile 几乎不会变化,所以可以放在最前面。
ConversationSummary 同样是有界的,但它在每一条消息后都会被重写,所以它仍然留在每轮的搜索里。
另外,两次调用里都要显式列出话题,否则同一条记忆可能出现两次。一个普通的搜索可能会把用户资料和其他东西一起返回,所以在我们这个例子里,拆分就成了:
- 会话开始时调用一次 fetch,topics=["UserProfile"]
- 每一轮调用一次 search,topics 设为剩下的那些这样做是要在"新鲜度"上做一点取舍:用户在当前会话里说过的内容反正都在历史里;但如果另一个会话重写了某条被 fetch 的记忆,那么当前会话要等下一次重新打开时才能看到这次更新。
如果整个存储小到足以塞进提示词,你也可以干脆跳过搜索,开头一次性 fetch 全部。缓存下来的 token 在每一轮仍然要计费,所以这条路只有在存储保持相对小的前提下才划算。
下面是支撑本文的测试运行中用到的四种布局,每种各跑 25 轮,基于 gpt-5.6-luna,以及从第二轮起每轮你实际要付费的部分:
| 布局 | 每一轮按全价计费的部分 |
|---|---|
| 搜索得到的记忆粘贴到系统提示词里 | 整段提示词 |
| 搜索得到的记忆放到最后,但不放置断点 | 系统提示词之后的所有内容 |
| 搜索得到的记忆放到最后,断点放在用户消息上 | 新的消息以及记忆块(含始终在线的那些) |
| 始终在线的话题在开头 fetch,搜索结果放在最后 | 只有新消息和搜索结果 |在"始终在线的话题在开头 fetch、搜索结果放在最后"这种布局下,最终一次请求大约是 3,500 个 token,其中只有大约 100 个 token 没有命中缓存。
所以能省下多少,取决于记忆块之前那段有多长,以及会话会跑多久。每当你改动提示词布局时,都务必在自己的技术栈上实测一下效率,并检查缓存命中的 token 数,缓存一旦失效,不会报错,只会体现在账单上涨上。
小结
要修复智能体记忆效果,最快的办法不是写更多应用层代码,而是回头打开你在设置时一路点过的话题,把你真正想保留的东西写清楚,哪些要排除、以什么形态来写、什么压根就不值得记(除非你直接用我们提供的某个模板就能很好地工作)。
然后把那些必须保持唯一的话题设为有界,把需要分区的加上 scope,把 limit 设成你真正想塞进提示词里的记忆条数,把 fetch 的内容放在提示词最前面、把 search 的结果放在末尾。花几分钟在那个配置页上通常就够了!否则你得到的智能体,只会记得你的名字,其他什么也记不住。