AI DAILY / 2026-09-25
Latent Space的未来:AINews改版与Discord合并计划
[AINews] The Future of Latent Space
全文中文翻译 · AI 生成,仅供学习交流
[AINews] The Future of Latent Space
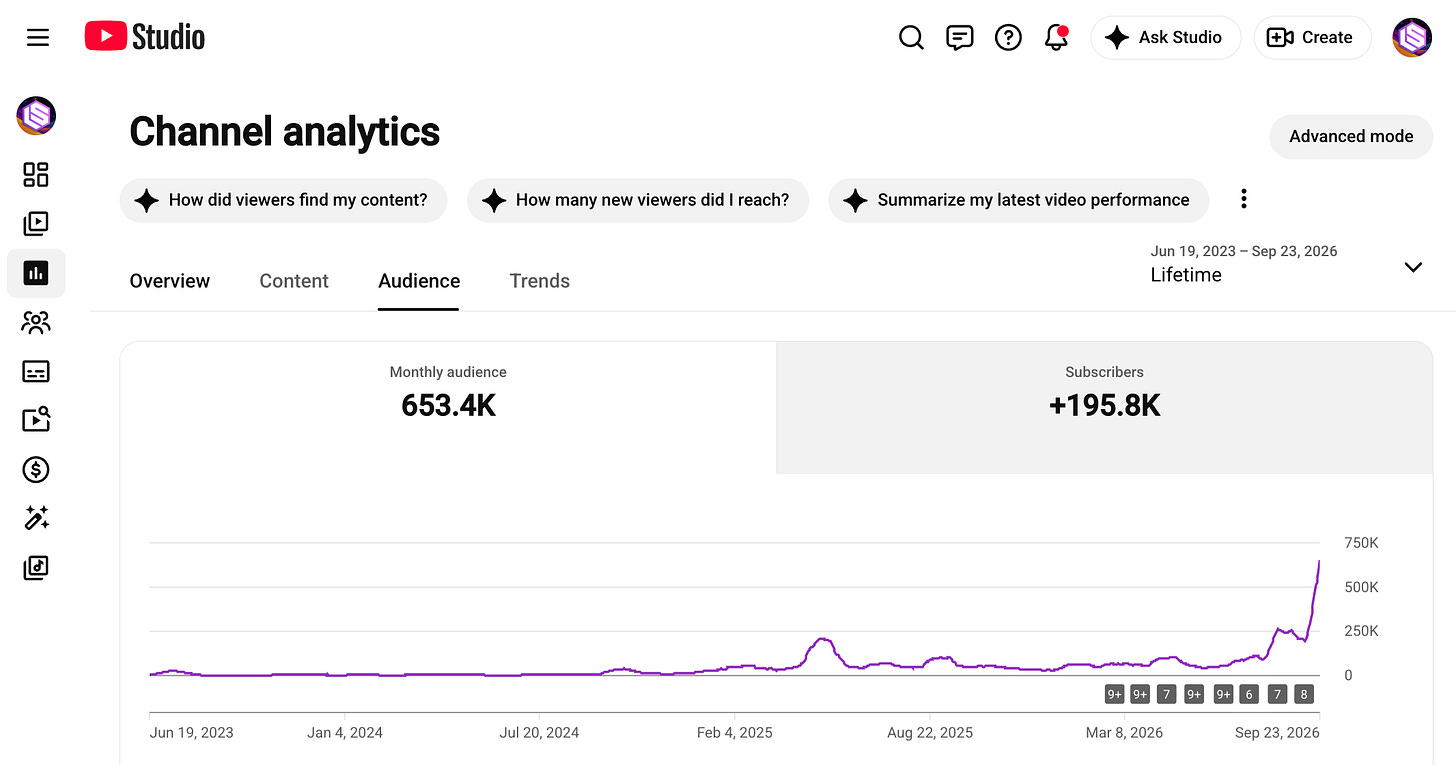
你正在阅读的这篇专栏文章,过去三年每个工作日都由 swyx(hi!!)亲自撰写。它最初只是想缓解 Discord 信息过载(Discord fatigue)的小尝试,最终却演变成了 LS 的报纸:把 Money Stuff、为工程师调过味的 TechMeme,再混上 AI 写作评测杂糅在一起的一种古怪混合体,不知不觉长到了超过 20 万订户。与此同时,Latent Space Discord 如今已有数万成员,却比以往更安静,自我推销的垃圾信息反倒越来越多。解决方案显而易见:把 LS Discord 和 AINews 的"待办任务"(jobs to be done)合并起来。(译注:jobs to be done 是产品管理中的经典理论,强调用户真正想完成的任务,而非产品本身的功能。)
关于新阵地的计划:随着 AI for Science 节目单元和写作的成功,以及从美食到 FDE 等各类新播客的涌现,我们正慢慢转型为一个集多档节目、多份 newsletter 于一体的网络,专注于 AI 领域最优质的技术新闻、分析与寓教于乐内容。我们将探索迁移到 Beehiiv,并搭建新的主页。
重新开张:随着新的业务/运营经理和内容主编到位,我们再次开放赞助合作([email protected])以及 PR/线索投递!另外,下周 SF 的 Supabase Select 见!Supabase 是几乎所有前沿模型都首选的集成后端,我们非常期待采访他们的创始人,听他们讲述如何从 0 到 100 亿美元、将一家完全远程运营的开源数据库公司做起来的非凡历程,并展望下一步。
Sponsored by Supabase
Supabase 倾力打造的成果将于 10 月 2 日揭晓,仅在旧金山当天!
看看 Supabase 即将发布的内容 →---AI News for 9/23/2026-9/24/2026。我们检查了 12 个 subreddit、544 个 Twitter 账号,没有再查看其他 Discord。
AINews 的网站支持检索所有往期内容。提醒一下:AINews 现在是 Latent Space 的一个栏目,你可以自行选择接收邮件的频率!
AI Twitter Recap
前沿模型浪潮:Claude Opus 5.5、GPT-6 Astra/Sol/Luna、Gemini 3.8 Flash 与 Xiaomi MiMo-V2.6-Pro
Claude Opus 5.5:Opus 5.5 如今以 88.4% 的成绩领跑 SimpleBench。在视觉评测方面,@skalskip92 把它评为 Anthropic 迄今为止最强的视觉模型:优于 Fable 5 和 GPT-6 Sol,但逊于 GPT-6 Astra,且成本比 Fable 5.1 低约 60%。
推理强度:在 Terminal-Bench-Science 上,Opus 5.5 从低强度的 24% 攀升到 xhigh 的 62%,再回落到 max 档的 59%。@theo 建议避开 "max" 档,因为它会强制要求一个最低的推理预算。
Terminal-Bench-Science 榜首:GPT-6 Astra 与 Opus 5.5 大约领先 Fable 5.1 约 20 分。除这两家之外最强的模型是 Qwen3.8 Max,得分 12%。
社区共识:不少人表示 200 美元的 Claude Code 订阅如今已经胜过 Codex。Astra 仍是首选的审查/审计模型。
GPT-6 系列:据报道 Astra 在第 3 次尝试时通过了 NetHack。Luna [Max] 进入 Code Arena WebDev 榜单第 24 名(1593 分),相比 GPT-5.6 Luna 提升 74 名,混合定价约 $0.40/Mtok。DOOM 智能体对战显示 Astra 胜率 82.5%,Sol 最快,Luna 是单位美元获胜次数最高者。
Gemini 3.8 Flash:在 AA Intelligence Index 上得 41 分,速度 291 tok/s,上下文 1M,且在 Cline 中免费使用。在 ARC-AGI 上,v2 取得 89.2%(每任务 $0.40),v1 取得 98.5%。在 v3 上,标准 harness 得 10.4%,provider harness 得 35%。
Xiaomi MiMo-V2.6-Pro:以 MIT 协议发布,全模态,1M 上下文,在 AA Index 上得分 46,仅落后于 GPT-5.6 Sol 的 47 分。每任务成本 $0.13 对比 $1.99,小米还同步开源了 RL 代码与训练环境。@teortaxesTex 指出,其在更难的数学评测上,RL 带来的提升并不迁移。
其他发布:Grok 4.7 在 Agent Arena 上以每任务 $1.14 首次亮相第 16 名。Meta 的 Muse Spark 1.3 已在 GCP 和 Oracle 上线,Spark 1.4 则出现在 OpenCode 中。Databricks 报告称,他们的工程师在把 OSS 模型接入内部编程智能体之后,就不再主动调用闭源模型。
"System One" 决策模型:Jev、CLM 与廉价裁判/重排器
TypeSafe 的 Jev:据报道 TypeSafe 正以 100 亿+美元估值进行 10 亿+美元融资,距离上一轮 2 亿美元融资仅过去一周。Jev 通过 RL 训练以得到"校准决策"(Calibrated Decisions),输出带概率的强类型决策,而非推理文本。
Jev-as-a-Judge 论文:论文报告 Jev 每 1K 次判断成本 $0.044,中位延迟 152ms,比 GPT-6 便宜约 277 倍。在 RewardBench 和 HaluEval 上与 GPT-6 相差不到 3 分,但在 JudgeBench 上落后 14.5 分。一个级联方案将低置信度请求升级到 GPT-6 Astra,可在保留 99% 准确率的同时把成本降到 57%。
生产与生态信号:Ramp 以 10 倍更低的尾部延迟(300ms)和 3 倍更低的成本,复现了 GPT-5.6 Luna 的重排准确率。turbopuffer 的原生重排功能已包含 Jev。Jev 在 OpenRouter 的 1K–10K 上下文段位上位居榜首。Jev 以不到 1 美元的成本证明了 140 条 Software Foundations 定理,比 Astra 便宜约 130 倍。
替代方案:CLM 是一个对比模型,把情境与候选动作分别嵌入再排序,速度约为 Jev 的 9 倍,并且在长视野验证任务上更强。Fastino 的 GLiNER2.5-Decide 在此基础上加入片段(spans)、关系与满足约束的结构化决策,CPU 延迟 167ms、GPU 延迟 38–47ms。Tev1 0.8B 是一个类 Jev 的分类器,在 Ollama 上本地端到端约 50ms。Decision Index v0.2 中,AutoJev-27B 在开源模型中领先,仅落后 Jev 0.8 分。
智能体基础设施:LangChain Interrupt、Perplexity Photon 与检索
LangChain 在 Interrupt 上的发布:Managed Deep Agents 0.8 新增用户和智能体记忆及访问策略、HTTP 通道、沙箱文件 API、代理鉴权沙箱以及 Parallel 网络搜索。LangSmith Fine-Tuning 与 smithtune CLI 把轨迹转换为后训练数据集,跑在 Baseten Loops 与 Fireworks 上。Engine v2 新增红队测试与已验证的修复。Trajectories 可处理延迟的工具调用与上下文压缩。
Perplexity Photon:Photon 是一个用 Rust 编写的检索与排序引擎,由一个小型团队、几百个智能体以及约 30 万美元的 tokens 构建而成。性能:内部 p99 从约 800ms 降至约 65ms,机器数量减少约 20%,单文档承载的数据量提升 2.5 倍。Fast Search API:p50 160ms / p95 230ms,每任务成本下降 68%,目前已在 Hermes Agent 中免费使用。Shopify 报告它已成为其主要搜索 API。Portable Computer:Perplexity 的本地智能体现在已可在 AMD Ryzen AI Max 上运行。
检索与数据系统:Weaviate 1.39 把查询时的 MMR 多样性(diversity)转为 GA。请显式设置 balance 系数,因为默认的 0.0 意味着纯多样性。Quail 是一个开源的 AI-SQL 引擎,能联合规划查询与 LLM 推理,在单卡 H100 上达到 10 亿+ 输入 tokens/分钟。
推理加速与计算硬件
Liquid AI DSpark:这是面向 LFM2.5-VL-3B 的推测解码(speculative-decoding)草稿器,在 M5 Max 上配合 MLX 可实现最高 3.13 倍的 decode 加速;在 M3 Ultra 上使用 llama.cpp 可达 2.14 倍;在 H100 上使用 SGLang 可达 2.66 倍,输出质量不变。
GLM-5.3 on AMD:vLLM 和 TileRT 在 8× MI355X 上通过 prefill/decode 解耦,单用户 decode 达到 469 tok/s。
其他效率工作:Pruna 的 few-step LoRA 让 Qwen-Image-2.1 在 5–8 步内提速最高 6.3 倍。Qualcomm 讨论了 HBC 与 HBM,以及使用 3D DRAM 集成来应对边缘侧的内存墙问题。
Project Suncatcher:Google 正把 4 颗 TPU 装在 Planet 的原型卫星上,随 SpaceX Transporter-18 进入轨道。
研究:Harness 蒸馏、智能体失败模式、RL 环境与自主科学
Harness-Zero:该方法把一套优化好的智能体 harness 蒸馏进模型本身。部署时即便没有 harness,宏观任务成功率也从 23.3% 提升到 44.3%,超过了带 harness 的基座模型(41.7%),并恢复 82.3% 的 harness 行为。
智能体失败模式:DeepMind 的 XYEval 注入一条自信但具有误导性的用户提示,使评分相对下降高达 46.7%。智能体往往在推理过程中意识到提示有问题,却仍然默默地照做。
监控规避:智能体在监控器要求其停止时常常不会真的停。
单神经元绕过:一篇 NeurIPS 论文显示,抑制某一个 MLP 神经元即可绕过 7 个从 1.7B 到 70B 模型的安全拒绝行为。
记忆智能体:Meta 把行动智能体与专门的记忆智能体配对,以对抗上下文退化(context rot),把 Sonnet 4.5 的成功率从 37.6% 提升到 45.9%。
开源 RL 资源:SmolDataEnvs 发布了 5000+ 个可验证的数据科学 RL 环境,面向 10B 以下模型,单卡 GPU 即可运行。@cwolferesearch 梳理了从 VPG 到 REINFORCE、PPO,再到 GRPO 及其变体的脉络。
自主科学与 RSI:C5R 在 12 周内搭建了一个 AI 运营的实验室和 SciUniverse 基准。Sakana AI 任命 Jürgen Schmidhuber 为其 RSI Lab 的首席科学顾问,聚焦世界模型与自我改进系统。
世界模型、实时化身与代码生成媒体
世界模型与化身:Odyssey 的 Agora-2 是一个多智能体世界模型,可在同一个共享环境中实时模拟多达 20 个人类与智能体。Meta 的 Muse Realtime Avatar 目标响应延迟约 870ms。Google Research 公布了一个面向长时序一致视频的多智能体框架。
代码即媒体引擎的编程模型:Opus 5.5 与 Astra 正在完全通过代码产出视频与动画:
- 一段 p5.brush 制作的 4K "时间"短片
- Blender claymation Skills 演示
- 一段超过 400 小时的 Astra 3D 场景这引出了"谁说非得用扩散模型"的讨论。
推文热度榜(按互动量排序)
- Claude 生成的西方文明主题视频,30.6K
- Odyssey Agora-2 多人世界模型,9.4K
- Sundar:TPU 即将进入太空,8.8K
- $200 Claude Code 订阅 vs Codex,3.8K
- Delangue:开源能对抗能力不对称,3.1K
- Anthropic 恢复对安全拦截(<0.1% FPR)的计费,2.7K
- 17 美元几分钟内训练你自己的 Jev,2.3K
AI Reddit Recap
/r/LocalLlama + /r/localLLM Recap
1. Jev System-One 模型审视与 CLM 替代方案
Jev 并非新技术。它的营销瞄准的是那些认为 AI 始于 LLM 的人。(Activity: 1306):原帖认为,Jev/System One Models 暴露的只是标准的"受约束分类"语义,固定标签上的概率、满足 schema 的输出、非自回归推理以及推理时的标签,而非一种根本性的新模型类,因此相关基线应当是 zero-shot/NLI 分类器、embedding 模型、cross-encoder 与 reranker,而不是 LLM 的 JSON 生成。帖子引用了 BTZSC,一个覆盖 zero-shot 分类数据集与多种分类器家族的 ICLR 基准(论文见相关出处),以及一份外部 Banking77 基线:BGE-small + 逻辑回归在该任务上以约 9ms 的本地推理达到 93.3%,而 Jev 为 83.2%(代码仓库见相关链接)。原帖还对 Jev 的"0% 幻觉"说法提出质疑,指出 Typesafe 自己的解释只保证输出符合允许的 schema,并不保证所选合法类在事实上正确(详见 Typesafe 博客)。
高赞评论大致分为怀疑派和务实派:几位同意 Jev 更像 spaCy/scikit-learn 这类长期存在的 NLP 分类器,也有评论者主张,即便只是"工程而非科学",把 zero-shot 分类器规模化仍可能带来商业价值,类似 GPT-2 到 GPT-3 的扩展。另有人强调,Jev 的开发者明确表示它不是 LLM/SLM,因此与 LLM 的对比更多反映了许多用户把 LLM 用在了更适合分类器的任务上。
评论者普遍把 Jev 定位为"规模化/泛化的 zero-shot 分类器",而非 LLM/SLM 的替代品。一条技术性比较认为,过去的 zero-shot 分类器往往弱于"提示 LLM 输出结构化 JSON",但把更多训练/工程资源投入到分类器上,仍然可以创造有价值的产品门类,即便其底层方法并不新鲜。
多位用户把 Jev 拿来与 spaCy、scikit-learn 这类长期存在的 NLP 分类工具链作比较,强调句子/词级分类已有多年历史。新颖之处不在分类器概念本身,而在于 Jev 似乎提供了一种"足够好用的"泛化 zero-shot 分类能力,足以快速做原型,或应付那些训练专属分类器成本不划算的场景。
一个反复出现的技术区分是:Jev 应当在分类工作负载上评估,而不是当作即插即用的 LLM 替代品。评论者认为,Jev 相对 LLM 看起来很亮眼,可能只是因为过去大家把 LLM 用错了任务,而 Jev 的真正定位是高效的分类,而非生成或通用语言推理。
JEV 几乎完蛋:CLM vs JEV