AI DAILY / 2026-09-25
铸造厂与导航者:AI如何降低生物科技的研究成本
Foundries vs Navigators: Lowering the Cost of Science
全文中文翻译 · AI 生成,仅供学习交流
Foundries vs Navigators: Lowering the Cost of Science
Guest Post:在科学领域,"想"已经变便宜,"做"却没有。这种不对称正在悄无声息地重塑研究公司的运作方式。
大语言模型(LLM)已经改变了软件的构建方式。写代码、梳理数据、设计架构系统,如今的速度在三年前是不可想象的。当产品本身就是软件、结果可以被验证时,更廉价的编码会直接转化为更多软件和更多开发者。但在科学领域,一切最终都要靠物理实验来把关,而验证任何东西都需要几天到几周时间。围绕实验的知识工作已经大幅加速,而 AI 对实验本身的吞吐量却几乎没有什么帮助。"想"变得便宜了,"做"却没有。
我们认为生物科技行业已经以两种方式适应了这种变化:
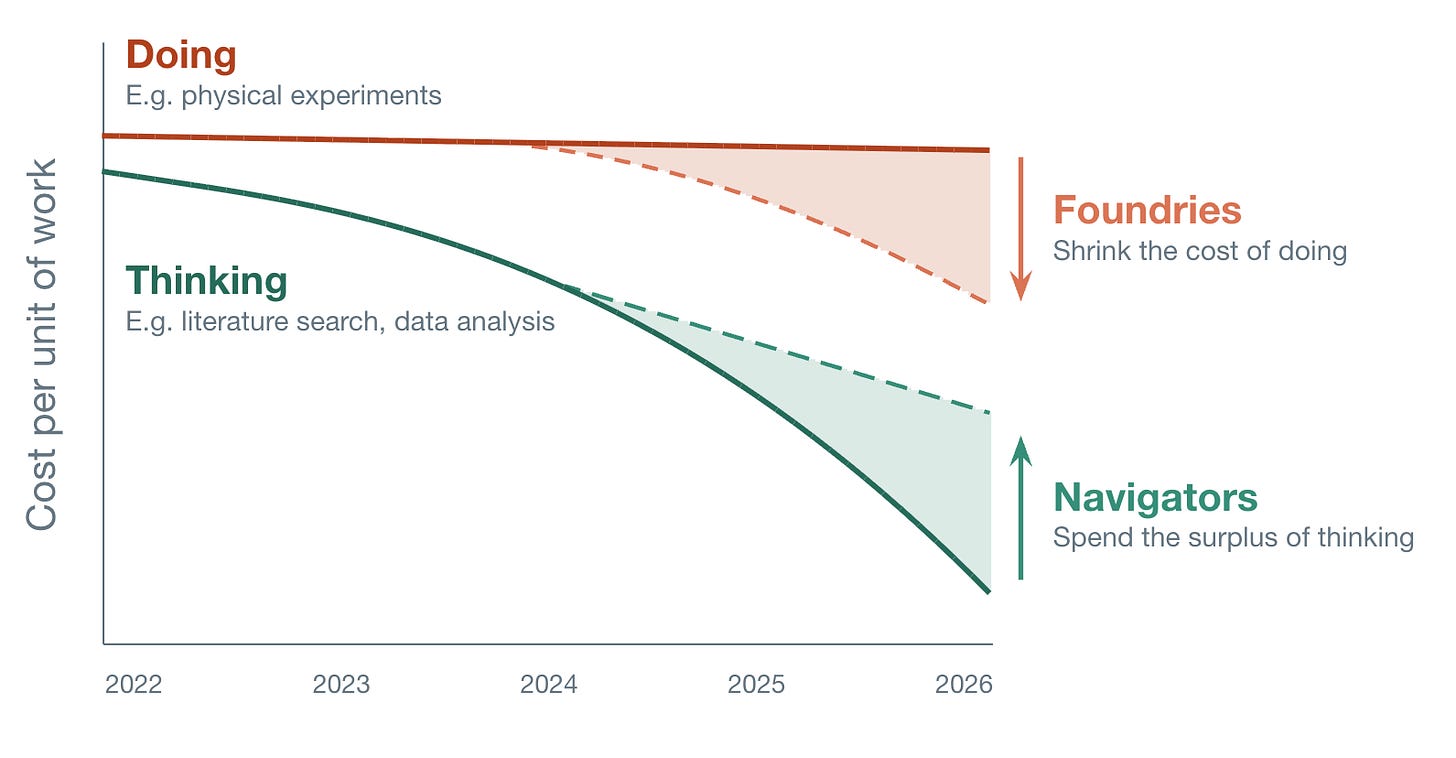
Foundries 压缩了"做"的成本。 他们把测量工业化,借助新技术让数据生成速度提升一个数量级。Xaira、NewLimit、Octant、Tahoe 以及 Endura 用下一代测序(next-generation sequencing)和多重化(multiplexing)做到了这一点;Insitro、Eikon 和 Noetik 用高通量显微镜(high-throughput microscopy)做到了这一点;Lila 和 Periodic Labs 用物理自动化(physical automation)做到了这一点,以上只是列举的几个例子。AI 让数据变得可读且具有预测性,但真正的差异化资产是实验数据本身。
Navigators 花掉"想"富余出来的产能。 AI 模型嵌入了公司的常规运作中,推动更好的决策和更快的流程。它们越来越多地决定工作如何开展、要打造哪些工具,以及哪些问题值得用实验去验证。既不需要专有模型,也不需要海量数据集,只需要愿意去改变公司的运作方式。
打造一家 foundry 是一项真正的战略性投入,需要资本、时间,以及对某项特定技术的押注。Foundries 很容易被看见:技术激发想象力,与 AI 的联系一目了然,而且总会有新模型或新数据集可供发布。相比之下,Navigators 则默默无闻,因为收益体现在运营层面,没有人会对"我们放弃了某条路"发新闻稿。但 navigation 这种做法对每一家公司都敞开大门。显眼的变化发生在几十家公司里,而不起眼的变化则发生在所有公司里。
Navigation 在早期创业公司中跑得最快,因为它们没有需要卸下的历史包袱,没有历史悠久的软件合同、标准化流程、僵化的组织架构,也没有合规制度的束缚。它们同时承受着用极少的资源快速前进的压力。当更好的工作方式出现时,它就直接成为新的常态。
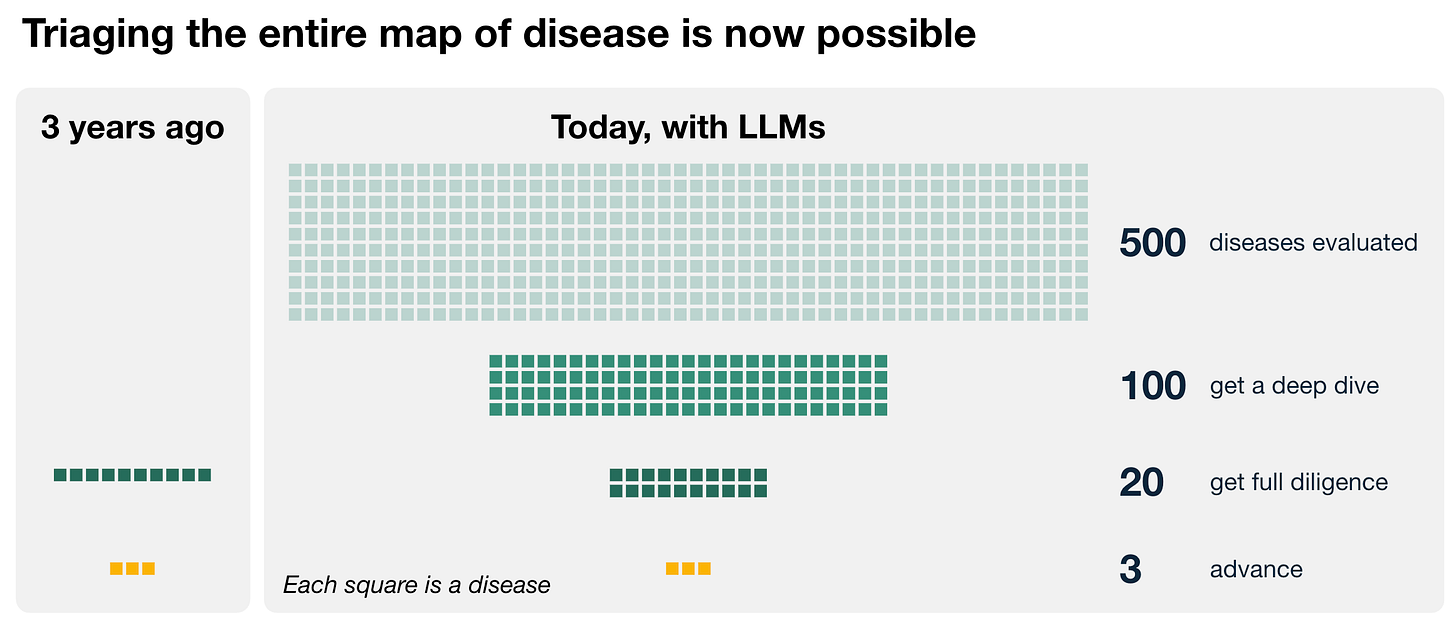
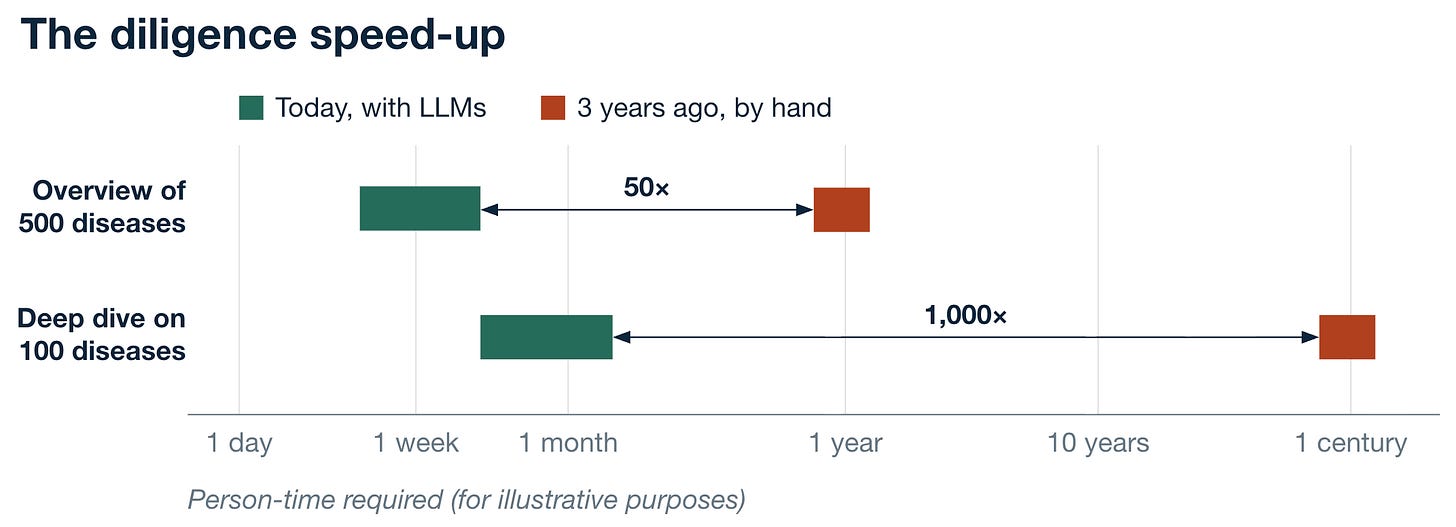
影响随处可见。当分析从一周缩短到一小时,实验迭代就变得更快。一类本需要六位数预算才能买到的软件,现在一天就能搭出来。疾病项目从 500 个候选中筛选出来,而以前一个团队通常只能评估 5 个。下面是从内部看到的实际情况。
Code now keeps pace with the science
在实验科学中存在一种软件工程没有的结构性张力。在软件工程里,需求每隔几周就变一次,是规划不力的表现。但在科研中,这恰恰是目的。实验的目的就是学到东西,而学到的东西又会改变下一个实验应该做什么。如果一个方法六个月都没有演变,那就意味着都没发现。
一个新实验的方案在第一年里会演变十几次,每一次变动都会传导到分析中。每一项测量都需要用紧跟实验的代码进行处理、归一化(normalize)和解读。过去,这部分分析通常由第二个人完成,于是便在"理解实验在测量什么的人"和"理解代码在做什么的人"之间形成了一道缝隙。这种摩擦让人倾向于少提实验改动,以免返工分析,最终累积下来就是大量未被探索的方案。
现在写代码变快了,把分析调整到适配新方案只需要一个下午,而不再是一个项目。实验不再被改动分析管线的负担所限制。当灵活性很廉价、问题很容易修复时,实验也能变得敏捷,也就是说,科学也能"快速行动、打破常规"(译注:move fast and break things 是 Facebook 早期提出的硅谷口号,中文常译为"快速行动,打破常规")。
同样的转变再往上推一层,也适用于解读环节。一个交互式可视化仪表盘,现在几分钟就能搭起来,而过去要花好几天。
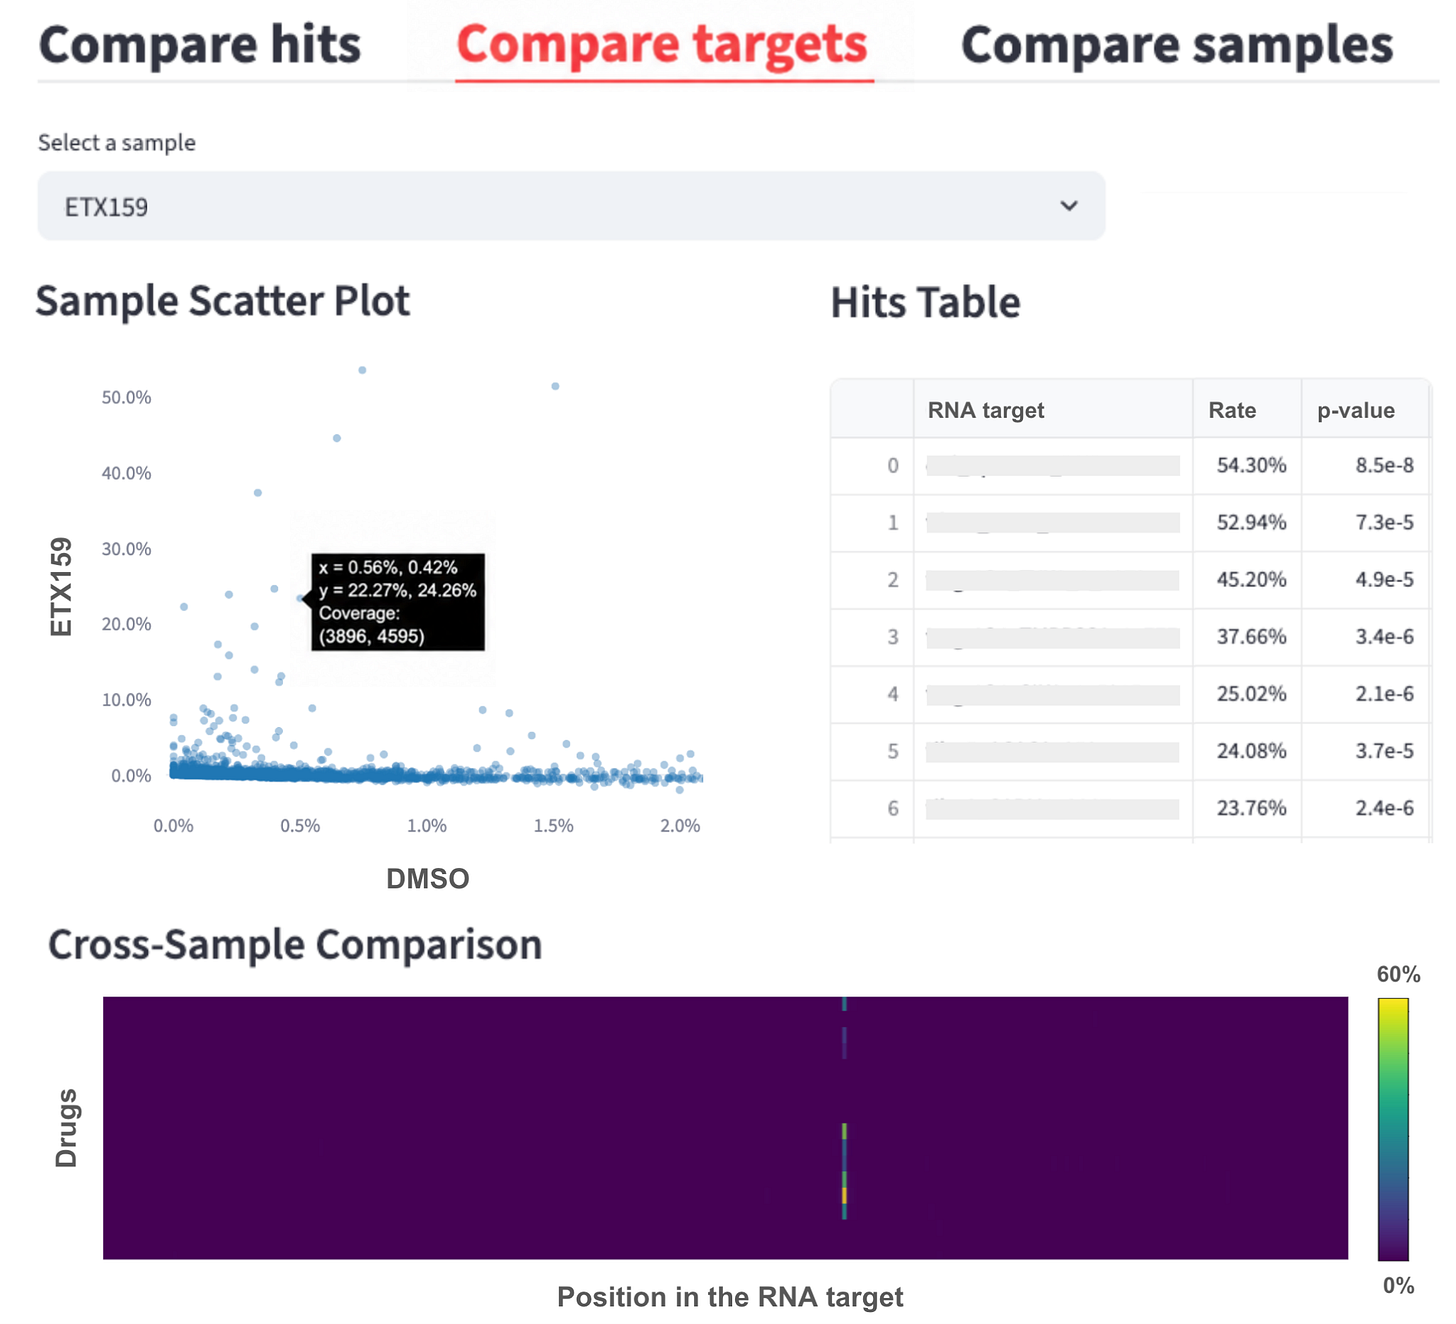
Endura Therapeutics 内部的一个仪表盘,几个小时就搭好了。
最显而易见的结果是"准入"。以前,每次实验都由计算人员来分析,结果就得排队等着。现在,跑实验、掌握上下文的科学家会亲自呈现自己的结果。数据不再被别人的 Python notebook 拦在身后。
Software can now express your opinion
每个软件界面背后都藏着一套观点。一个数据系统决定了哪些比较可以一键完成、哪些需要到处翻找。每个实验室都需要一个地方来存储和展示数据,而这套系统里嵌入的观点,最终会塑造这个实验室会注意到什么。
二十年来,这套观点都是由别人来定的,少数几家供应商提供的实验室软件充当了记录系统。这些供应商为上千家实验室构建一套系统,必然要按最低公约数来设计。大家都接受了这种近似处理,因为自研一套的成本远高于任何实验室能承受的范围。
但现在情况变了。自建的数据门户(data portal)可以照顾到那些商业产品根本预料不到的数据怪癖,复杂度刚好匹配团队需求,并随着问题的演化一同成长。浏览和探索变得简单轻松,行为也随之改变。试想一下,如果刷下一条帖子需要切换标签页、复制粘贴,谁还会把时间花在社交媒体上?原本散落在不同幻灯片里的规律开始浮现出来。
实现只需一天,但决定这个门户该做什么可能需要几周。这些设计讨论反而至关重要,因为决定哪些内容要出现在同一个屏幕上,会迫使团队明确哪些比较才是真正驱动决策的。当你购买一个软件平台时,你外包出去的不只是工程实现,还有"如何达成目标"这件事本身。
这也有取舍:自建门户没那么精致,也没有可以打电话求助的客服团队。更大的组织由于层层审批要求和合同义务,仍然很难效仿这条路。但软件公司早早就明白,最好的内部工具来自与用户并肩工作的工程师。如今每个研究团队都可以成为自己的"前沿部署工程师"(译注:forward-deployed engineer 是 Palantir 等公司提出的概念,指嵌入客户现场交付解决方案的工程师)。
过去的铁律是"能买的就别自己造"。新的铁律是:去打造那些塑造你思维方式(how you think)的工具。
Expert-level depth now scales
选择要攻克哪些疾病,是一家制药公司做出的最重要决策。一切工作都源于这一决策,并围绕特定疾病生物学和市场特点来构建。这个选择实际上是不可逆的,单个成功项目需要约十年时间和十亿美元,因此决策会被仔细尽调(diligence)。典型流程是召集一批内外部专家,花一个多月时间收集、综合并辩论科学和市场证据。
这套流程假定你已经知道要辩论的是哪五个疾病。在我所在的 Endura 公司,我们没有这个候选清单