AI DAILY / 2026-09-25
TypeSafe AI System One决策模型Jev的资源索引
kydlikebtc/awesome-jev
全文中文翻译 · AI 生成,仅供学习交流
kydlikebtc/awesome-jev
是 TypeSafe AI 的决策模型。它不生成文本,你把状态(state)加上类型化的问题(typed questions)交给它,它返回带校准置信度的类型化答案(typed answers),速度快、成本低,足以嵌在智能体的内层循环里。
本仓库按所做出的决策对公开使用案例进行索引。你这周读的那份资料是一次性的;决策模式(decision pattern)才是值得收藏的。
如何评估:每一行都标注了来源。调用点引用(call-site citations)、底层声明与注意事项(caveats)凡是可查的都一并记录,方便你审视读了什么、还有什么未经检验。
> Note 这不是该产品本身,也不是 SDK,与 TypeSafe AI 没有从属关系,亦不构成推荐。收录仅为来源记录,不代表运行时或性能层面的背书。请查看已验证的部分。
Jev 返回什么
三种原语(primitives)。下文的每种模式都由它们组合而成,最后一行中的不对称性是最常见的 bug 来源。
输入仅为文本,字符串、JSON 对象,或文本数组。上下文(context)每请求 64k tokens,其中 32k 留给状态(state)加上最长的那个问题。输出 tokens 免费。没有公开的权重,因此无法在本地运行。完整的跨平台差异:docs/compatibility.md。
从这里开始
按阅读顺序排列的六项内容。手工挑选,因为"star 数最多"不等于"先读这个"。
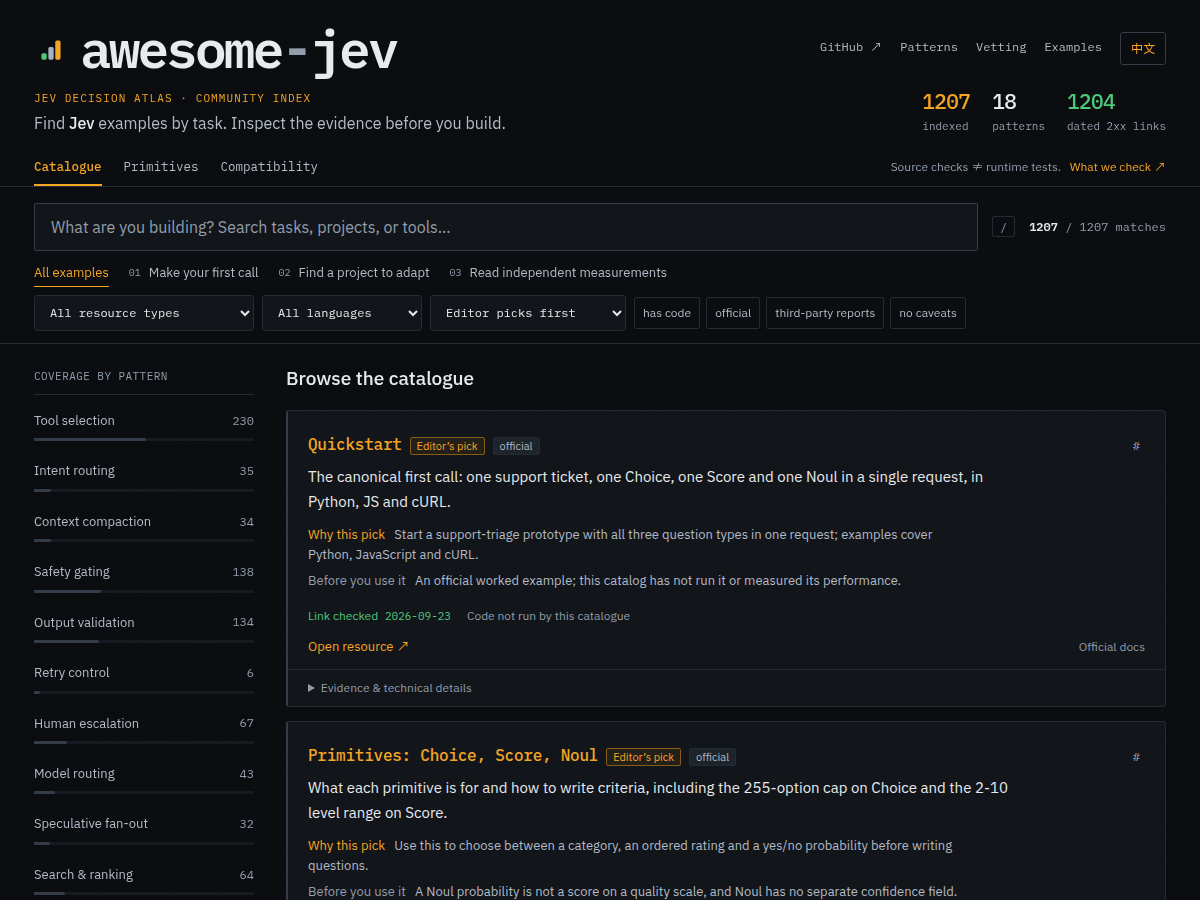
Quickstart(快速上手)规范的首次调用:一个工单、一个 Choice、一个 Score 和一个 Noul 在同一次请求中完成,涵盖 Python、JS 和 cURL 三种调用方式。
Jev 1.13 known limitations(Jev 1.13 已知限制)文档里最有用、却被引用最少的一页。它说明了诸如:一个 Choice 在选项上作答,而每个选项各一个 Noul 则回答不同问题。
Example: three primitives in one request(示例:一次请求中的三种原语)依据官方 API 参考文档逐字段校对所写,但未对线上 API 进行实测。
fast-jev-compaction(快速 Jev 压缩)每次工具调用恰好两个 noul:这次调用是否发生过仍然重要吗,完整输出是否仍需逐字保留?尽管它自己描述里出现了 "scored" 一词,但实际并未使用任何 score 原语。
ai-cookbook: Jev track(AI 实战手册:Jev 专题)迄今最好的结构化教程。它直白地指出,类型化的输出并不保证决策正确,列出了文档化的弱点,并对自身的成本示意做了限定,而非一味兜售。
Hermes Agent: Jev compaction evaluation(Hermes Agent:Jev 压缩评估)本目录中最具可信度的一行。其召回率低于他们既有的摘要器;在上下文预算一致的条件下,与单纯的按时间新近度排序打成平手。成本确实低得多。围绕一个被热炒的模型公开发布负面结论,是很少见的做法。
覆盖范围
每种决策模式,按本目录收录的条目数量排序。借助下方的模式索引跳转到对应章节。零值代表研究空白,而非渲染问题。
全部 18 种模式至少各有一条目录收录。覆盖度并不意味着经过运行时测试或同等成熟度。请参见 docs/status.md。
模式索引 · 跳转到示例
决策模式 · 工具选择(Tool selection)· 意图路由(Intent routing)· 上下文压缩(Context compaction)· 安全门控(Safety gating)· 输出校验(Output validation)· 重试控制(Retry control)· 人工升级(Human escalation)· 模型路由(Model routing)· 推测性扇出(Speculative fan-out)· 搜索与排序(Search & ranking)· 结构化抽取(Structured extraction)· 分类(Classification)· ML 特征抽取(ML feature extraction)· 文档分流(Document triage)· 支持工单分流(Support triage)· 内容打分(Content scoring)· 推荐(Recommendation)· 概览(Overview)
Measured, not claimed
目录中的独立测量报告,包括那些有助于解释方案在何处失效的负面结果。这些都是原作者的测量结果;本仓库未做独立复现。在对比结果之前,请核对每份报告的数据集、方法与模型版本。
Hermes Agent: Jev compaction evaluation
移植了 Jev 压缩方案,与他们正在使用的摘要器做了对照测量,并公开发布了"不予采纳"的结论。
Benchmark · ★248,479 ·Py noul 本目录中最具可信度的一行。其召回率低于他们既有的摘要器;在上下文预算一致的条件下,与单纯的按时间新近度排序打成平手。成本确实低得多。围绕一个被热炒的模型公开发布负面结论,是很少见的做法。
worldmonitor: news threat classification
两个 Choice 问题分别对威胁等级和类别作答,经盲评发现 Jev 仅与在用模型打成平手后,转入影子模式(shadow mode)运行。
Benchmark · ★87,298 ·TS choice Caveats: shadow mode 已接入但刻意保持惰性:按其自身声明,Jev 返回的任何内容都不会触达任何标签、缓存行或告警。配套提供一份黄金固件用例(golden fixture)。这是试用新模型而不押注生产环境的范本。
no-mistakes: Jev review pre-brief, measured and retired
对每个候选文件各发一个 Score,用于代码评审的预简报,经过两轮测量后被移除:计费输入更多却几乎没有带来墙钟时间收益,离线回放显示候选列表在构造上就排除了被修改的文件,而几乎所有评审发现都落在被修改的文件中。
Benchmark · ★8,617 ·Go score 在 PR #1165(2026-09-22)中移除。其离线测量发现,候选生成器在构造上就排除了被修改的文件,而几乎所有评审发现都集中在被修改的文件中;并且逐文件的摘要在更高 token 成本下让列表变得更不精确。代码已从默认分支移除,因此本行引用的是那次移除的变更记录。
hippo-memory
面向 AI 智能体的仿生记忆。遗忘机制、检索强化、记忆整合。零运行时依赖,SQLite,MCP。使用一个可选的 TypeSafe Jev 重排器对检索做了基准测试。
Benchmark · ★756 · kitfunso ·TS 探究 Jev 在重复 API 调用下的行为 一份独立韩语笔记记录了:仅调换选项顺序,就足以让某个概率跨过 0.9 阈值而翻转结果。
Benchmark · ★190 ·Py Caveats: no licence unverified claims 迄今最具工程实操价值的注意事项:如果仅凭选项顺序就能让一个概率越过你的阈值,那么这个阈值并没有看上去那么稳。结论是独立的、未被复现的,所以幅度仅作参考。
jevbench
JevBench v1,一个面向 Jev 类类型化决策模型的基准:智能、便宜、快速、可靠、开源。
Benchmark · ★107 · fstandhartinger ·Py
jev-arena
Jev 入门及动手实验:Choice、Score 和 Noul 将自然语言转为类型化判断,用于分类、打分与路由,并与 DeepSeek 在评论标注、速度和结果上做了对比,支持 CSV 导入、回放与离线报告。
Benchmark · ★97 · nanmicoder ·JS
windtunnel
一个 WebMCP 基准,用于衡量 WebMCP 与其他浏览器智能体接口之间的差异。
Benchmark · ★80 · nekuda-ai ·TS
jev-robot-control
Jev 与两个 LLM 在 xArm7 的 MuJoCo 直角坐标控制上的对比,意图、运动与夹爪控制每步各做一次判断,附带响应、轨迹与回放记录。每个控制器仅在 seed-0 下做一次试验,并非成功率统计。
Benchmark · ★44 · openroboto-ai ·Py
typesafe-ai-benchmark
一个网关,模拟结构化输出的形态,用以对其做基准测试。
Benchmark · ★38 · iammrduncan ·TS
jev-capability-atlas
一份独立、基于证据的地图,标注 TypeSafe 的 Jev 真正成立与失效的边界,基于真实 API 调用凭证(receipts),而非排行榜。以中文为主的双语仓库。
Benchmark · ★26 · zaious ·Py
smartmoney-cub
只读的交易日志与复盘工具:Jev 的类型化判断、智能体集成,以及一份可复现的金融基准。不下订单,不提供建议。
Benchmark · ★26 · myc0576 ·Py
jev-benchmarks
面向类型化决策模型的概率感知评估:校准(calibration)、选择性风险(selective risk)、延迟,以及可复现的基准。
Benchmark · ★17 · abdelstark ·Py
jev-rag-benchmark
用于度量 Jev 在 RAG 中重排序质量、延迟与成本的可复现基准 Benchmark · ★14 · erendikmenn ·Py
pdf-race
Docling → Jev 与 Docling → Gemini 3.8 Flash 与直接读 PDF 的 Gemini:同一批文档,同一只钟表,与 arXiv 自带的元数据对照打分 Benchmark · ★9 · goodrahstar ·JS
jev-dspy-lab
面向 DSPy 工作流中 Jev/TypeSafe 决策的可复现校准与选择性风险基准 Benchmark · ★7 · jmanhype ·Py
jev-rerank-bench
在十四个数据集上,与专用重排器独立一对一对决。
Benchmark · ★7 · anessbelbati ·Py 这是一项独立测量,而非厂商自报数据;同时是与专用重排器的直接对比,这才是搜索排序模式真正该看的比较。
jev-benchmark
TypeSafe 的 Jev(System One)模型的基准与游乐场:国际象棋,以及用于语音转文字游戏 NPC 的"说话者是谁在和谁说话" Benchmark · ★6 · wondertwins ·Py
jev-korean-benchmark
Jev 在韩语理解与医学文本上的可复现早期访问评估,附运行时与成本证据 Benchmark · ★6 · mahlernim ·Py Caveats: no licence
jev-ood-calibration
针对 TypeSafe Jev 在其不可能见过的任务上的独立校准测试:900 条规则生成的支持工单(choice / score / boolean),加上 3 个通过 Vercel AI Gateway 跑过的公开基准。包含原始响应、带噪声下限的 ECE、温度重拟合、每种类型的误校准符号。可复现,代价约 Benchmark · ★6 · scienthoon ·Py
jev-search-rerank-eval
TypeSafe 的 Jev 重排能赢过嵌入检索吗?在 Agent Skills Hub 目录上做的分级相关性评估(9,831 对,164 条中英文查询),并度量了判定器自循环偏差(judge-circularity bias)。
Benchmark · ★6 · zhuyansen ·Py
jev-code-review-benchmark
在 Python 代码评审规则上对比 Jev、Gemini Flash 与 Claude Fable:成本、速度、准确性与一致性。包含结果、图表与可复现实验。
Benchmark · ★5 · gemanor ·Py
jev-little-airways
一份围绕 Jev,TypeSafe 的 System One 决策模型,的能力演示。
Benchmark · ★5 · lbotinelly ·TS
jev-phishing-bench
Jev(TypeSafe)与 Claude Haiku 4.5 在 2000 封钓鱼邮件上的对比:准确率、校准、延迟、成本。可复现的基准。
Benchmark · ★5 · anisselbd ·Py Caveats: no licence
legalforecastbench
LegalForecast-MTD 基准的 alpha 版与官方评估工作流 Benchmark · ★5 · johnhughes3 ·Py
jevarena
面向 Jev 与其他 AI 评判器的开源 BYOK(自带密钥)擂台。寻找失败、比较质量、成本与延迟。
Benchmark · ★4 · chenmingtang830 ·TS
sysone-bench
首次针对 System One 决策模型(Laya 对 Jev)的独立一对一头对头基准,输入在字节级完全一致 Benchmark · ★4 · instax-dutta ·Py
ego-jev-ultrafast
Jev 驱动你的 Ego Lite 浏览器:每步一个 typed-choice 请求。零依赖、单文件的 browser-use/jev-ultrafast 移植版,附带多模型基准与额外防护措施。非官方。
Benchmark · ★3 · shikaizhong-design ·JS
jev-does-not-play-dice
针对 Jev 概率校准、不确定性报告与预测概率保留的实验。
Benchmark · ★3 · kantahayashiai ·JS
jev-exploration
Jev(TypeSafe)的探索性专题:声明审计、实时演示与可运行代码 Benchmark · ★3 · samuelsacco ·Py Caveats: no licence
jev-plays
System One 模型在 Craftax 中游戏,由 LLM 设定目标:五名智能体在同一张地图上,从 Jev 接收原始动作,到 LLM 控制每一步,通过记录的 episode 进行对比。
Benchmark · ★3 · mansicer ·Py
origin-civilization
AI 生命与文明模拟:TypeSafe Jev 做出每一个决策(类型化、概率化、可审计);LLM 负责规划,OpenAI 兼容 API、本地模型(Ollama、LM Studio)、Claude Code、Codex。
Benchmark · ★3 · jacquesgariepy ·TS
typesafe-jev-calibrate-for-code-review
关于为代码评审校准 Jev 的内容 Benchmark · ★3 · selmar ·Py Caveats: no licence
jev-agent-failure-benchmark
在 Who&When Pro 智能体失败归因基准(文本子集)上,对 Jev(Typesafe.ai)与一个强 LLM 进行的基准对比。
Benchmark · ★2 · tokentrim ·Py
jev-play-ping-pong
Jev 实时进行浏览器乒乓球对战:结构化遥测、类型化决策、普通的 Chrome 输入,以及可审计的证据。
Benchmark · ★2 · icohen007 ·JS
jev-routing-experiment
在 RouterArena 上,将 TypeSafe 的 Jev 决策模型作为高性价比 LLM 路由的基准 Benchmark · ★2 · tokentrim ·Py
zerosweep
由 TypeSafe AI(Jev)驱动的自主 System-One 分流引擎与基准。75ms 推理、$0 输出 tokens,以及 RLCD 认识论安全门控。
Benchmark · ★2 · sysadarsh ·TS Caveats: no licence
antigravity-mcp-semantic-search-with-typesafeai
由 TypeSafe System One 驱动的、为 AI 编程助手(Antigravity、Cursor、Claude Code)打造的快速语义代码搜索与 diff 健全性审计器。
Benchmark · ★1 · greenyamao ·Py Caveats: no licence
can-jev-bayes
Jev Bayes,行不行?在贝叶斯最优策略下对 TypeSafe AI 的 Jev 做测试,并检验 Jev 能否有效利用贝叶斯先验。
Benchmark · ★1 · tomrichner ·Py
decision-bench
面向文档接地(document-grounded)决策模型的开放基准运行时 Benchmark · ★1 · hanno-labs ·Py
dsh-jev-verify
Jev(TypeSafe System One)决策工具与 DeepSeek Harness 的实时验证基准:jev_decision(choice/score/noul)与 jev_verify,天然诚实。
Benchmark · ★1 · xienda ·JS
jev-bench
所引来源真的那么说的吗?一份包含 42 项声明的基准:Jev(TypeSafe System One)对阵 GPT-5.4、Claude Sonnet 5 与 Gemini 3.1 Pro。
Benchmark · ★1 · thewaywithin ·Py
jev-benchmark
TypeSafe AI 的 Jev 在智能体工具调用风险分类上的可复现基准:准确率、延迟,以及置信分数是否值得用来路由。
Benchmark · ★1 · themsquared ·Py
jev-decision-benchmarks
JEV 决策基准在 MetaTool、When2Call 与 BFCL V4 上的结果,附双语表格与可复现报告。
Benchmark · ★1 · baibizhe ·Py Caveats: no licence
jev-eval
在你的带标签分类数据上,将 TypeSafe Jev 与任意 OpenRouter 模型对比:准确率、校准、延迟、成本 Benchmark · ★1 · 4esv ·Py Caveats: no licence
jev-lab
面向 TypeSafe Jev(System One 模型)的动手研究实验室:Noul/Choice/Score 原语、置信门控、扇出延迟、智能体控制的可复现基准,以及一份对 Jev 生态持续更新的审计。
Benchmark · ★1 · llt22 ·Py Caveats: no licence
jev-lab
通过 OpenRouter 对 TypeSafe Jev(System One 决策模型)所做的实验:可重复性、扰动分析与 LLM 基线对比 Benchmark · ★1 · danielhirt ·TS Caveats: no licence
jev-secret-detection
度量 TypeSafe 的 RLCD-Jev 模型在文件片段中识别真实密钥的能力 Benchmark · ★1 · teyhouse ·Py Caveats: no licence
jev-sim
兼容 Jev 的 /v1/systemone 服务器,从 LLM 的 logits 中读取类型化决策,并在同一批项目上与 TypeSafe 的 Jev 通过 JevBench 做对照基准 Benchmark · ★1 · dashbi1 ·Py
jevsbistro
面向低延迟决策模型基准测试的 3D 餐厅服务模拟器 Benchmark · ★1 · andrewsilber ·TS
padflow-jev-evals
来自 PadFlow(土地开发 SaaS)的类型化决策基准:模式(schemas)、匿名带标签数据行,以及一个面向置信校准模型(如 TypeSafe Jev)的运行器。
Benchmark · ★1 · zsavage8 ·Py
what-is-jev
围绕 TypeSafe AI 的 Jev(System One)的独立、来源关联的研究:覆盖 947 个按评分量表打分的公开仓库、反复出现的模式、数据集,以及双语文档。
Benchmark · ★1 · g0runmezadam ·Py 关注的是生态本身而非 API 调用方,因此本行不带任何调用点证据。
agent-handoff-gate
面向证据感知(evidence-aware)的智能体交接、有界工作线程续接,以及 TypeSafe/Jev 辅助评审的实验性协议,附带可复现的评估。
Benchmark · ★0 · zsoxi ·Py
jev-acento
¿Jev entiende tu acento?(译注:西班牙语,意为"Jev 听得懂你的口音吗?")针对 TypeSafe AI 的 Jev 在西班牙语上的预注册审计,准确率、校准与 token 成本,并附一个 CLI,用于在你自己的带标签数据上跑同一对比。
Benchmark · ★0 · marcosmartinez ·Py 一项针对英语之外语种的独立、预注册审计,docs/status.md 中所列值得关注的空白。
jev-calibration-audit
面向 TypeSafe AI 的 Jev 决策模型的独立、仅依赖 API 的校准审计 Benchmark · ★0 · jujumilk3 ·Py
jev-certify
面向 Jev(TypeSafe 的 System One)的有限样本保证:保形风险控制(conformal risk control)将已校准概率转化为可认证的路由阈值;预测驱动推断(prediction-powered inference)对其进行审计。在 CLINC150 上 2,412 次决策花费 $0.23,包括那些保证失效的偏移(shift)与流行率(prevalence)情形 Benchmark · ★0 · nikkoxgonzales ·Py
jev-cyrillic-audit
TypeSafe 的 Jev 在俄语上能否保持其准确性与校准?基于平行人工标注数据的独立 RU 与 EN 审计(ECE、可靠性图、配对自举检验)。
Benchmark · ★0 · ahtoooxa ·Py 一项针对英语之外语种的独立校准审计,docs/status.md 中所列值得关注的空白。
jev-enterprise-decision-fabric
通过一条已验证的统一路径运行大量语义决策的架构,附带一个含 111 个案例的带标签基准,用于对比 TypeSafe Jev 与一个 Claude 基线,以及一个用于检视任一单一决策的仪表盘。实验性质,非生产可用。
Benchmark · ★0 · ghubnab99 ·C#
jev-eval
在四组公开分类集上,TypeSafe 的 Jev 对阵 gpt-5.4-mini 与 gpt-5.6-luna:案例、逐项回答、打分与图表 Benchmark · ★0 · onlyoneaman ·TS
jev-eval
在相同条件下,对 Jev 与两个 LLM 进行的第三方核查:为面向游客的日本写真拍摄服务路由预约咨询,60 条合成消息,覆盖四种语言。
Benchmark · ★0 · shogo-nfrealmusic ·TS Caveats: no licence
jev-fanout-bench
实测结果:在同一次调用中向 TypeSafe Jev 提 N 个问题,状态只计费一次。2,976 次真实请求,原始数据,账单逐项核对。
Benchmark · ★0 · blowxian ·Py
jev-lab
面向 TypeSafe 的 Jev 模型的 TypeScript 实验、评估与延迟基准 Benchmark · ★0 · menny1337 ·TS Caveats: no licence
jev-llm-router-benchmark
面向成本敏感、可靠的 LLM 编码工作流的、由基准驱动的 Jev 路由与评判器 Benchmark · ★0 · erendikmenn ·Py
jev-no-enem
在巴西 ENEM 2025 标准化考试上对 TypeSafe AI 的 Jev(System One 范式)的可复现基准。评估类型化决策、领域准确度,以及相对于开源 LLM 基线的 RLCD 不确定性校准,附带交互式 GitHub Pages 仪表盘。
Benchmark · ★0 · patryckalves ·Py Caveats: no licence 一项在英语之外语种、且答案为已知的公开考试上的独立评估。
jev-orderby-bench
对 Jev 概率做 ORDER BY 排序,能让结果行落到站得住脚的顺序吗?对 TypeSafe AI 的 Jev 所做的独立排序、校准与不变量度量:在 360 条带标签数据上通过 6 项预注册门槛中的 6 项,但在分级产品相关性上 6 项中失败 4 项。
Benchmark · ★0 · yodablocks ·Py
jev-playground
在具有明确状态与合法动作的游戏中,将 Jev 与其他评估模型进行基准对比:代码负责规则与状态转移,每个模型选择下一步动作,并对结果进行度量。
Benchmark · ★0 · hegargarcia ·TS Caveats: no licence
jev-trace-classifier
在 collusion.wiki 语料上应用 TypeSafe Jev(noul 判断原语):智能体页 vs 人类页的作者归属,与本地 Qwen3.8-Flash-Next 的一对一对决 Benchmark · ★0 · sypherin ·Py
smoking-extraction-benchmark
对比 TypeSafe Jev 与 OpenAI 结构化输出的合成吸烟史抽取基准,附可复现的准确率、成本与延迟结果。
Benchmark · ★0 · vclic ·Py Caveats: no licence 一项针对 TypeSafe Jev 的早期访问测试:半个美分的校准判断(译注:原文 "calibrated judgments for half a cent",即"用极低成本得到校准过的判断")迄今最好的独立测试:在固定模型版本下,对 24 份挪威语文档进行评估,开篇即展示一个模型答错但正确报告低置信度的案例。
Benchmark · Lindfors 方法阐述清晰,坦诚地将自身限定为单日快照。开篇就亮出失败案例,这让它成为真正的校准测试,而不是一句好评。
Testing TypeSafe Jev, Mistral and Gemini for local event validation
迄今唯一的三方一对一对决,每个模型的提示词分别调优,范围限定在单一任务,而非泛化的整体排名。
Benchmark · Near Here 自我克制得当:是一项用例研究,而非模型排行榜。这种克制比数字本身更难得。
按决策模式
主索引。每个标题都是智能体必须做出的决策;行则是完成该决策的实例。注意事项以短标签形式呈现,每行的完整说明见 catalog.json 与站点。
Tool selection
智能体下一步应该调用哪个工具或动作。
Cookbook: Function calling⭐将自然语言交易请求映射到普通类型化函数,方法是把 fun