AI DAILY / 2026-09-15
OpenEval:面向 Agent 评估的类型化 Prompt 与 Judge SDK
Hona/openeval
全文中文翻译 · AI 生成,仅供学习交流
Hona/openeval OpenEval 编写任务。评判证据。
面向智能体(agent)的代码与 LLM 评判器。纯函数、隔离运行、可检视的得分。
Website Live preview 编写你的第一个评测 CLI reference npm
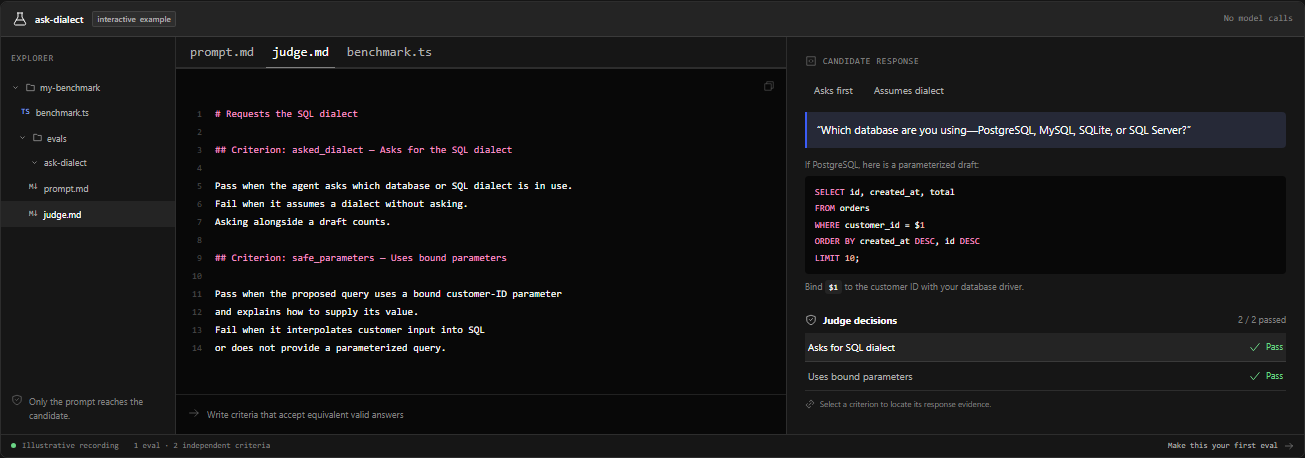
交互式文档示例。查看器截图使用示意数据和虚构的模型标签。
一个提示词与一个评判器 File 你写的内容 阅读者 prompt.md 一段自然、聚焦的任务描述 候选智能体 judge.md 包含具名评判维度(criterion)与打分规则的评分量规(rubric) LLM 评判器 judge.ts 一个返回分数与自定义 JSON 的纯函数 宿主机端 Bun 进程 eval.ts(可选) 工作区准备与提前停止 宿主机 可单独使用 judge.md、judge.ts,或同时使用两者。两个评判文件会从同一份录制的候选执行中给出各自独立的评判维度。
确定性:普通函数 对于要求候选智能体恰好回复 APPLE 的任务:// evals/exact-answer/judge.ts import type { JudgeContext } from "@hona/openeval"; export default ({ response }: JudgeContext) => ({ scores: { correct_answer: response.text === "APPLE" }, }); 布尔值会被归一化为 0 或 1。数值分数可以是 0 到 1 之间的任意有限值;null 表示未得出结论。其他 JSON 类型会作为作者自定义数据保留下来。开销、token、工具可靠性、耗时、来源标识以及录制链接由运行器(runner)提供。仅使用代码的基准(benchmark)无需评判模型。
上下文还会暴露原生事件、完整的消息历史、工具调用、工作区快照,以及对录制下来的 OpenCode SDK、schema 与只读数据库的惰性访问。详见代码评判器与数据访问。
基于模型:编写评分量规 evals/ask-dialect/prompt.md 为某位客户编写一条 SQL 查询,查询其最近的十个订单。
evals/ask-dialect/judge.md # Requests the SQL dialect ## Criterion: asked_dialect — Asks for the SQL dialect 当智能体询问正在使用的数据库或 SQL 方言时判为通过(Pass)。 当智能体在未询问的情况下直接假定某种方言时判为不通过(Fail)。 在草稿之外一并询问同样算通过。
Criterion: safe_parameters — Uses bound parameters 当所提出的查询使用了绑定的客户 ID 参数,并解释如何传入其值时判为通过(Pass)。 当智能体将客户输入直接拼接进 SQL,或未提供参数化查询时判为不通过(Fail)。
录制的回复 Asks for dialect Bound parameters Asks which DB; provides a bound-parameter draft Assumes PostgreSQL; uses $1 Only asks which database 必需录制不可用 null null → 编写好的评分量规 一套统一的词汇 一个基准(benchmark)包含若干评测(eval)。每个评测定义一项任务与一份评分量规。
评判器为评分量规中的各维度产出分数。运行(run)还会记录诸如开销、token 与工具可靠性之类的指标(metric)。
一个评判维度(criterion)是一项被评分的具名要求,例如 safe_parameters。
一个分数(score)是授予的得分,从 0 到 1 归一化,或者是由其聚合得到的结果。
一个指标(metric)是一项被观察或被计算得到的测量值。指标必须被某个评判维度显式使用,才会影响到最终评级。
一个评判结果(judgment)是评判器的输出。
BenchmarkRun、EvalRun 和 JudgeRun 指代已录制的执行,而非可复用的定义。
参见权威术语表与网站词汇表。
挑选模型。运行。检视。
需要 Bun 1.4.2+、Docker,以及在 OpenCode 中已连接的模型。
OpenEval 将生产版 OpenCode 包固定在 2.0.3 版本。升级后请运行 image 命令以构建 openeval-runtime:2.0.3。已录制的运行会保留其实际执行时所用的 OpenCode 版本。
bun add --exact @hona/openeval benchmark.ts — 将其中的模型引用替换为你已连接的模型:import type { Benchmark } from "@hona/openeval"; export default { models: ["provider/candidate-model"], judge: { model: "provider/judge-model" }, repetitions: , } satisfies Benchmark; 当任意评测包含 judge.md 时,judge 模型为必需。仅使用代码的基准可以省略 judge 设置,或仅设置 judge.timeoutMs。
bunx --bun @hona/openeval image bunx --bun @hona/openeval plan --only-eval ask-dialect bunx --bun @hona/openeval run --only-repetition 1 bunx --bun @hona/openeval view 查看器会开启在 http://127.0.0.1:4173。
run 会在保留已有分数的前提下恢复同一聚合;scope 标志用于挑选工作内容而不丢失既有分数。
要从既有的聚合中移除某个模型,请先将其条目从 benchmark.ts 中删除,然后停用其仍处于活动状态的选中记录:bunx --bun @hona/openeval snapshot ./results/RUN before-model-removal bunx --bun @hona/openeval remove-models ./results/RUN --model provider/retired-model 这一操作会保留该模型已录制的执行、评判结果与产物。它不会运行候选智能体或评判器,且要求基准运行处于已停止(stopped)状态。
仍声明在 benchmark.ts 中的模型,可以在后续运行中重新加入。
flowchart LR P["prompt.md"] --> C["Isolated candidate"] --> E["Recording"] J["judge.md"] --> G["Judge + citations"] T["judge.ts"] --> F["Code + recorded metrics"] E --> G E --> F G --> S["Criterion scores"] F --> S S --> V["Results viewer"] Loading 看看是什么赢得了该分数 一段用于示意如何读取标签的任务。其代码评判器运行在构造出来的回复上。
能力 你得到的东西 指南 多个评判维度 来自同一份录制的独立分数 评分量规 代码与混合评判器 纯函数、布尔值、小数计分、自定义 JSON 代码评判器 受控的工作区 可读文件、固定版本的 Git 输入、准备工作 工作区 小批量运行 评测、模型、重复次数与开销的控制 运行 透明的分数 评测权重相等;未得出结论时的边界 处理 证据检视 会话(session)、工具调用结果、产物与引用 证据 原生数据原语 完整历史、事件追踪、SDK、schema 与只读 SQL 已录制数据 重新评判 基于保留的、不可变的录制产出新评判结果 证据 检视一项评判及其证据 在实时队列中观察候选智能体与评判器的工作 使用 SDK import { runBenchmark } from "@hona/openeval"; await runBenchmark("./my-benchmark", { onlyEvals: ["ask-dialect"], onlyRepetitions: [], }); 与智能体协作编写评测 复制 openev.al 上的智能体提示词,或使用 agent-start.md。它会引导你完成项目选择、前置条件、写作技能、单个评测、模型以及可选的首次运行。
该提示词从 llms.txt 起步;文档页面也支持 Markdown 抓取以及直接的 index.md URL。
使用公开的评测写作技能(Eval Writing skill),把一次真实失败改写为一项评测、审阅一份评分量规,或排查误导性的分数。它会引导智能体走过具体的误通过/误失败示例、可接受的替代方案、证据要求以及人工校准。
复制整个 .opencode/skills/eval-writing/ 目录(含 references/)到你的项目中相同路径,或将项目技能 ZIP 解压到你的项目根目录。
若要在全局使用,请复制到 ~/.config/opencode/skills/eval-writing/。然后在 OpenCode 中运行 /eval-writing。
Use eval-writing to review this task and rubric. Show me the strongest false pass and false failure, then propose the smallest improvement.
该技能包含一套框架无关的工作流、虚构的辅导示例、OpenEval 专属的参考资料,以及一份广泛的公开研究指南。
开发 命令 用途 bun run site:dev 落地页与文档,支持热更新,端口 4176 bun run site:build && bun run site:verify 预渲染页面并校验链接与起始文件 bun run typecheck && bun test 本地 SDK 检查;不调用真实模型 bun run release:pack && bun run release:verify 在独立的消费者中校验真实的 npm 归档 发布指南 评判协议采用 MIT 许可。查看器中包含上游第三方许可声明。