AI DAILY / 2026-09-23
AgentJev-0.6B:50毫秒给出校准概率的"系统一"决策模型
malevrigns/agent-jev
全文中文翻译 · AI 生成,仅供学习交流
AgentJev-0.6B 不写文本
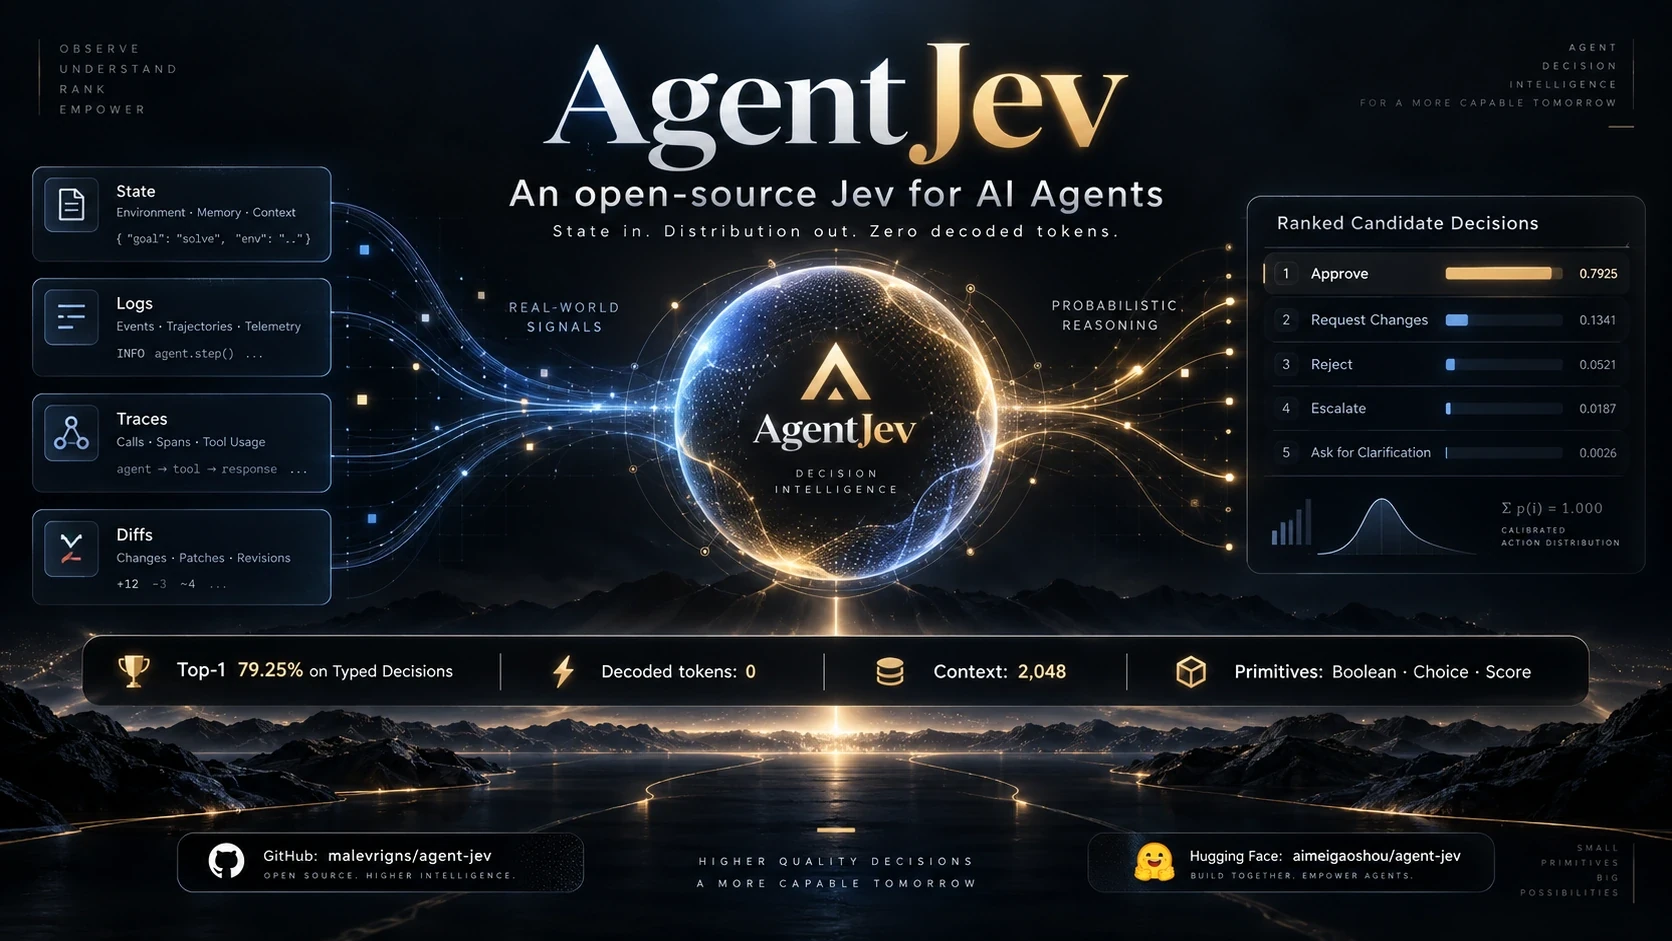
你交给它一个状态(state)和你已经拟好的问题。一次前向传播(forward pass)就为每个候选选项返回一个概率。解码出的 token(模型输出的最小语义单元)数为零。
把它放到 agent 循环中需要把关(gate)、路由(route)或打分(score)的位置。把需要长篇输出的活儿留给更大的模型。
这件活
一个写代码的 agent、一个分流机器人,或一个工作流,它的大多数步骤花在了并不是写作任务的问题上。测试都通过了吗。下一步该用哪个工具。这条命令跑起来安全吗。通常的做法是请一个 27B–70B 的模型一路聊出布尔值,然后再去解析那段话。
| 类型 | 用作开关的写手 | AgentJev |
|---|---|---|
| 输出 | 你希望是 JSON 的文本 | 你给定的选项上的一个分布 |
| 解码 | 一次一个 token | 无 |
| 失败 | 一个结构不合法的对象,或一句自信的话 | 一个你可以设阈值的概率 |
| 放在循环里 | 整轮 | 这一轮之下的反射动作 |状态保持非结构化。问题是带类型的(typed)。答案就是这个分布。
状态可以是一个 diff(一段代码改动)、一段堆栈跟踪、一条工单线索,或一张表格。把它序列化成一个对象,就以稳定的 JSON 发送出去。问题 id 的存在是为了让你能匹配响应。模型是看不到这些 id 的。语义必须落在问题文本和选项文本里。
三种原语
三种形态。每一种返回的都是完整的分布,而不是只返回胜出者。
Boolean(布尔)
问:一个命题
你传入:可选的 true 和 false 的判定标准
你得到:value、true 的概率、两个质量(mass,指分配到该选项上的概率份额)
Choice(选择)
问:在这些选项里选哪一个,必须正好就是这些选项
你传入:2–255 个选项,每个都是一段描述;可以是一个列表或一个映射
你得到:value、top_probability、margin(前两名的差距)、完整的 map
Score(打分)
问:在这条有序的评分量表上处于何处
你传入:2–10 个等级描述,从低到高
你得到:level(argmax,即概率最高的等级)、score = Σ i · Pᵢmargin 是最佳选项与次佳选项之间的差距。Choice 是你所传入集合内部的一种偏好。它并不是"该动作会成功"的独立概率。如果你需要那个概率,请对每个动作单独问一个 boolean,并基于你自己的结果自行校准。
一次前向传播
骨干网络是 Qwen3-0.6B,去掉了语言模型头。每个候选都在其最后一个 token 处读取。一个小型的置换等变(permutation-equivariant)头(head,即附加在骨干网络上的输出层)再对这个集合打分:选项的顺序不会偷偷夹带排序。Softmax(把原始打分归一化为概率分布的函数)在每个问题内部独立进行。
flowchart LR
    state["State"] --> enc["Qwen3-0.6B"]
    questions["Boolean, choice, score"] --> enc
    enc --> head["Candidate head"]
    head --> dist["Distribution"]
加载
三个值得落实而非空喊的特性。
不做任何解码
隐藏状态直接进入 logits(模型输出的未归一化打分)。没有输出词表这一步,因此没有需要修缮的 JSON。
上下文为 2,048 token,超长输入会被拒绝
放不下的 diff 或跟踪信息会报错,而不是悄悄截掉问题或候选。
同一问题的候选之间复用共享前缀
在一种固定的负载下,64 个 Choice 选项加 1 个 boolean,共 66 条路径、33,547 个路径 token,不共享时中位数是 609.65 ms。共享前缀路径是 298.91 ms。最大概率差为 0.000508,且所选选项不变。两种情况下生成的 token 都是 0。这个数字是这种负载、预热后测得的,并非对每条 prompt 的承诺。
状态只编码一次。候选从这个前缀上分叉。
不同问题之间目前还不共享状态缓存。代码中训练侧留了一个树形编码器作为接缝点(seam)。上文测得的服务路径是上面那个共享前缀的运行时,而不是那个接缝点。
Typed Decisions 基准
Typed Decisions 的官方测试集划分:400 个 case(用例),2,000 个问题,一个状态上 5 个问题,4 类工作流。准确率是与公开的教师模型 argmax(概率最大的类别)的一致率。它不是一个被测出来的、写代码 agent 的成功率。
最新的写代码补全检查点(checkpoint,训练过程中保存的模型快照)在代码集上达到 57.8% 准确率和 57.8% 召回率,业务策略(business policy)上 100%,通用 agent 集上 16/16,票据处理上 87.2%。
| 模型 | 类别 | Top-1 | Soft CE ↓ | Brier ↓ | ECE ↓ | Score MAE ↓ |
|---|---|---|---|---|---|---|
| AgentJev-0.6B,本次 | 专用 | 79.25% · 1585/2000 | 0.8494 | 0.0448 | 0.1687 | 0.2096 |
| Laya,公开检查点 | 专用 | 77.00% · 1540/2000 | 0.8844 | 0.0615 | 0.2170 | 0.2423 |
| TypeSafe Jev 1.13.0 | 通用,零样本 | 72.7% | — | 0.148 | 0.144 | 0.391 |
| ModernBERT-base,149M | 专用 | 64.6% | — | 0.119 | 0.179 | 0.444 |
| MiniLM-L6,22M | 专用 | 58.7% | — | 0.143 | 0.108 | 0.515 |
| AgentJev 第 4 阶段,本次之前 | 专用 | 38.70% · 774/2000 | 1.2817 | 0.2577 | 0.1050 | 0.7062 |
| Prior,按标签频率 | 参考 | 47.0% | — | 0.189 | 0.088 | — |
| Uniform(均匀分布) | 参考 | 30.8% | — | 0.238 | 0.169 | — |没有 Soft CE 数字的行是从数据集说明卡里抄来的。它们没有在这个仓库里重跑过,而且那张说明卡并没有公布软交叉熵(soft cross-entropy)。这些行的 Brier(一种衡量概率预测准确度的损失)、ECE(Expected Calibration Error,期望校准误差)和 Score MAE 用的是说明卡里的定义。
在这个划分上对比 Laya,准确率差距是 +2.25 个百分点。对 400 个 case 做 case 级自助重采样(bootstrap),得到 95% 区间 [+0.65, +3.90]。
对比本次启动所用的第 4 阶段权重,差距是 +40.55 个百分点,区间 [+37.35, +43.50]。
按工作流看
每类 500 个问题。AgentJev 是校准过的检查点。Laya 与上表里同一份公开的专用检查点相同。
| 工作流 | AgentJev | Laya |
|---|---|---|
| 票据处理 | 86.20% | 81.20% |
| 客服 | 82.20% | 76.40% |
| 安全事件 | 76.80% | 77.60% |
| Agent trace 可观测性 | 71.80% | 72.80% |
按原语看
| 原语 | 问题数 | Top-1 | Soft CE |
|---|---|---|---|
| Boolean | — | 88.83% | 0.4935 |
| Choice | — | 75.33% | 0.9767 |
| Score | — | 75.00% | 1.0209 |
表格阅读须知
专用和通用不是同一种度量方式。数据集说明卡上就这么说,表格里也做了标记。Jev 1.13.0 是对这些 schema(输入/输出的字段结构定义)做零样本回答。AgentJev、Laya、ModernBERT 和 MiniLM 是在该基准上专门训练过的。
Laya 的公开检查点是在全部 1,200 个官方训练 case 上训练的。本次留出了 120 个开发 case 和 120 个校准 case,并在测试划分打开之前,按开发集软交叉熵选出了第 600 步的检查点。温度(temperature,用于在 softmax 前缩放 logits 的标量)每个原语一个正标量,仅在校准 case 上拟合。损失是软交叉熵加上 0.1 倍的"候选和 Brier"。Seed。数据集版本 ea9306458d6e9563628369a3d1e72e362fb381d2。
目标是教师模型的分布,包括合成 case。在某一行上胜出,并不意味着有 pull request 被合并、有事件被处置、或有票据被支付。
完整数字见 typed_decisions/comparison.json、typed_decisions/protocol.json、typed_decisions/REPORT_zh.md。
延迟与吞吐
跟 Laya 的取舍很清晰:Laya 在单个短问题上更小更快;AgentJev 在候选集很宽的场景下才能把规模优势发挥出来。
| 负载 | Laya(421M,ModernBERT) | AgentJev(598M,Qwen3) | 差异 |
|---|---|---|---|
| P50 case 延迟(1 个状态上 5 个问题,测试划分) | 41.53 ms | ~60–70 ms | Laya 在短输入上快约 20 ms;其编码器少了 1.77 亿参数 |
| P90 case 延迟(1 个状态上 5 个问题) | 47.14 ms | ~85 ms | 两者都在交互式响应预算之内 |
| 宽候选负载(64 Choice + 1 Boolean,33k token) | ~500–600 ms(重复前向) | 298.91 ms(共享前缀) | AgentJev 通过 KV(键值缓存)前缀复用提速约 2 倍 |
| 上下文上限 | 1,024 token | 2,048 token | Laya 在 1,024 以上会截断或拒绝;AgentJev 能容纳两倍的状态 |Laya 的 ModernBERT 骨干网络没有因果前缀接缝点:一个 64 选项问题里的每个候选都需要对状态文本做一次完整的前向传播。AgentJev 把 prompt 前缀 token 缓存一次,然后让所有候选分支共用这一份 KV 上下文,把冗余的骨干网络 token 操作从 33,547 降到 2,551(减少 92.4%)。
运行
权重是 safetensors(一种高效的模型权重序列化格式)的 state_dict(模型的参数字典),位于 huggingface.co/aimeigaoshou/agent-jev 上。这个 git 仓库里是代码。服务进程想要的是一个 torch 检查点,所以请把文件包一层。
git clone https://github.com/malevrigns/agent-jev.git
cd agent-jev
python -m venv .venv
pip install -r requirements.txt
pip install huggingface_hub safetensors
from huggingface_hub import hf_hub_download
from safetensors.torch import load_file
import torch
src = hf_hub_download(
"aimeigaoshou/agent-jev",
"model.safetensors",
)
torch.save(
{"state_dict": load_file(src)},
"agentjev_v1.pt",
)
hf_hub_download(
"aimeigaoshou/agent-jev",
"temperatures.json",
local_dir=".",
)python -m jev_service.server \
--checkpoint agentjev_v1.pt \
--model-path Qwen/Qwen3-0.6B \
--temperatures temperatures.json \
--port 8149model.safetensors 是完整模块,骨干网络加候选头。它不是一个因果语言模型,AutoModelForCausalLM 加载不了它。
AgentJevModel 先搭出 Qwen3 的骨架,然后用 load_state_dict(..., strict=True) 替换掉。加载时请使用 dtype=torch.bfloat16。这些张量就是 bf16(brain float 16,一种 16 位浮点格式)。
进程只绑定 127.0.0.1。工作台在 http://127.0.0.1:8149/。
GET /health 和 GET /api/info 返回已加载的检查点。上表所选的那个基准检查点是第 600 步。这些已发布的张量就是那次训练的产物。
--temperatures 接收在留出的校准 case 上拟合出的标量。
--page 切换工作台的 HTML。
--device 默认为 cuda:0。
--max-tokens 默认为 2048。
客户端
agentjev_client.py 与上述服务进程通信。除了标准库以外没有额外依赖。
from agentjev_client import AgentJev

jev = AgentJev("http://127.0.0.1:8149")

state = {
    "task": "Fix NullPointerException in UserAuthService.verifyToken",
    "test_output": "Tests run: 14, Failures: 1 — test_expired_token",
}

gate = jev.decide_boolean(
    state,
    "Have all tests passed?",
    criteria={
        "true": "The suite is green and the project builds.",
        "false": "Any test is still failing.",
    },
)

route = jev.decide_choice(
    state,
    "What should the agent do next?",
    options={
        "read_failed_test": "Open test_expired_token and read the assertion.",
        "rewrite_file": "Ask a larger model to rewrite the service.",
        "commit": "Commit the current diff anyway.",
        "retry": "Rerun the suite without changing the code.",
    },
)

risk = jev.score(
    state,
    "How much operational risk does this change carry?",
    levels=[
        "Isolated change, no external behavior.",
        "A unit assertion moved.",
        "A public signature changed.",
        "Authentication behavior may be bypassed.",
    ],
)
gate 带回 decision、prob_true、prob_false、confidence、wall_ms。
route 带回 best_action、probability、margin、distribution。
risk 带回 level 和 expected_score。
evaluate(state, questions) 是底层调用,用于一个状态在同一次请求里需要多个问题的情形。多个状态放在 HTTP body 的 requests 字段里,最多 32 个。
脚本
这些脚本假定服务进程已经在 8149 端口监听:
python run_practical_test.py
python test_coding_scenarios.py
python test_game_suite.py
前两个走的是软件工程场景。第三个走的是客服、迷宫、贪吃蛇和类似 ViZDoom 形式的决策。它们是针对在线服务进程的演示,不是离线单元测试套件。
HTTP
POST /api/evaluate请求:
{
  "state": "23 tests passed, 1 failed.",
  "questions": [
    {
      "id": "done",
      "type": "boolean",
      "question": "Are all tests passing?",
      "criteria": {
        "true": "The suite is green.",
        "false": "At least one test failed."
      }
    },
    {
      "id": "next",
      "type": "choice",
      "question": "What is the useful next action?",
      "options": {
        "debug_failure": "Read the failing assertion.",
        "submit_patch": "Open a pull request now."
      }
    }
  ]
}
响应:
{
  "api_version": "agentjev.decision.v1",
  "results": [
    {
      "id": "",
      "answers": [
        {
          "id": "done",
          "type": "boolean",
          "probability": 0.08,
          "value": false,
          "distribution": {"true": 0.08, "false": 0.92}
        },
        {
          "id": "next",
          "type": "choice",
          "value": "debug_failure",
          "top_probability": 0.87,
          "margin": 0.74,
          "distribution": {"debug_failure": 0.87, "submit_patch": 0.13}
        }
      ]
    }
  ],
  "usage": {"generated_tokens": 0}
}
上面的概率仅用来示意形状。Score 类型的答案还会附加 score、level 和 legend。批处理请用 {"requests": [{"id", "state", "questions"}, ...]}。单次调用的限制:32 个状态、128 个问题、1,024 条候选路径,body 大小在 1 到 1,000,000 字节之间。同一问题内的候选描述必须互不相同。
工具前端的把关
agentjev_hook.py 是一个 Claude Code PreToolUse(工具调用前)命令钩子(hook),作用于 Bash、Write 和 Edit。它把工具的载荷(payload)发到 http://127.0.0.1:8149/api/evaluate,问一个 boolean 和一个四档 score,然后打印一个决策。
它只在 score 为第 3 档、且 boolean 说该动作不安全时阻塞。如果服务进程没有响应,钩子以退出码 0 退出,工具继续执行。把钩子指向上述脚本,并让服务进程保持在 8149 端口。端点地址在文件里是固定的。
这个钩子判断的是"该不该调用这个工具"。它并不会取代写出补丁的 agent。
assets/decision_arena.html 是一个可以直接在浏览器里打开的静态对战页面。在 8149 端口上跑出来的那张页面就是活的工作台,与已加载的检查点绑定。
哪些数据被留出了
训练 case 与 400 个测试 case 按 case id 划分。一个 case 的所有问题都落在同一个划分里。因子(factor)、gold label(人工标注的标准答案)和 case id 都不作为模型输入。测试划分没有被用来挑选检查点或温度。